
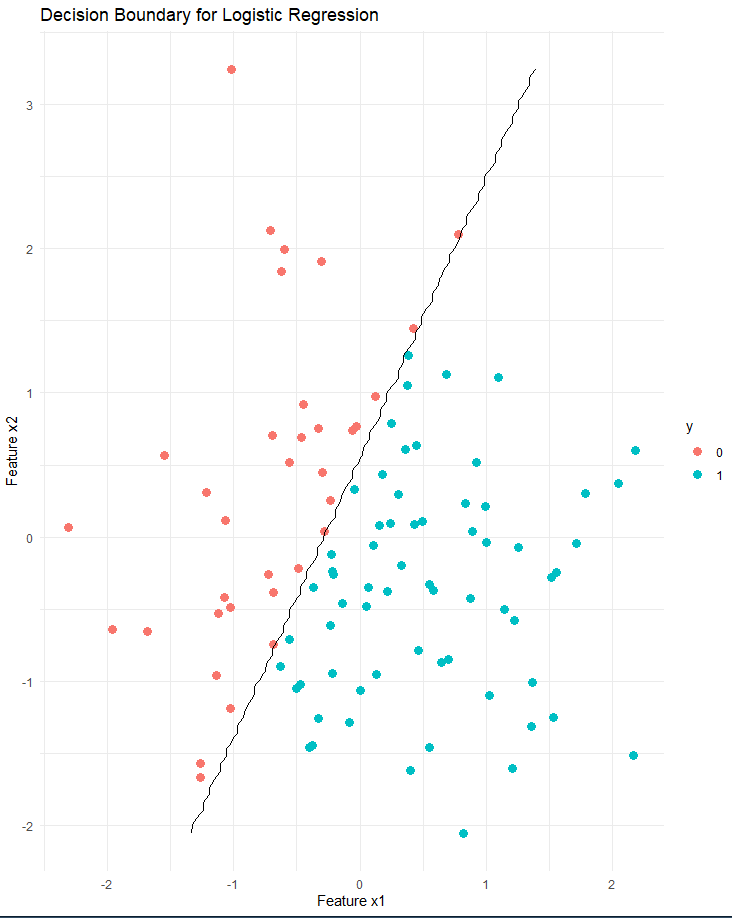

La regresión logística es, con diferencia, el modelo de aprendizaje automático más utilizado para conjuntos de datos de clasificación binaria. El modelo es relativamente simple y se basa en un supuesto clave: la existencia de una relación lineal. límite de decisión (una línea o una superficie en un espacio de características de dimensiones superiores) que puede separar las clases de la variable objetivo y en función de las características del modelo.
En pocas palabras, el límite de decisión puede interpretarse como un umbral en el que el modelo asigna un punto de datos a una clase u otra, condicionado a la probabilidad prevista de pertenecer a una clase.
La siguiente figura presenta una representación esquemática del límite de decisión que separa la variable objetivo en dos clases. En este caso el modelo se basa en un conjunto de dos características (x1 y x2). La variable objetivo se puede separar claramente en dos clases según los valores de las características.
Sin embargo, en sus actividades diarias de modelaje, la situación podría parecerse bastante a la figura siguiente.