
Las reuniones juegan un papel crucial en la toma de decisiones, la coordinación del proyecto y la colaboración, y las reuniones remotas son comunes en muchas organizaciones. Sin embargo, capturar y estructurar los conclusiones clave de estas conversaciones a menudo es ineficiente e inconsistente. Resumir manualmente las reuniones o extraer ítems de acción requiere un esfuerzo significativo y es propenso a omisiones o interpretaciones erróneas.
Modelos de idiomas grandes (LLMS) ofrecen una solución más robusta al transformar las transcripciones de reuniones no estructuradas en resúmenes estructurados y elementos de acción. Esta capacidad es especialmente útil para la gestión de proyectos, el servicio de atención al cliente y las llamadas de ventas, el cumplimiento legal y de cumplimiento, y la gestión del conocimiento empresarial.
En esta publicación, presentamos un punto de referencia de diferentes modelos de comprensión del Amazon Nova Familia disponible en Roca madre de Amazonpara proporcionar información sobre cómo puede elegir el mejor modelo para una tarea de resumen de reuniones.
LLMS para generar ideas para reuniones
Las LLM modernas son altamente efectivas para la extracción de resumen y ítems de acción debido a su capacidad para comprender el contexto, inferir las relaciones de los temas y generar resultados estructurados. En estos casos de uso, la ingeniería rápida proporciona un enfoque más eficiente y escalable en comparación con el ajuste o personalización del modelo tradicional. En lugar de modificar la arquitectura o capacitación del modelo subyacente en grandes conjuntos de datos etiquetados, la ingeniería rápida utiliza consultas de entrada cuidadosamente diseñadas para guiar el comportamiento del modelo, influyendo directamente en el formato de salida y el contenido. Este método permite una personalización rápida y específica del dominio sin la necesidad de procesos de reentrenamiento intensivos en recursos. Para tareas como la resumen de reuniones y la extracción de elementos de acción, la ingeniería rápida permite un control preciso sobre los resultados generados, asegurándose de cumplir con los requisitos comerciales específicos. Permite que el ajuste flexible de las indicaciones se adapte a los casos de uso en evolución, lo que lo convierte en una solución ideal para entornos dinámicos donde los comportamientos del modelo deben reorientarse rápidamente sin la sobrecarga del ajuste fino del modelo.
Amazon Nova Models y Amazon Bedrock
Modelos de Amazon Novapresentado en AWS Re: Invent en diciembre de 2024, están construidos para ofrecer inteligencia fronteriza en el rendimiento de los precios líderes en la industria. Están entre los modelos más rápidos y rentables en sus respectivos niveles de inteligencia, y están optimizados para encender la empresa IA generativa Aplicaciones de una manera confiable, segura y rentable.
La familia de modelos de comprensión tiene cuatro niveles de modelos: nova micro (solo texto, ultra eficiente para uso de borde), nova lite (multimodal, equilibrado para versatilidad), nova pro (multimodal, equilibrio de velocidad e inteligencia, ideal para las necesidades más empresariales) y nova premier (multimodal, el modelo de nova más capaz para tareas complejas y maestro para el destilación modelo). Los modelos Amazon Nova se pueden usar para una variedad de tareas, desde resumen hasta generación de texto estructurada. Con Destilación del modelo de roca madre de Amazonlos clientes también pueden llevar la inteligencia de Nova Premier a un modelo más rápido y más rentable, como Nova Pro o Nova Lite para su caso de uso o dominio. Esto se puede lograr a través del Consola de roca en Amazon y apis como el API Converse y Invocar API.
Descripción general de la solución
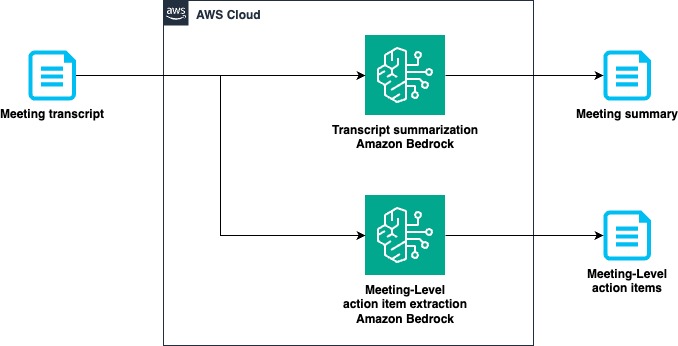
Esta publicación demuestra cómo usar modelos de comprensión de Amazon Nova, disponibles a través de Amazon Bedrock, para la extracción de información automatizada utilizando ingeniería rápida. Nos centramos en dos salidas clave:
- Resumen de reuniones -Un resumen abstracto de alto nivel que destila puntos de discusión clave, decisiones tomadas y actualizaciones críticas de la transcripción de la reunión
- Ítems de acción – Una lista estructurada de tareas procesables derivadas de la conversación de la reunión que se aplica a todo el equipo o proyecto
El siguiente diagrama ilustra el flujo de trabajo de la solución.
Requisitos previos
Para seguir con esta publicación, se espera la familiaridad con llamar a LLM que usa Amazon Bedrock. Para obtener pasos detallados sobre el uso de la roca madre de Amazon para las tareas de resumen de texto, consulte Construya una aplicación de resumen de texto de IA con roca madre de Amazon. Para obtener información adicional sobre llamar a LLMS, consulte el Invocar API y Usando la API Converse Documentación de referencia.
Componentes de la solución
Desarrollamos las dos características centrales de la solución, que concede la extracción de resumen y elementos de acción, al usar modelos populares disponibles a través de Amazon Bedrock. En las siguientes secciones, observamos las indicaciones que se usaron para estas tareas clave.
Para la tarea de resumen de la reunión, utilizamos una asignación de personalidadlo que lleva a la LLM a generar un resumen en <summary> Etiquetas para reducir las oraciones de apertura y cierre redundantes, y un enfoque de una sola vez al darle a la LLM un ejemplo para asegurarse de que el LLM siga constantemente el formato correcto para la generación sumaria. Como parte del mensaje del sistema, damos reglas claras y concisas que enfatizan el tono, el estilo, la longitud y la fidelidad correctos hacia la transcripción proporcionada.
Para la tarea de extracción de elementos de acción, dimos instrucciones específicas sobre la generación de elementos de acción en las indicaciones y utilizados cadena de pensamiento Para mejorar la calidad de los elementos de acción generados. En el mensaje del asistente, el prefijo <action_items> La etiqueta se proporciona como un precipitado Para empujar la generación del modelo en la dirección correcta y para evitar oraciones redundantes de apertura y cierre.
Las diferentes familias modelo responden a las mismas indicaciones de manera diferente, y es importante seguir la guía de solicitud definida para el modelo particular. Para obtener más información sobre las mejores prácticas para la solicitud de Amazon Nova, consulte Involucrar las mejores prácticas para los modelos de comprensión de Amazon Nova.
Conjunto de datos
Para evaluar la solución, utilizamos las muestras para el público Conjunto de datos QMSUM. El conjunto de datos QMSUM es un punto de referencia para el resumen de reuniones, con transcripciones de idioma inglés de discusiones académicas, comerciales y de gobierno con resúmenes anotados manualmente. Evalúa los LLM en la generación de resúmenes estructurados y coherentes a partir de conversaciones complejas y de múltiples hablantes, lo que lo convierte en un recurso valioso para la resumen abstractos y la comprensión del discurso. Para las pruebas, utilizamos 30 reuniones de muestras aleatorias del conjunto de datos QMSUM. Cada reunión contenía 2–5 transcripciones de tema y contenía aproximadamente 8,600 tokens para cada transcripción en promedio.
Marco de evaluación
Lograr resultados de alta calidad de LLMS en el resumen de la reunión y la extracción de ítems de acción puede ser una tarea desafiante. Las métricas de evaluación tradicionales como Rouge, Bleu y Meteor se centran en la similitud de nivel de superficie entre el texto generado y los resúmenes de referencia, pero a menudo no pueden capturar matices como la corrección objetiva, la coherencia y la acción. La evaluación humana es el estándar de oro pero es costoso, que requiere mucho tiempo y no es escalable. Para abordar estos desafíos, puede usar LLM-AS-A-Judge, donde se utiliza otro LLM para evaluar sistemáticamente la calidad de las salidas generadas basadas en criterios bien definidos. Este enfoque ofrece una forma escalable y rentable de automatizar la evaluación mientras mantiene una alta precisión. En este ejemplo, utilizamos el soneto Claude 3.5 V1 de Anthrope como el modelo de Juez porque encontramos que estaba más alineado con el juicio humano. Utilizamos el juez de LLM para calificar las respuestas generadas en tres métricas principales: fidelidad, resumen y respuesta de preguntas (QA).
El fidelidad El puntaje mide la fidelidad de un resumen generado midiendo la porción de las declaraciones analizadas en un resumen respaldado por el contexto dado (por ejemplo, una transcripción de la reunión) con respecto al número total de declaraciones.
El resumen La puntuación es la combinación de la puntuación de control de calidad y la puntuación de concisión con el mismo peso (0.5). El puntaje de control de calidad mide la cobertura de un resumen generado a partir de una transcripción de reunión. Primero genera una lista de pares de preguntas y respuestas a partir de una transcripción de una reunión y mide la parte de las preguntas que se hacen correctamente cuando el resumen se usa como un contexto en lugar de una transcripción de la reunión. El puntaje de control de calidad es complementario al puntaje de fidelidad porque el puntaje de fidelidad no mide la cobertura de un resumen generado. Solo utilizamos el puntaje de control de calidad para medir la calidad de un resumen generado porque no se supone que los elementos de acción cubran todos los aspectos de una transcripción de una reunión. El puntaje de concisión mide la relación de la longitud de un resumen generado dividido por la longitud de la transcripción total de la reunión.
Utilizamos una versión modificada del puntaje de fidelidad y el puntaje de resumen que tenía una latencia mucho menor que la implementación original.
Resultados
Nuestra evaluación de los modelos de Amazon Nova a través de las tareas de resumen y extracción de elementos de acción reveló claros patrones de latencia de rendimiento. Para resumir, Nova Premier logró el puntaje de fidelidad más alto (1.0) con un tiempo de procesamiento de 5.34s, mientras que Nova Pro entregó 0.94 fidelidad en 2.9s. Los modelos Micro Nova Lite y Nova más pequeños proporcionaron puntajes de fidelidad de 0.86 y 0.83 respectivamente, con tiempos de procesamiento más rápidos de 2.13 y 1.52. En la extracción de ítems de acción, Nova Premier volvió a liderar en fidelidad (0.83) con un tiempo de procesamiento de 4.94s, seguido de Nova Pro (0.8 fidelidad, 2.03s). Curiosamente, Nova Micro (0.7 fidelidad, 1.43s) superó a Nova Lite (0.63 fidelidad, 1.53s) en esta tarea en particular a pesar de su tamaño más pequeño. Estas mediciones proporcionan información valiosa sobre las características de velocidad de rendimiento en la familia Modelo Amazon Nova para aplicaciones de procesamiento de texto. Los siguientes gráficos muestran estos resultados. La siguiente captura de pantalla muestra una salida de muestra para nuestra tarea de resumen, incluido el resumen de reuniones generado por LLM y una lista de elementos de acción.

Conclusión
En esta publicación, mostramos cómo puede usar la solicitud para generar información de reuniones, como resúmenes de reuniones y elementos de acción utilizando modelos Amazon Nova disponibles a través de Amazon Bedrock. Para la resumen de reuniones de IA a gran escala, la optimización de la latencia, el costo y la precisión es esencial. La familia Amazon Nova de modelos de comprensión (Nova Micro, Nova Lite, Nova Pro y Nova Premier) ofrece una alternativa práctica a los modelos de alta gama, mejorando significativamente la velocidad de inferencia al tiempo que reduce los costos operativos. Estos factores hacen de Amazon Nova una opción atractiva para las empresas que manejan grandes volúmenes de datos de reunión a escala.
Para obtener más información sobre Amazon Bedrock y los últimos modelos de Amazon Nova, consulte el Guía del usuario de Amazon Bedrock y Guía del usuario de Amazon Novarespectivamente. El AWS Generative AI Innovation Center tiene un grupo de expertos en ciencia y estrategia de AWS con experiencia integral que abarca el viaje generativo de IA, ayudando a los clientes a priorizar los casos de uso, construir una hoja de ruta y mover soluciones a la producción. Mira el Centro de innovación de IA generativo para nuestras últimas historias de trabajo y éxito del cliente.
Sobre los autores
Baishali Chaudhury es una científica aplicada en el Centro de Innovación Generativa de AI en AWS, donde se enfoca en avanzar en soluciones generativas de IA para aplicaciones del mundo real. Ella tiene una sólida experiencia en visión por computadora, aprendizaje automático e IA para la atención médica. Baishali posee un doctorado en informática de la Universidad del Sur de Florida y Postdoc del Centro de Cáncer Moffitt.
Sungmin Hong es un científico aplicado en el Centro de Innovación de AI de Amazon Generative, donde ayuda a acelerar la variedad de casos de uso de clientes de AWS. Antes de unirse a Amazon, Sungmin fue investigador postdoctoral en la Facultad de Medicina de Harvard. Tiene Ph.D. en informática de la Universidad de Nueva York. Fuera del trabajo, se enorgullece de mantener vivas sus plantas de interior durante más de 3 años.
Mengdie (Flora) Wang Es una científica de datos en el Centro de Innovación AI AI AWS, donde trabaja con los clientes para arquitectos e implementan soluciones de IA generativas escalables que abordan sus desafíos comerciales únicos. Se especializa en técnicas de personalización de modelos y sistemas de IA basados en agentes, ayudando a las organizaciones a aprovechar todo el potencial de la tecnología generativa de IA. Antes de AWS, Flora obtuvo su maestría en informática de la Universidad de Minnesota, donde desarrolló su experiencia en aprendizaje automático e inteligencia artificial.
Anila Joshi Tiene más de una década de experiencia en la construcción de soluciones de IA. Como líder de AWSI GEO en el Centro de Innovación Generativa AI de AWS, Anila pionera aplicaciones innovadoras de IA que impulsan los límites de la posibilidad y aceleran la adopción de servicios de AWS con los clientes al ayudar a los clientes a idear, identificar e implementar soluciones de IA generativas seguras.