
| Lo que se incluye en este artículo: |
| Avances de rendimiento – 2x inferencia más rápida y 3x entrenamiento más rápido Arquitectura técnica – Diseño híbrido con convolución y bloques de atención Especificaciones de modelo – Variantes de tres tamaño (350m, 700m, 1.2B de parámetros) Resultados de referencia -rendimiento superior en comparación con modelos de tamaño similar Optimización de la implementación -Diseño centrado en el borde para varios hardware Accesibilidad de código abierto -Licencias basadas en Apache 2.0 Implicaciones del mercado – Impacto en la adopción de la IA de borde |
El paisaje de la inteligencia artificial en el dispositivo ha dado un salto significativo hacia adelante con la liberación de Lift AI de LFM2, sus modelos de fundación líquida de segunda generación. Esta nueva serie de modelos de IA generativos representa un cambio de paradigma en la computación de borde, que ofrece optimizaciones de rendimiento sin precedentes diseñadas específicamente para la implementación en el dispositivo mientras mantiene estándares de calidad competitivos.
Ganancias de rendimiento revolucionaria
LFM2 establece nuevos puntos de referencia en el espacio EDGE AI al lograr mejoras de eficiencia notables en múltiples dimensiones. Los modelos ofrecen un rendimiento 2X de decodificación más rápido y previa para la refrescante en comparación con QWEN3 en las arquitecturas de CPU, un avance crítico para aplicaciones en tiempo real. Quizás de manera más impresionante, el proceso de capacitación en sí se ha optimizado para lograr una capacitación 3 veces más rápida en comparación con la generación de LFM anterior, lo que hace que LFM2 sea el camino más rentable para construir sistemas de IA de uso general capaz de utilizar.
Estas mejoras de rendimiento no son simplemente incrementales, sino que representan un avance fundamental para hacer que la IA poderosa sea accesible en dispositivos con recursos limitados. Los modelos están diseñados específicamente para desbloquear la latencia de milisegundos, la resiliencia fuera de línea y la privacidad de los datos sobre la privacidad, las capacidades esenciales para teléfonos, computadoras portátiles, automóviles, robots, dispositivos portátiles, satélites y otros puntos finales que deben razonar en tiempo real.
Innovación de arquitectura híbrida
La base técnica de LFM2 se encuentra en su nueva arquitectura híbrida que combina los mejores aspectos de los mecanismos de convolución y atención. El modelo emplea una estructura sofisticada de 16 bloques de 16 bloques que consta de 10 bloques de convolución de corto alcance de doble activación y 6 bloques de atención de consulta agrupada (GQA). Este enfoque híbrido se basa en el trabajo pionero de Liquid AI en Liquid Time Constante (LTC), que introdujeron redes neuronales recurrentes de tiempo continuo con sistemas dinámicos lineales modulados por puertas intercaladas de entrada no lineales.
En el núcleo de esta arquitectura se encuentra el marco del operador de variedad de entrada lineal (LIV), que permite que los pesos se generen sobre la marcha a partir de la entrada en la que están actuando. Esto permite que las convoluciones, las recurrencias, la atención y otras capas estructuradas caigan en un marco unificado de entrada. Los bloques de convolución LFM2 implementan puertas multiplicativas y convoluciones cortas, creando sistemas lineales de primer orden que convergen a cero después de un tiempo finito.
El proceso de selección de arquitectura utilizó Star, el motor de búsqueda de arquitectura neuronal de Liquid AI, que se modificó para evaluar las capacidades de modelado de idiomas más allá de la pérdida de validación tradicional y las métricas de perplejidad. En cambio, emplea un conjunto integral de más de 50 evaluaciones internas que evalúan diversas capacidades, incluyendo retiro de conocimiento, razonamiento de múltiples saltos, comprensión de idiomas de baja recursos, instrucciones seguidas y uso de herramientas.

Línea de modelo integral
LFM2 está disponible en tres configuraciones de tamaño estratégicamente: parámetros de 350m, 700m y 1.2b, cada uno optimizado para diferentes escenarios de implementación mientras se mantiene los beneficios de eficiencia central. Todos los modelos fueron capacitados en 10 billones de tokens extraídos de un corpus previo al entrenamiento cuidadosamente seleccionado que comprende aproximadamente 75% de inglés, 20% de contenido multilingüe y 5% de datos de código procedentes de la web y los materiales con licencia.
La metodología de capacitación incorpora la destilación de conocimiento utilizando el LFM1-7B existente como modelo de maestro, con entropía transversal entre las salidas de estudiantes de LFM2 y las salidas del maestro que sirve como señal de capacitación principal en todo el proceso de capacitación de token de 10T. La longitud de contexto se extendió a 32k durante la pretruación, lo que permite que los modelos manejaran secuencias más largas de manera efectiva.

Rendimiento de referencia superior
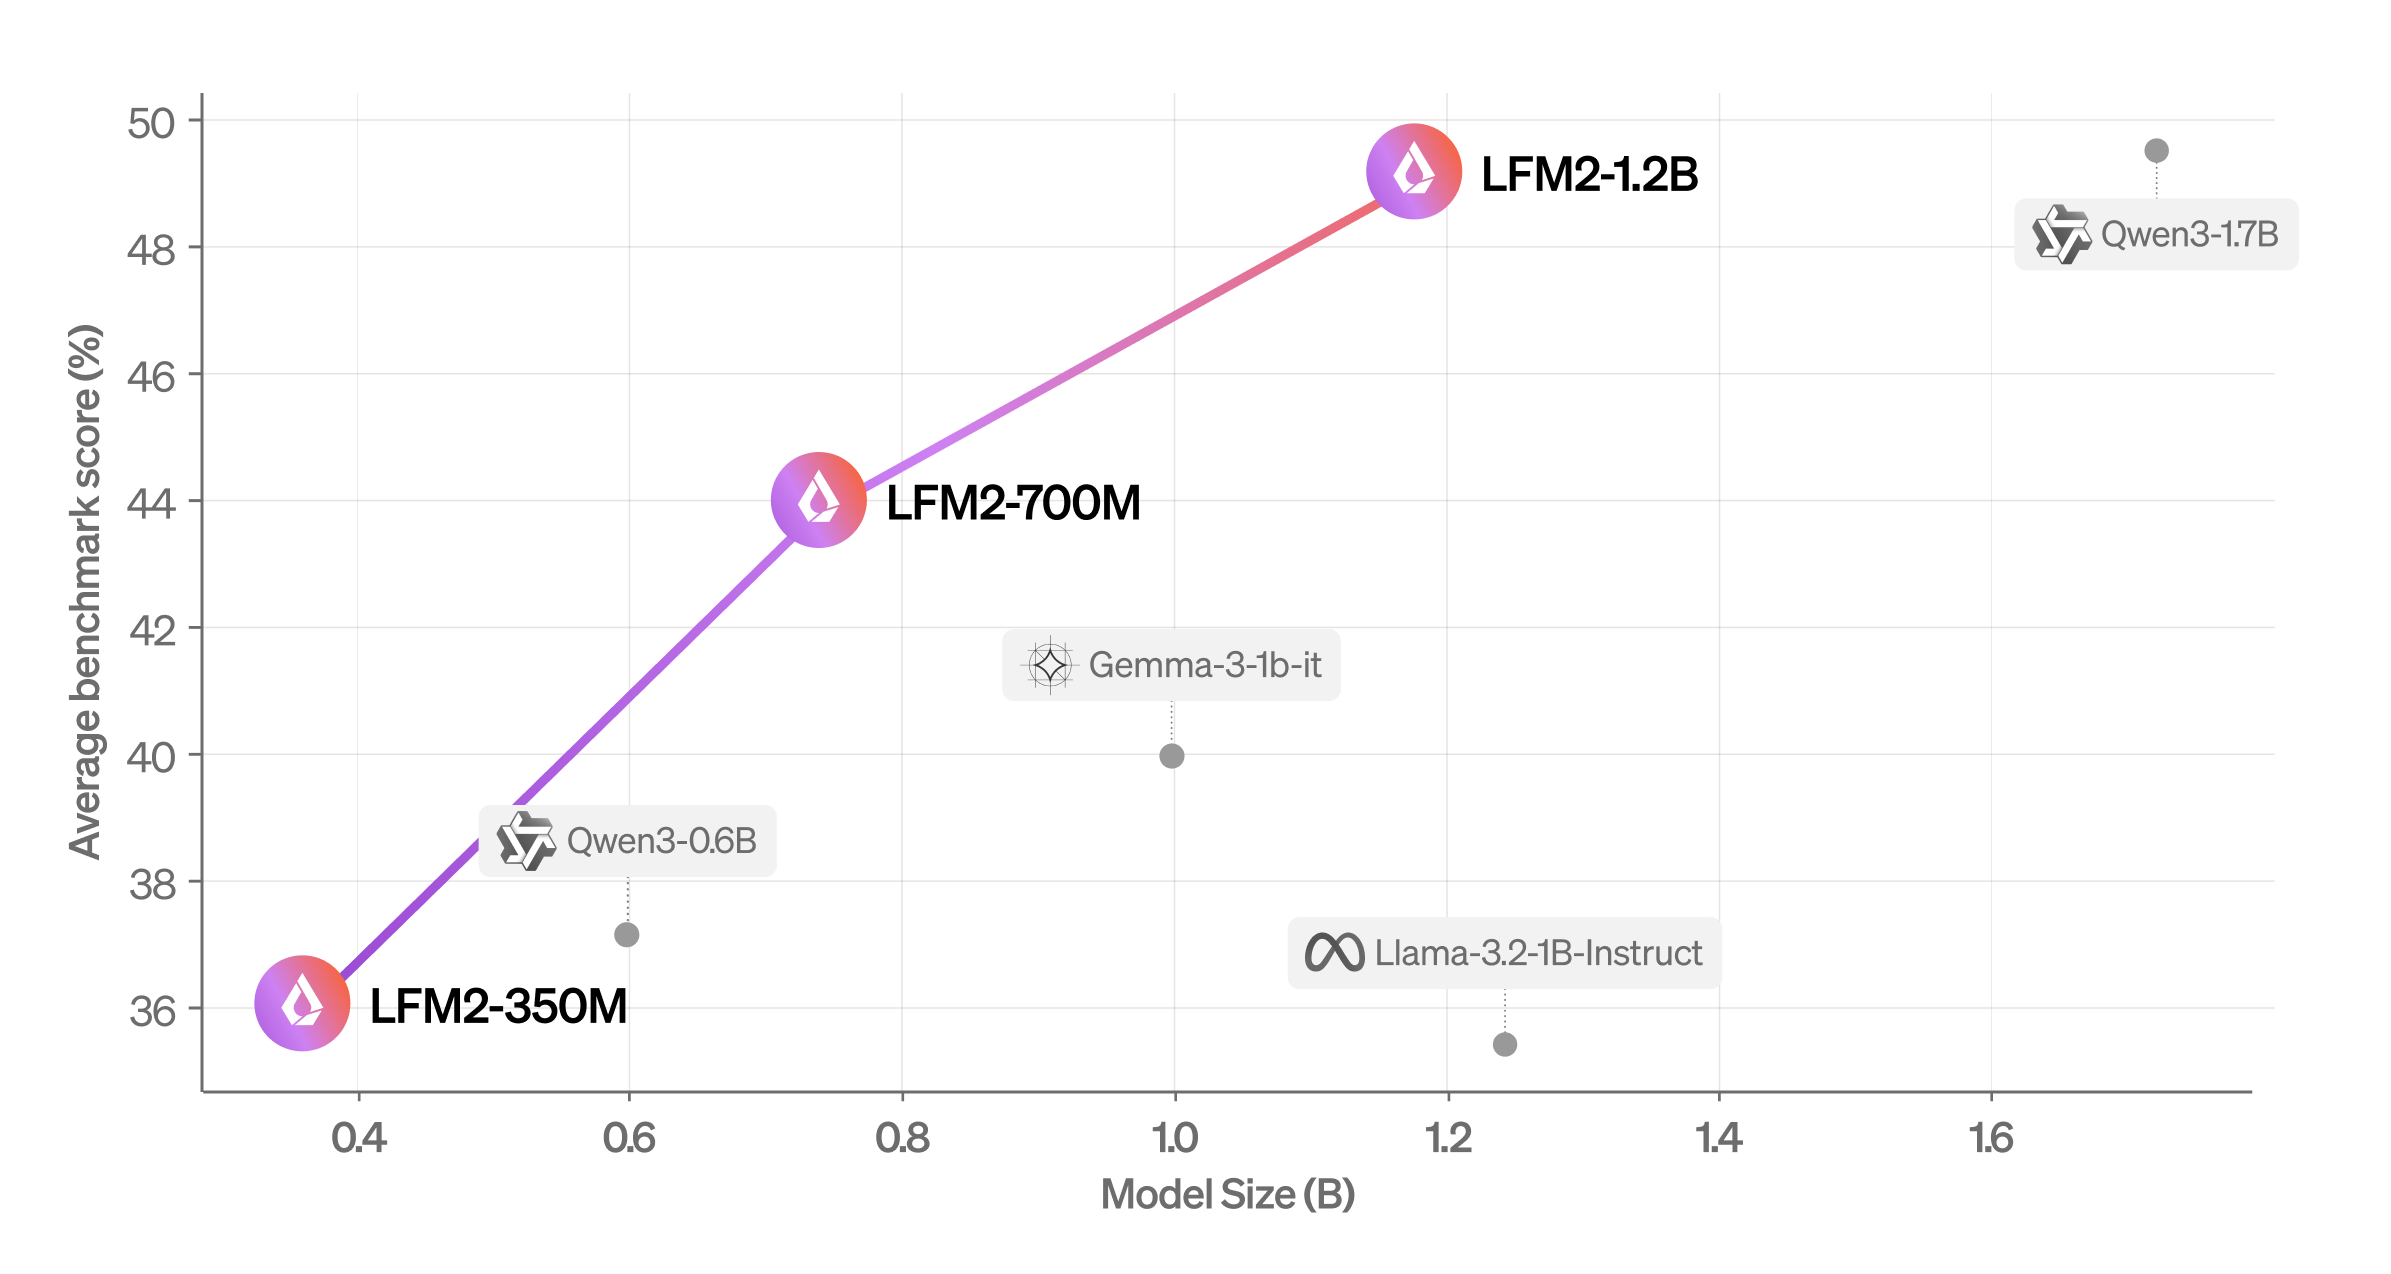
Los resultados de la evaluación demuestran que LFM2 supera significativamente los modelos de tamaño similar en múltiples categorías de referencia. El modelo LFM2-1.2B funciona de manera competitiva con QWEN3-1.7B a pesar de tener un 47% menos de parámetros. Del mismo modo, LFM2-700M supera a Gemma 3 1B IT, mientras que el punto de control LFM2-350m más pequeño sigue siendo competitivo con QWEN3-0.6B y instructo de LLAMA 3.2 1B.
Más allá de los puntos de referencia automatizados, LFM2 demuestra capacidades de conversación superiores en diálogos múltiples. Utilizando el conjunto de datos Wildchat y el marco de evaluación LLM-AS-A-Judge, LFM2-1.2B mostró ventajas de preferencia significativas sobre LLAMA 3.2 1B INSTRUCT y GEMMA 3 1B IT mientras coinciden con el rendimiento QWEN3-1.7B a pesar de ser sustancialmente más pequeño y más rápido.

Implementación optimizada de borde
Los modelos se destacan en escenarios de implementación del mundo real, habiéndose exportado a múltiples marcos de inferencia, incluida el ejecutor de Pytorch y la biblioteca Llama.cpp de código abierto. Las pruebas en el hardware objetivo, incluidas las plataformas Samsung Galaxy S24 Ultra y AMD Ryzen, demuestran que LFM2 domina la frontera de Pareto para la velocidad de inferencia de pregrascos y decodificaciones en relación con el tamaño del modelo.
El fuerte rendimiento de la CPU se traduce de manera efectiva a aceleradores como GPU y NPU después de la optimización del núcleo, lo que hace que LFM2 sea adecuado para una amplia gama de configuraciones de hardware. Esta flexibilidad es crucial para el diverso ecosistema de dispositivos de borde que requieren capacidades de IA en el dispositivo.
Conclusión
El lanzamiento de LFM2 aborda una brecha crítica en el panorama de implementación de AI, donde se está acelerando el cambio de inferencia basada en la nube a borde. Al habilitar la latencia de milisegundos, la operación fuera de línea y la privacidad de los datos sobre los datos, LFM2 desbloquea nuevas posibilidades para la integración de IA en la electrónica de consumo, la robótica, los electrodomésticos, las finanzas, el comercio electrónico y los sectores educativos.
Los logros técnicos representados en LFM2 indican una maduración de la tecnología EDGE AI, donde las compensaciones entre la capacidad del modelo y la eficiencia de despliegue se optimizan con éxito. A medida que las empresas pivoten desde la nube LLMS a la inteligencia rentable, rápida, privada y local, LFM2 se posiciona como una tecnología fundamental para la próxima generación de dispositivos y aplicaciones impulsados por IA.
Asif Razzaq es el CEO de MarktechPost Media Inc .. Como empresario e ingeniero visionario, ASIF se compromete a aprovechar el potencial de la inteligencia artificial para el bien social. Su esfuerzo más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, MarktechPost, que se destaca por su cobertura profunda de noticias de aprendizaje automático y de aprendizaje profundo que es técnicamente sólido y fácilmente comprensible por una audiencia amplia. La plataforma cuenta con más de 2 millones de vistas mensuales, ilustrando su popularidad entre el público.