
Los LLM han avanzado rápidamente con los recuentos de parámetros altísimos, el uso generalizado de diseños de mezcla de expertos (MOE) y longitudes de contexto masivas. Modelos como Deepseek-R1, Llama-4 y Qwen-3 ahora alcanzan billones de parámetros, exigiendo un enorme cómputo, un ancho de banda de memoria y una comunicación rápida entre chip. MOE mejora la eficiencia, pero crea desafíos en el enrutamiento experto, mientras que las ventanas de contexto que exceden un millón de tokens cuentan la atención y el almacenamiento de caché de KV, que escala con usuarios concurrentes. En las implementaciones del mundo real, las entradas impredecibles, las activaciones de expertos desiguales y las consultas explosivas complican aún más el servicio. Abordar estas presiones requiere un replanteamiento de la infraestructura de IA a través de hardware-software de co-diseño, orquestación adaptativa y gestión de recursos elásticos.
El progreso reciente en LLMS está conformado por tres tendencias principales: recuentos de parámetros cada vez mayores, arquitecturas MOE dispersas y ventanas de contexto extendidas. Modelos como Llama 4, Deepseek-V3 y Palm Push de Google Escala en los billones de parámetros, mientras que los diseños de MOE activan solo subconjuntos de expertos por token, equilibrando la eficiencia con la capacidad. Mientras tanto, las ventanas de contexto ahora abarcan cientos de miles a millones de tokens, lo que permite un razonamiento de forma larga pero que se pone en cuenta y memoria a través de grandes cachés de valor clave. Estos avances ejercen una inmensa presión sobre los centros de datos, exigen un mayor cálculo, memoria y ancho de banda al tiempo que introducen desafíos en el paralelismo, la heterogeneidad de la carga de trabajo, la convergencia de datos y el rendimiento de almacenamiento.
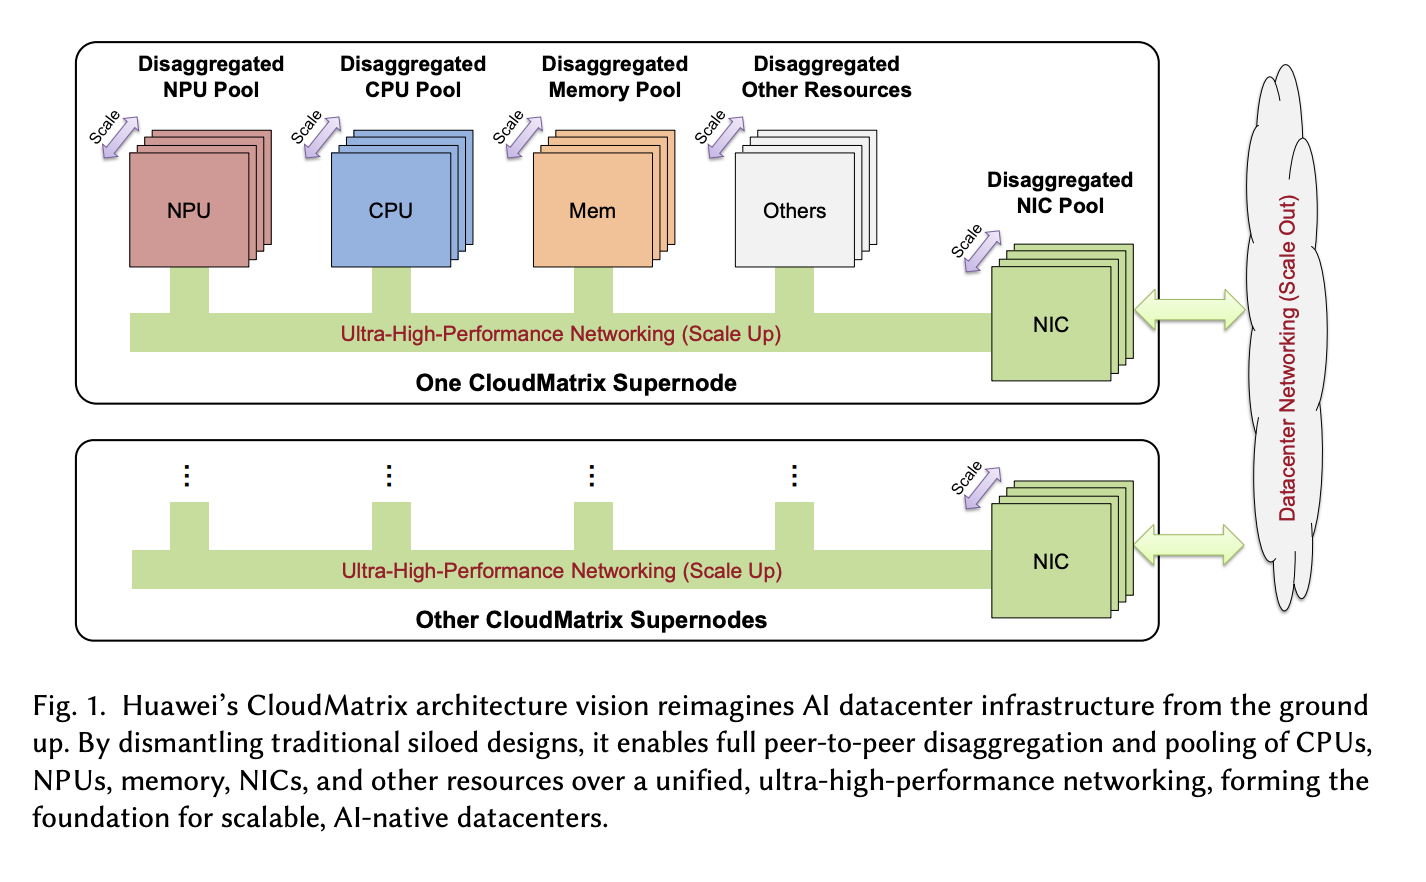
Los investigadores de Huawei introdujeron CloudMatrix, una nueva arquitectura de centro de datos AI diseñada para manejar las crecientes demandas de LLM a gran escala. Su primera implementación, CloudMatrix384, combina 384 ASCEND 910C NPUS y 192 CPU Kunpeng, todas vinculadas por un autobús unificado de alta latencia de alto ancho que permite una comunicación completamente entre pares. Este diseño permite una agrupación flexible de recursos de cómputo, memoria y red, lo que lo hace ideal para el paralelismo de MOE y el acceso distribuido de caché de KV. Además de esto, CloudMatrix-Infer ofrece un marco de servicio optimizado con grupos de recursos entre pares, paralelismo expertos a gran escala y optimizaciones conscientes de hardware como tuberías y cuantización INT8. Las evaluaciones con Deepseek-R1 muestran el rendimiento de vanguardia, la eficiencia y la escalabilidad.
Huawei CloudMatrix es una nueva arquitectura de centro de datos AI basada en interconexiones de ancho de banda alto de pares y desagregación de recursos de grano fino. Su primera implementación a gran escala, CloudMatrix384, integra 384 ASCEND 910C NPUS y 192 CPU Kunpeng en un solo supernodo, todo vinculado por una red de bus unificada que permite una comunicación directa directa. Este diseño permite que los recursos de cómputo, memoria y de red se compartan sin problemas y se escalen de forma independiente, operando como un sistema cohesivo. Al evitar los cuellos de botella de las configuraciones jerárquicas tradicionales, CloudMatrix384 es particularmente efectivo para tareas de comunicación, como el paralelismo MOE a gran escala y la gestión distribuida de caché de KV, lo que lo hace ideal para servir LLM escalable.
Los investigadores evalúan CloudMatrix-Infer en el modelo Deepseek-R1 utilizando el supernodio CloudMatrix384. El sistema logra un rendimiento previo al rendimiento de 6,688 tokens por segundo por NPU y un rendimiento de decodificación de 1,943 tokens por segundo con latencia mantenidas por debajo de 50 ms, superando los sistemas comparables como SGLANG en NVIDIA H100 y Deepseek en H800. Incluso cuando se limita a requisitos de latencia más estrictos de menos de 15 ms, mantiene 538 tokens por segundo en decodificación. Además, la cuantificación de INT8 en el ASCEND 910C conserva la precisión en 16 puntos de referencia, lo que demuestra que las mejoras de eficiencia no comprometen la calidad del modelo.

En conclusión, Huawei CloudMatrix es una arquitectura de centro de datos AI de próxima generación diseñada para superar los límites de escalabilidad de los grupos convencionales. Su primer sistema de producción, CloudMatrix384, combina 384 ASCEND 910C NPUS y 192 CPU de Kunpeng en un supernodo completamente de igual a igual conectado a través de un autobús unificado de bajo ancho de banda y baja latencia. Para explotar este diseño, el estudio propone CloudMatrix-Infer, que separa la pregramado, el decodificación y el almacenamiento en caché en las piscinas independientes, admite el paralelismo expertos a gran escala y aplica optimizaciones de hardware como tuberías y cuantización INT8. Probado en Deepseek-R1, logró un rendimiento superior y un rendimiento de latencia en comparación con los sistemas basados en NVIDIA, al tiempo que preservó la precisión, mostrando su potencial para implementaciones de IA a gran escala.
Mira el Papel técnico. No dude en ver nuestro Página de Github para tutoriales, códigos y cuadernos. Además, siéntete libre de seguirnos Gorjeo Y no olvides unirte a nuestro Subreddit de 100k+ ml y suscribirse a Nuestro boletín.

Sana Hassan, una pasante de consultoría en MarktechPost y estudiante de doble grado en IIT Madras, le apasiona aplicar tecnología e IA para abordar los desafíos del mundo real. Con un gran interés en resolver problemas prácticos, aporta una nueva perspectiva a la intersección de la IA y las soluciones de la vida real.