
El costo oculto de la IA: la factura de la GPU
La capacitación del modelo de IA generalmente consume millones de dólares en cómputo de GPU, una carga que da forma a los presupuestos, limita la experimentación y el progreso. El status quo: capacitar un modelo de lenguaje moderno o transformador de visión en Imagenet-1k puede quemar a través de miles de horas de GPU. No es sostenible para nuevas empresas, laboratorios o incluso grandes empresas tecnológicas.
Pero, ¿qué pasaría si pudiera reducir su factura de GPU en un 87%, simplemente cambiando el optimizador?
Esa es la promesa de Proyección ortogonal de Fisher (FOP)una última investigación del equipo de la Universidad de Oxford. Este artículo lo guiará a través de por qué los gradientes no son ruido, cómo FOP piensa como un mapa de terreno y qué significa esto para su negocio, su modelo y el futuro de la IA.
El defecto en cómo entrenaremos modelos
Moderno aprendizaje profundo confía en descenso de gradiente: El Optimizer empuja los parámetros del modelo en una dirección que debería reducir la pérdida. Pero con entrenamiento a gran escala, el optimizador funciona con mini lotes—Subsets de los datos de capacitación y promedios sus gradientes para obtener una sola dirección de actualización.
Aquí está la captura: El gradiente de cada elemento en el lote siempre es diferente. El enfoque estándar descarta estas diferencias como ruido aleatorio y las suaviza para la estabilidad. Pero en realidad Este “ruido” es una señal direccional crucial sobre la verdadera forma del panorama de la pérdida.
FOP: el navegador consciente del terreno
PETIMETRE trata el Varianza entre los gradientes dentro de un lote no como ruido, sino como un mapa de terreno. Se necesita el gradiente promedio (la dirección principal) y proyectar las diferencias, construyendo un componente sensible a la curvatura consciente de la geometría Eso dirige al optimizador lejos de las paredes y a lo largo del piso del cañón, incluso cuando la dirección principal está recta.
Cómo funciona:
- Gradiente promedio señala el camino.
- Gradiente de diferencia Actúa como un sensor de terreno, revelando si el paisaje es plano (seguro para moverse rápido) o tiene paredes empinadas (disminuya la velocidad, permanezca en el cañón).
- FOP combina ambas señales: Agrega un paso ortogonal de “curvatura consciente” a la dirección principal, Asegurar que nunca luche contra sí mismo o sobrepasos.
- Resultado: Convergencia más rápida y estable, incluso a Tamaños de lotes extremos—El régimen donde fallan SGD, Adamw e incluso de última generación.
En términos de aprendizaje profundo: FOP aplica un Corrección ortogonal de Fisher Además del descenso de gradiente natural estándar (NGD). Preservando esto varianza intra-lotesFOP mantiene información sobre el curvatura local del panorama de la pérdida, una señal que se perdió previamente en el promedio.
FOP en la práctica: 7.5x más rápido en Imagenet-1k
Los resultados son dramáticos:
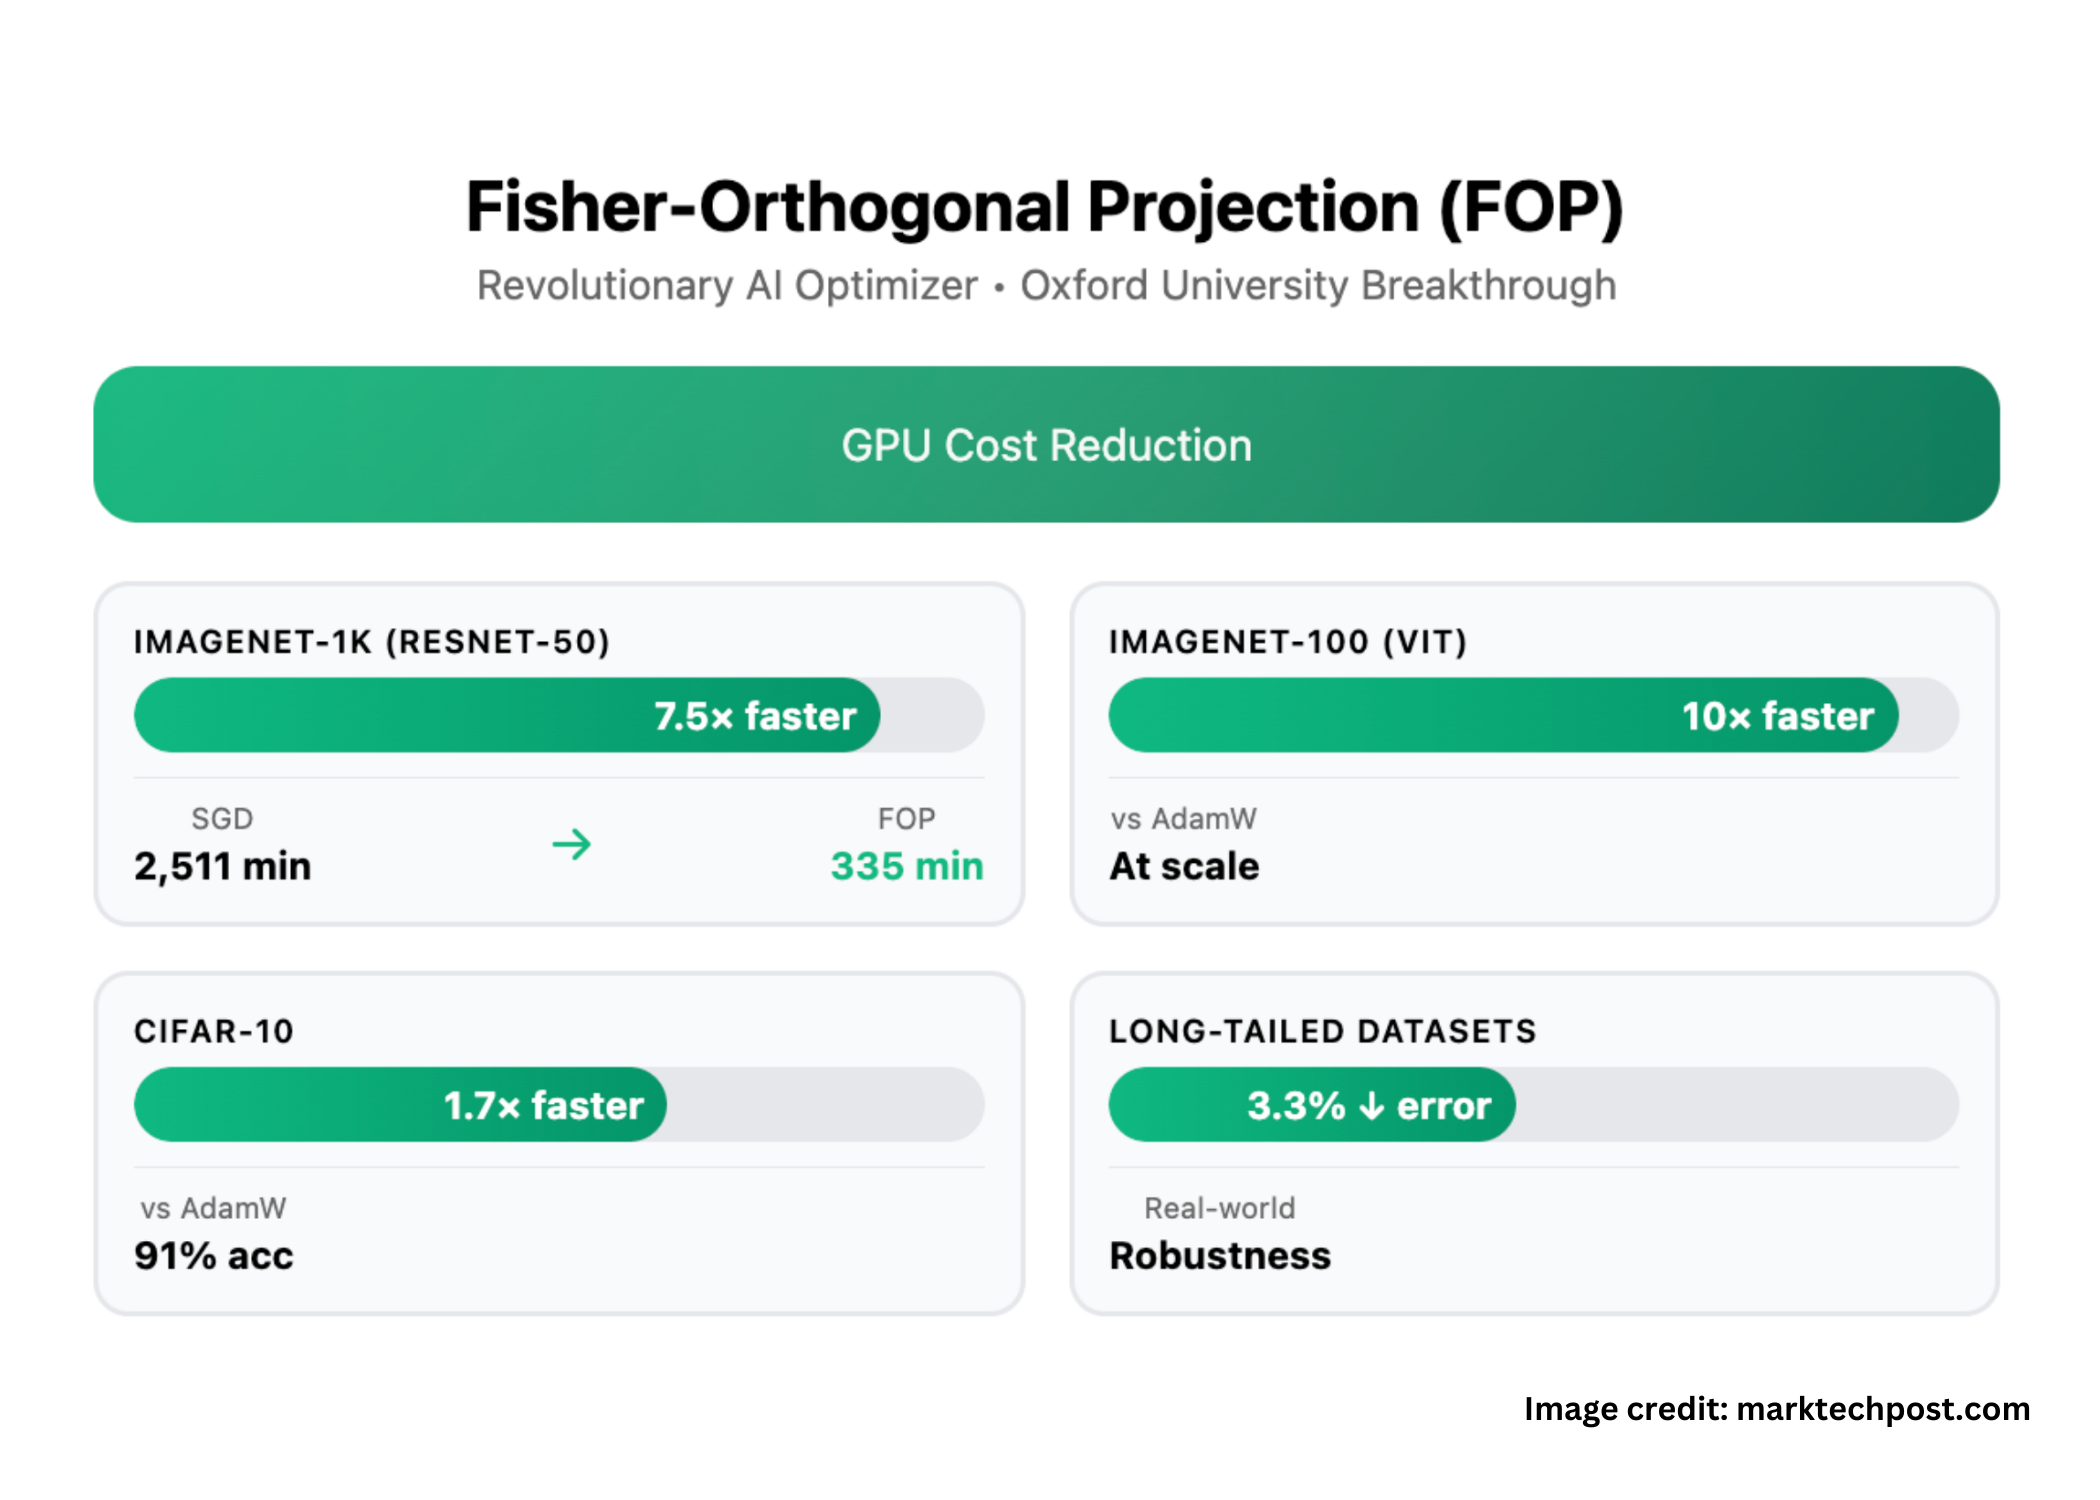
- ImageNet-1K (resnet-50): Para alcanzar la precisión de validación estándar (75.9%), Sgd Toma 71 épocas y 2,511 minutos. FOP alcanza la misma precisión en solo 40 épocas y 335 minutos: una aceleración de 7.5x de pared..
- CIFAR-10: FOP es 1.7x más rápido que Adamw, 1.3x más rápido que KFAC. En el tamaño de lote más grande (50,000), Solo FOP alcanza la precisión del 91%; otros fallan por completo.
- ImageNet-100 (transformador de visión): FOP es hasta 10 veces más rápido que Adamw, 2x más rápido que KFAC, en los tamaños de lotes más grandes.
- Conjuntos de datos de cola larga (desequilibrada): FOP reduce el error top-1 por 2.3–3.3% sobre líneas de base fuertes: una ganancia significativa para datos desordenados del mundo real.
Uso de memoria: La huella de memoria GPU máxima de FOP es mayor para trabajos a pequeña escala, pero cuando se distribuye en muchos dispositivos, coincide con KFAC, y los ahorros de tiempo superan con creces el costo.
Escalabilidad: PETIMETRE sostiene la convergencia incluso cuando los tamaños de lotes suben a decenas de miles—Tugo que ningún otro optimizador probado podría hacer. Con más GPU, El tiempo de entrenamiento cae casi linealmente—Fonijos de métodos existentes, que a menudo se degradan en eficiencia paralela.
Por qué esto importa para los negocios, la práctica y la investigación.
- Negocio: Una reducción del 87% en el costo de capacitación Transforma la economía del desarrollo de la IA. Esto no es incremental. Los equipos pueden volver a invertir los ahorros en modelos más grandes y ambiciosos, o construir un foso con una experimentación más rápida y barata.
- Practicantes: FOP es plug-and-play: El código de código abierto del documento se puede dejar en flujos de trabajo de Pytorch existentes con un cambio de línea único y Sin ajuste adicional. Si usas KFAC, ya estás a mitad de camino.
- Investigadores: FOP redefine qué “ruido” es en descenso de gradiente. La varianza intra-batch no solo es útil, es esencial. Robustez en datos desequilibrados es una ventaja para la implementación del mundo real.
Cómo cambia el FOP el paisaje
Tradicionalmente, los grandes lotes eran una maldición: Hicieron inestables SGD y Adamw, e incluso KFAC (con su curvatura de gradiente natural) se desmoronaron. FOP gira esto en su cabeza. Preservando y apalancando Variación de gradiente intra-lotesdesbloquea Entrenamiento estable, rápido y escalable en tamaños de lotes sin precedentes.
FOP no es un ajuste: es un replanteamiento fundamental de qué señales son valiosas en la optimización. El “ruido” que promedias hoy es Tu mapa de terreno mañana.
Tabla de resumen: FOP versus status quo
| Métrico | SGD/Adamw | KFAC | Fop (este trabajo) |
|---|---|---|---|
| Aceleración de la pared | Base | 1.5–2x más rápido | Hasta 7.5x más rápido |
| Estabilidad de lotes grandes | Fallas | Puestos, necesita amortiguación | Funciona a escala extrema |
| Robustez (desequilibrio) | Pobre | Modesto | Mejor en clase |
| Plug-and-play | Sí | Sí | Sí (PIP instalable) |
| Memoria de GPU (distribuida) | Bajo | Moderado | Moderado |

Resumen
La proyección ortogonal de Fisher (FOP) es un salto hacia adelante para el entrenamiento de IA a gran escala, que ofrece una convergencia de hasta 7.5 × más rápida en conjuntos de datos como ImageNet-1k a tamaños de lotes extremadamente grandes, al tiempo que mejora la generalización, reduciendo las tasas de error en 2.3-3.3% en compartimentos desafiantes y destrozados. A diferencia de los optimizadores convencionales, los extractos de FOP y aprovecha la varianza del gradiente para navegar por la verdadera curvatura del panorama de pérdidas, utilizando información que previamente se descartó como “ruido”. Esto no solo recorta los costos de calculación de GPU, potencialmente en un 87%, sino que también permite a los investigadores y compañías capacitar a modelos más grandes, iterar más rápido y mantener un rendimiento robusto incluso en datos desiguales del mundo real. Con una implementación de Pytorch plug-and-play y un ajuste mínimo, FOP ofrece una ruta práctica y escalable para la próxima generación de aprendizaje automático a escala.
Mira el Papel. No dude en ver nuestro Página de Github para tutoriales, códigos y cuadernos. Además, siéntete libre de seguirnos Gorjeo Y no olvides unirte a nuestro Subreddit de 100k+ ml y suscribirse a Nuestro boletín.
Asif Razzaq es el CEO de MarktechPost Media Inc .. Como empresario e ingeniero visionario, ASIF se compromete a aprovechar el potencial de la inteligencia artificial para el bien social. Su esfuerzo más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, MarktechPost, que se destaca por su cobertura profunda de noticias de aprendizaje automático y de aprendizaje profundo que es técnicamente sólido y fácilmente comprensible por una audiencia amplia. La plataforma cuenta con más de 2 millones de vistas mensuales, ilustrando su popularidad entre el público.