
A medida que las organizaciones adoptan cada vez más modelos de base (FMS) para sus cargas de trabajo de inteligencia artificial y aprendizaje automático (AI/ML), la gestión de operaciones de inferencia a gran escala se vuelve crucial. Amazon Bedrock admite dos tipos generales de patrones de inferencia a gran escala: inferencia en tiempo real e inferencia por lotes para casos de uso que implican procesar conjuntos de datos masivos donde los resultados inmediatos no son necesarios.
Inferencia por lotes de rock de Amazon es un solución rentable Eso ofrece un descuento del 50% en comparación con el procesamiento a pedido, lo que lo hace ideal para cargas de trabajo de alto volumen e insensible al tiempo. Sin embargo, la implementación de la inferencia por lotes a escala viene con su propio conjunto de desafíos, incluida la gestión del formato de entrada y las cuotas de trabajo, la orquestación de ejecuciones concurrentes y el manejo de tareas posteriores al procesamiento. Los desarrolladores necesitan un marco robusto para optimizar estas operaciones.
En esta publicación, presentamos una solución flexible y escalable que simplifica el flujo de trabajo de inferencia por lotes. Esta solución proporciona un enfoque altamente escalable para administrar sus necesidades de inferencia de lotes de FM, como generar integridades para millones de documentos o ejecutar tareas de evaluación o finalización personalizadas con grandes conjuntos de datos.
Descripción general de la solución
El siguiente diagrama detalla una descripción general del flujo de trabajo automatizado, que incluye tres fases principales: preprocesamiento de conjuntos de datos de entrada (por ejemplo, formato de inmediato), ejecución de trabajos de inferencia por lotes en paralelo y posterior al procesamiento para analizar las salidas del modelo.
Esta solución proporciona un marco flexible y escalable para simplificar la orquestación por lotes. Dada una simple entrada de configuración, la máquina de estado de paso de paso implementada en esta Kit de desarrollo de la nube de AWS (AWS CDK) Maneja de la pila del preprocesamiento del conjunto de datos, el lanzamiento de trabajos por lotes paralelos y el procesamiento posterior al proceso.
En nuestro caso de uso específico, utilizamos 2.2 millones de filas de datos del conjunto de datos de código abierto Sencillo. El conjunto de datos SimpleCot en Hugging Face es una colección de diversos ejemplos orientados a tareas diseñados para demostrar y entrenar el razonamiento de la cadena de pensamiento (cot) en los modelos de idiomas. Este conjunto de datos abarca una amplia gama de tipos de problemas, incluida la comprensión de lectura, el razonamiento matemático, la deducción lógica y las tareas de procesamiento del lenguaje natural (PNL). El conjunto de datos está estructurado con cada entrada que contiene una descripción de la tarea, la pregunta, la respuesta correcta y una explicación detallada del proceso de razonamiento.
El siguiente diagrama ilustra la arquitectura de la solución.
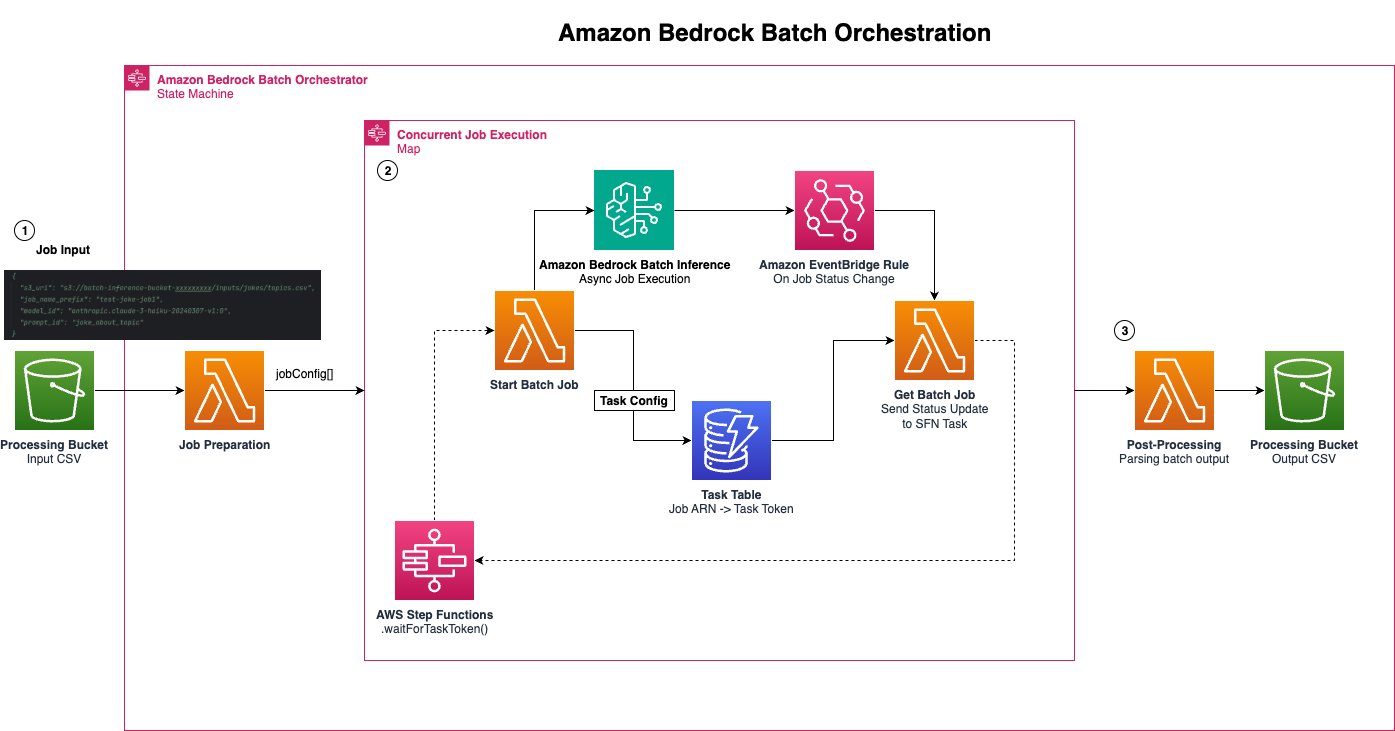
El patrón de orquestación de lotes de roca lotes de Amazon utiliza componentes escalables y sin servidor para cubrir las consideraciones arquitectónicas clave específicas para los flujos de trabajo de procesamiento por lotes:
- Formato de archivo y almacenamiento – Las entradas de trabajo deben estructurarse como archivos JSONL almacenados en un Servicio de almacenamiento simple de Amazon (Amazon S3) cubo, con cada línea que representa un solo registro de entrada que coincide con la estructura de solicitud de API para ese FM o proveedor. Por ejemplo, los modelos Claude de Anthrope tienen una estructura JSON diferente en comparación con Amazon Titan Text Increddings V2. También hay cuotas a considerar: al momento de la escritura, un mínimo de 1,000 y el máximo de 50,000 registros por lote. Puede solicitar un aumento de la cuota usando Cuotas de servicio basado en los requisitos de su caso de uso.
- Funciones de paso Máquina de estado -La orquestación de los trabajos asincrónicos y de larga duración requiere un sistema de flujo de control robusto. Nuestra arquitectura utiliza funciones de pasos para coordinar el proceso general, con Amazon Dynamodb Mantener el inventario de trabajos individuales y sus estados. Nuevamente, hay consideraciones de cuotas importantes: por ejemplo, la suma máxima de trabajos de inferencia por lotes en progreso y enviados utilizando un modelo base para Amazon Titan Text Increddings V2 es actualmente 20 por región AWS. Usando Estados de flujo de trabajo de mapaLas funciones de paso pueden ayudar a maximizar el rendimiento controlando el estado de envío de trabajo y el estado de finalización de monitoreo.
- Posprocesamiento – Finalmente, es probable que desee realizar algunos posprocesamiento de luz en las salidas por lotes (también archivos JSONL en Amazon S3) para analizar las respuestas y volver a la salida a la entrada original. Por ejemplo, al generar incrustaciones de texto, debe tener un mecanismo para asignar vectores de salida a su texto de origen. Estos configurables AWS Lambda Las funciones se activan como parte del flujo de trabajo de las funciones de paso después de que los resultados de lotes llegan a Amazon S3.
En las siguientes secciones, recorremos los pasos para implementar la pila AWS CDK en su entorno AWS.
Requisitos previos
Complete los siguientes pasos de requisito previo:
- Instale el nodo y npm.
- Instale el AWS CDK:
- Clone el repositorio de GitHub en su entorno de desarrollo local:
Implementar la solución
Instale los paquetes requeridos con el siguiente código:npm i
Revise el prompt_templates.py archivo y agregue una nueva plantilla de solicitud a prompt_id_to_template para su caso de uso deseado.
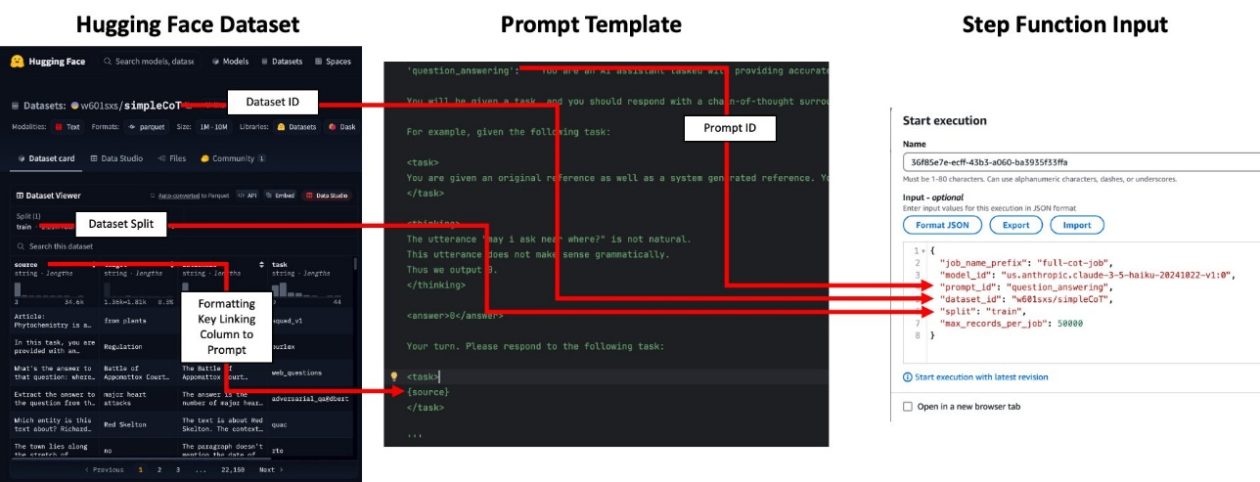
prompt_id_to_template es un dict donde la clave es la prompt_id (permitiéndole asociar un trabajo determinado con un mensaje particular). Las teclas de formateo en la plantilla de cadena de solicitud también deben existir en su archivo de entrada. Por ejemplo, considere la siguiente plantilla de solicitud:
Debe asegurarse de que su conjunto de datos de entrada tenga una columna para cada tecla de formato (por ejemplo, source en el código de ejemplo anterior).
Las plantillas de inmediato no se utilizan para incorporar trabajos basados en modelos. Deploy la pila AWS CDK con el siguiente código:npm run cdk deploy
Tome nota del AWS CloudFormation salidas que denotan los nombres de las funciones de cubo y paso de flujo de trabajo:
Estructura de entrada de trabajo
Como su conjunto de datos de entrada, puede usar una ID de conjunto de datos de abrazadera de abrazos o apuntar directamente a un conjunto de datos en Amazon S3 (los formatos CSV o parquet son compatibles al momento de la escritura). La fuente del conjunto de datos de entrada y el tipo de modelo (generación de texto o incrustación) dictan la estructura de la entrada de funciones de paso.
Conjunto de datos de la cara abrazada
Para un conjunto de datos de abrazadera de abrazo, haga referencia a una ID de conjunto de datos (por ejemplo, w601sxs/simpleCoT) y dividir (por ejemplo, train), y su conjunto de datos se extraerá directamente del centro de la cara abrazando.
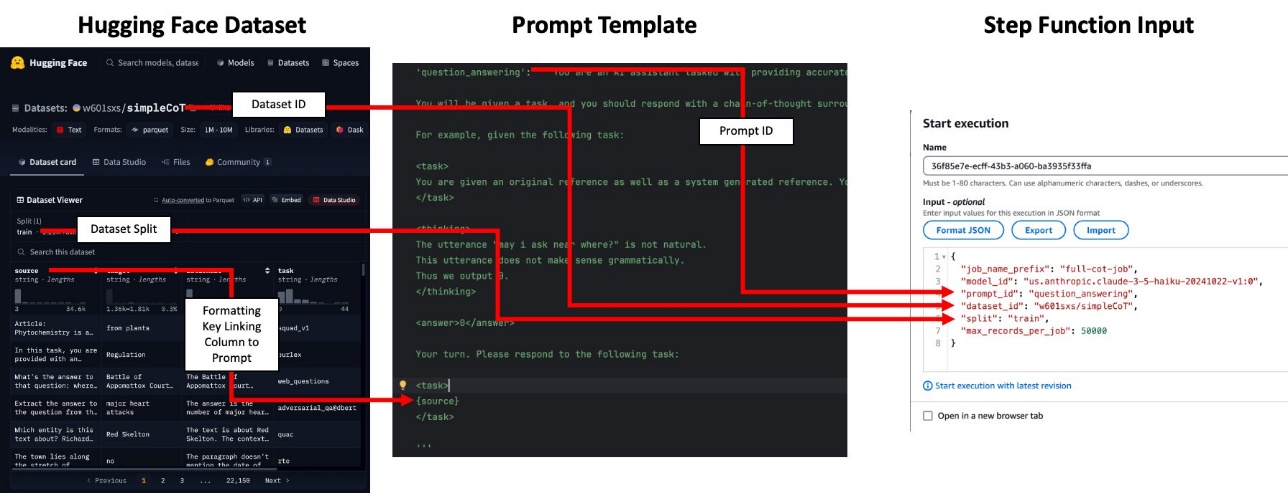
El question_answering plantilla de inmediato en prompt_templates.py tiene una clave de formato llamada source Para que coincida con el nombre de la columna apropiada en el conjunto de datos referenciado (consulte el ejemplo anterior). Utilizamos este aviso para generar la justificación y la respuesta para cada una de las 2.2 millones de filas en el conjunto de datos. Vea el siguiente código:
También tenemos claves opcionales para max_num_jobs (para limitar el número total de trabajos, que es útil para probar a menor escala) y max_records_per_batch.
Conjunto de datos de Amazon S3
Cargue un archivo CSV o parquet de entrada al cubo S3 y copie el URI S3. Por ejemplo:aws s3 cp topics.csv s3://batch-inference-bucket-<YOUR_ACCOUNT_ID>/inputs/jokes/topics.csv
Abra su máquina de estado de funciones de paso en la consola de funciones de paso y envíe una entrada con la siguiente estructura. Debes suministrar un s3_uri para conjuntos de datos S3.
Por ejemplo, para modelos antrópicos con una entrada de Amazon S3, use el siguiente código:
El prompt_id de joke_about_topic se mapea a una plantilla rápida en prompt_templates.pyque tiene una clave de formato para topicque debe ser una de las columnas en el archivo CSV de entrada.
Generar incrustaciones por lotes
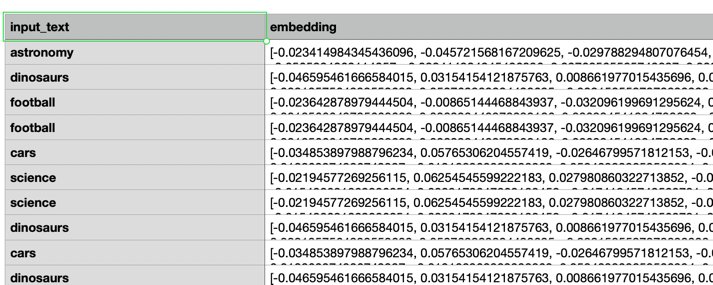
Para generar incrustaciones con un modelo como Amazon Titan Text Increddings V2, no necesita proporcionar un prompt_idpero debe asegurarse de que su archivo CSV de entrada tenga una columna llamada input_text Con el texto quieres incrustar. Por ejemplo:
FUNCIONES DE FUNCIONES DE PASO FLUMINGO
El siguiente diagrama muestra un ejemplo de una ejecución de flujo de trabajo de funciones de paso exitoso.
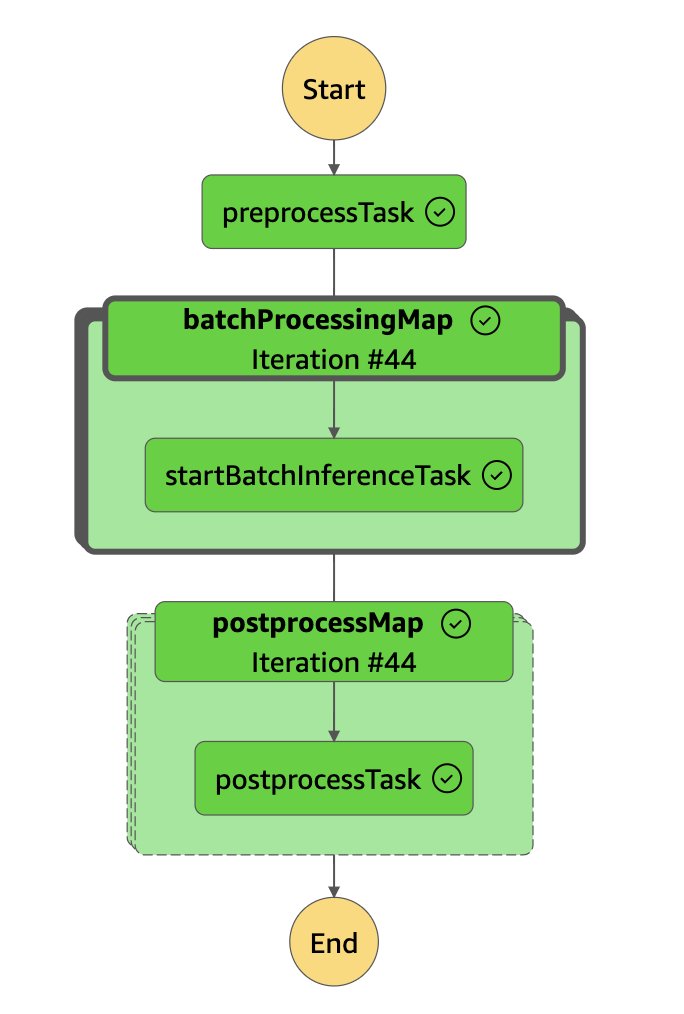
Cuando se inicia una máquina de estado de un paso, completa los siguientes pasos:
- Preprocesos de datos de entrada para preparar entradas de trabajo por lotes para su ID de modelo particular y plantilla de solicitud. El
BaseProcessorLa clase abstracta se puede extender rápidamente para otros proveedores de modelos, como Meta Llama 3 o Amazon Nova. - Orchestre trabajos por lotes de manera basada en eventos. Mantenemos un inventario interno de trabajos en una tabla DynamodB y lo mantenemos actualizado cuando Amazon Bedrock emite eventos relacionados con los cambios en el estado del trabajo. Estas actualizaciones se transmiten nuevamente a la función de paso utilizando el Espere la devolución de llamada de token de tareas Patrón de integración. Usando un mapa SFN, nos aseguramos de que la capacidad máxima de los trabajos concurrentes se mantenga hasta que se hayan procesado los registros.
- Ejecute el posprocesamiento concurrente de salidas por lotes para realizar algunas respuestas de modelo de análisis de luz y fusionar el modelo a los datos de entrada originales utilizando el récordid campo como una clave de unión. Los datos de salida dependen del tipo de modelo que use. Para los modelos basados en texto, la cadena de salida estará en una nueva columna llamada
response.
Monitoree su máquina de estado mientras ejecuta los trabajos. El número máximo de trabajos concurrentes está controlado por una variable de contexto CDK de AWS en cdk.json (llave: maxConcurrentJobs). Las rutas a sus archivos parquet resultantes se agregarán en las salidas de la ejecución.
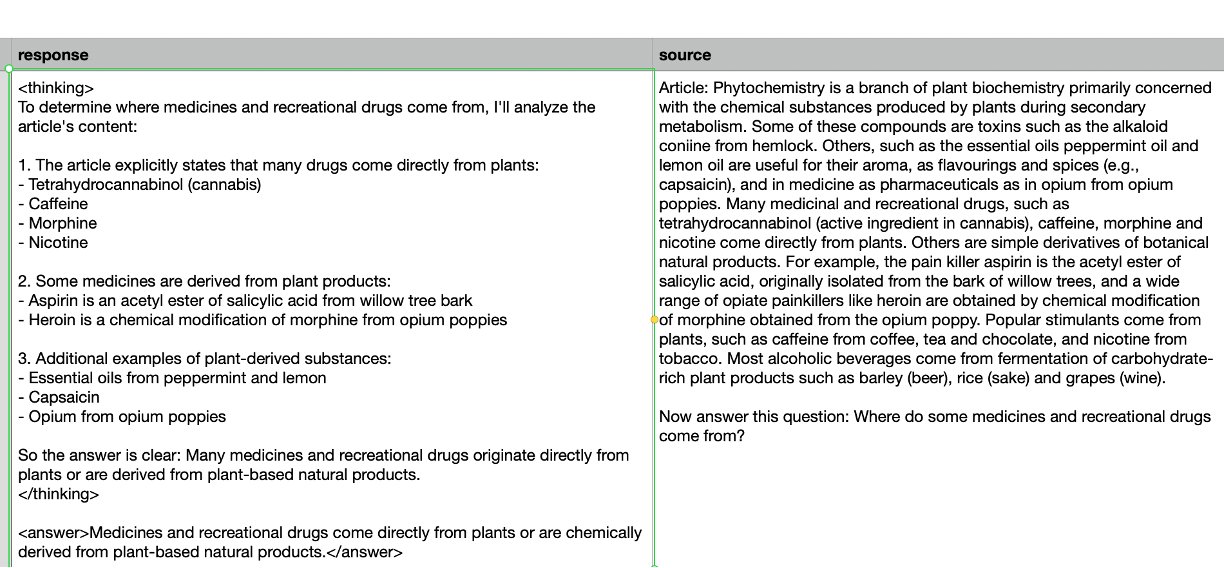
Los archivos de parquet de salida contendrán las mismas columnas que su archivo de entrada junto con las respuestas generadas.
Para los modelos de generación de texto, la cadena de salida estará en una nueva columna llamada responsecomo se muestra en la siguiente captura de pantalla de una salida de muestra.
Para los modelos de incrustación, la salida (lista de flotadores) estará en una nueva columna llamada embeddingcomo se muestra en la siguiente captura de pantalla.
No hay SLA garantizados para la API de inferencia por lotes. Runtimes variará según la demanda del modelo deseado en el momento de su solicitud. Por ejemplo, para procesar los 2.2 millones de registros en el conjunto de datos SimpleCot, la ejecución se extendió a través de 45 trabajos de procesamiento individual, con un máximo de 20 trabajos concurrentes en un momento dado. En nuestro experimento con Claude Haiku 3.5 de Anthrope en el us-east-1 Región, cada ejecución de trabajo individual tomó un promedio de 9 horas, para un tiempo de procesamiento total de extremo a extremo de aproximadamente 27 horas.
Limpiar
Para evitar incurrir en costos adicionales, puede limpiar los recursos de la pila ejecutando cdk destroy.
Conclusión
En esta publicación, describimos una arquitectura sin servidor para realizar un procesamiento por lotes a gran escala utilizando la inferencia de lotes de roca madre de Amazon. Exploramos el uso de la solución para varios casos de uso, incluido el etiquetado de datos a gran escala y la generación de incrustaciones. También puede generar una gran cantidad de datos sintéticos de un modelo de maestro utilizado para capacitar a un modelo de alumno como parte del proceso de destilación del modelo.
La solución está disponible públicamente en el Repositorio de Github. No podemos esperar a ver cómo pone esta arquitectura para que funcione para sus casos de uso.
Sobre los autores
 Swagat Kulkarni es un arquitecto de soluciones senior en AWS y un practicante de IA generativo activo. Le apasiona ayudar a los clientes a resolver desafíos del mundo real utilizando servicios nativos de nube y aprendizaje automático. Con una fuerte experiencia en la impulso de transformación digital en diversas industrias, Swagat ha ofrecido soluciones impactantes que permiten la innovación y la escala. Fuera del trabajo, le gusta viajar, leer y cocinar.
Evan Diewald es un ingeniero de datos de datos y máquina de datos con servicios profesionales de AWS, donde ayuda a los clientes de AWS a desarrollar e implementar soluciones de ML en una variedad de verticales de la industria. Antes de unirse a AWS, recibió una EM de la Universidad Carnegie Mellon, donde realizó investigaciones en la intersección de la fabricación avanzada y la IA. Fuera del trabajo, disfruta del ciclismo de montaña y la escalada en roca.
Shreyas subramaniano es un científico principal de datos y ayuda a los clientes mediante el uso de IA generativa y el aprendizaje profundo para resolver sus desafíos comerciales utilizando servicios de AWS como Amazon Bedrock y AgentCore. El Dr. Subramanian contribuye a la investigación de vanguardia en el aprendizaje profundo, la IA agente, los modelos de base y las técnicas de optimización con varios libros, documentos y patentes a su nombre. En su papel actual en Amazon, el Dr. Subramanian trabaja con varios líderes científicos y equipos de investigación dentro y fuera de Amazon, lo que ayuda a guiar a los clientes a aprovechar mejor los algoritmos y técnicas de vanguardia para resolver problemas críticos comerciales. Fuera de AWS, el Dr. Subramanian es un revisor experto para documentos de IA y financiación a través de organizaciones como Neurips, ICML, ICLR, NASA y NSF.