
¿Qué es el olvido catastrófico en los modelos fundamentales?
Los modelos de base se destacan en diversos dominios, pero son en gran medida estáticos una vez desplegados. Ajustar las nuevas tareas a menudo presenta olvido catastrófico—La pérdida de capacidades previamente aprendidas. Esta limitación plantea una barrera para construir agentes de IA de larga vida, mejorando continuamente.
¿Por qué el aprendizaje de refuerzo en línea se olvida menos que el ajuste superior supervisado?
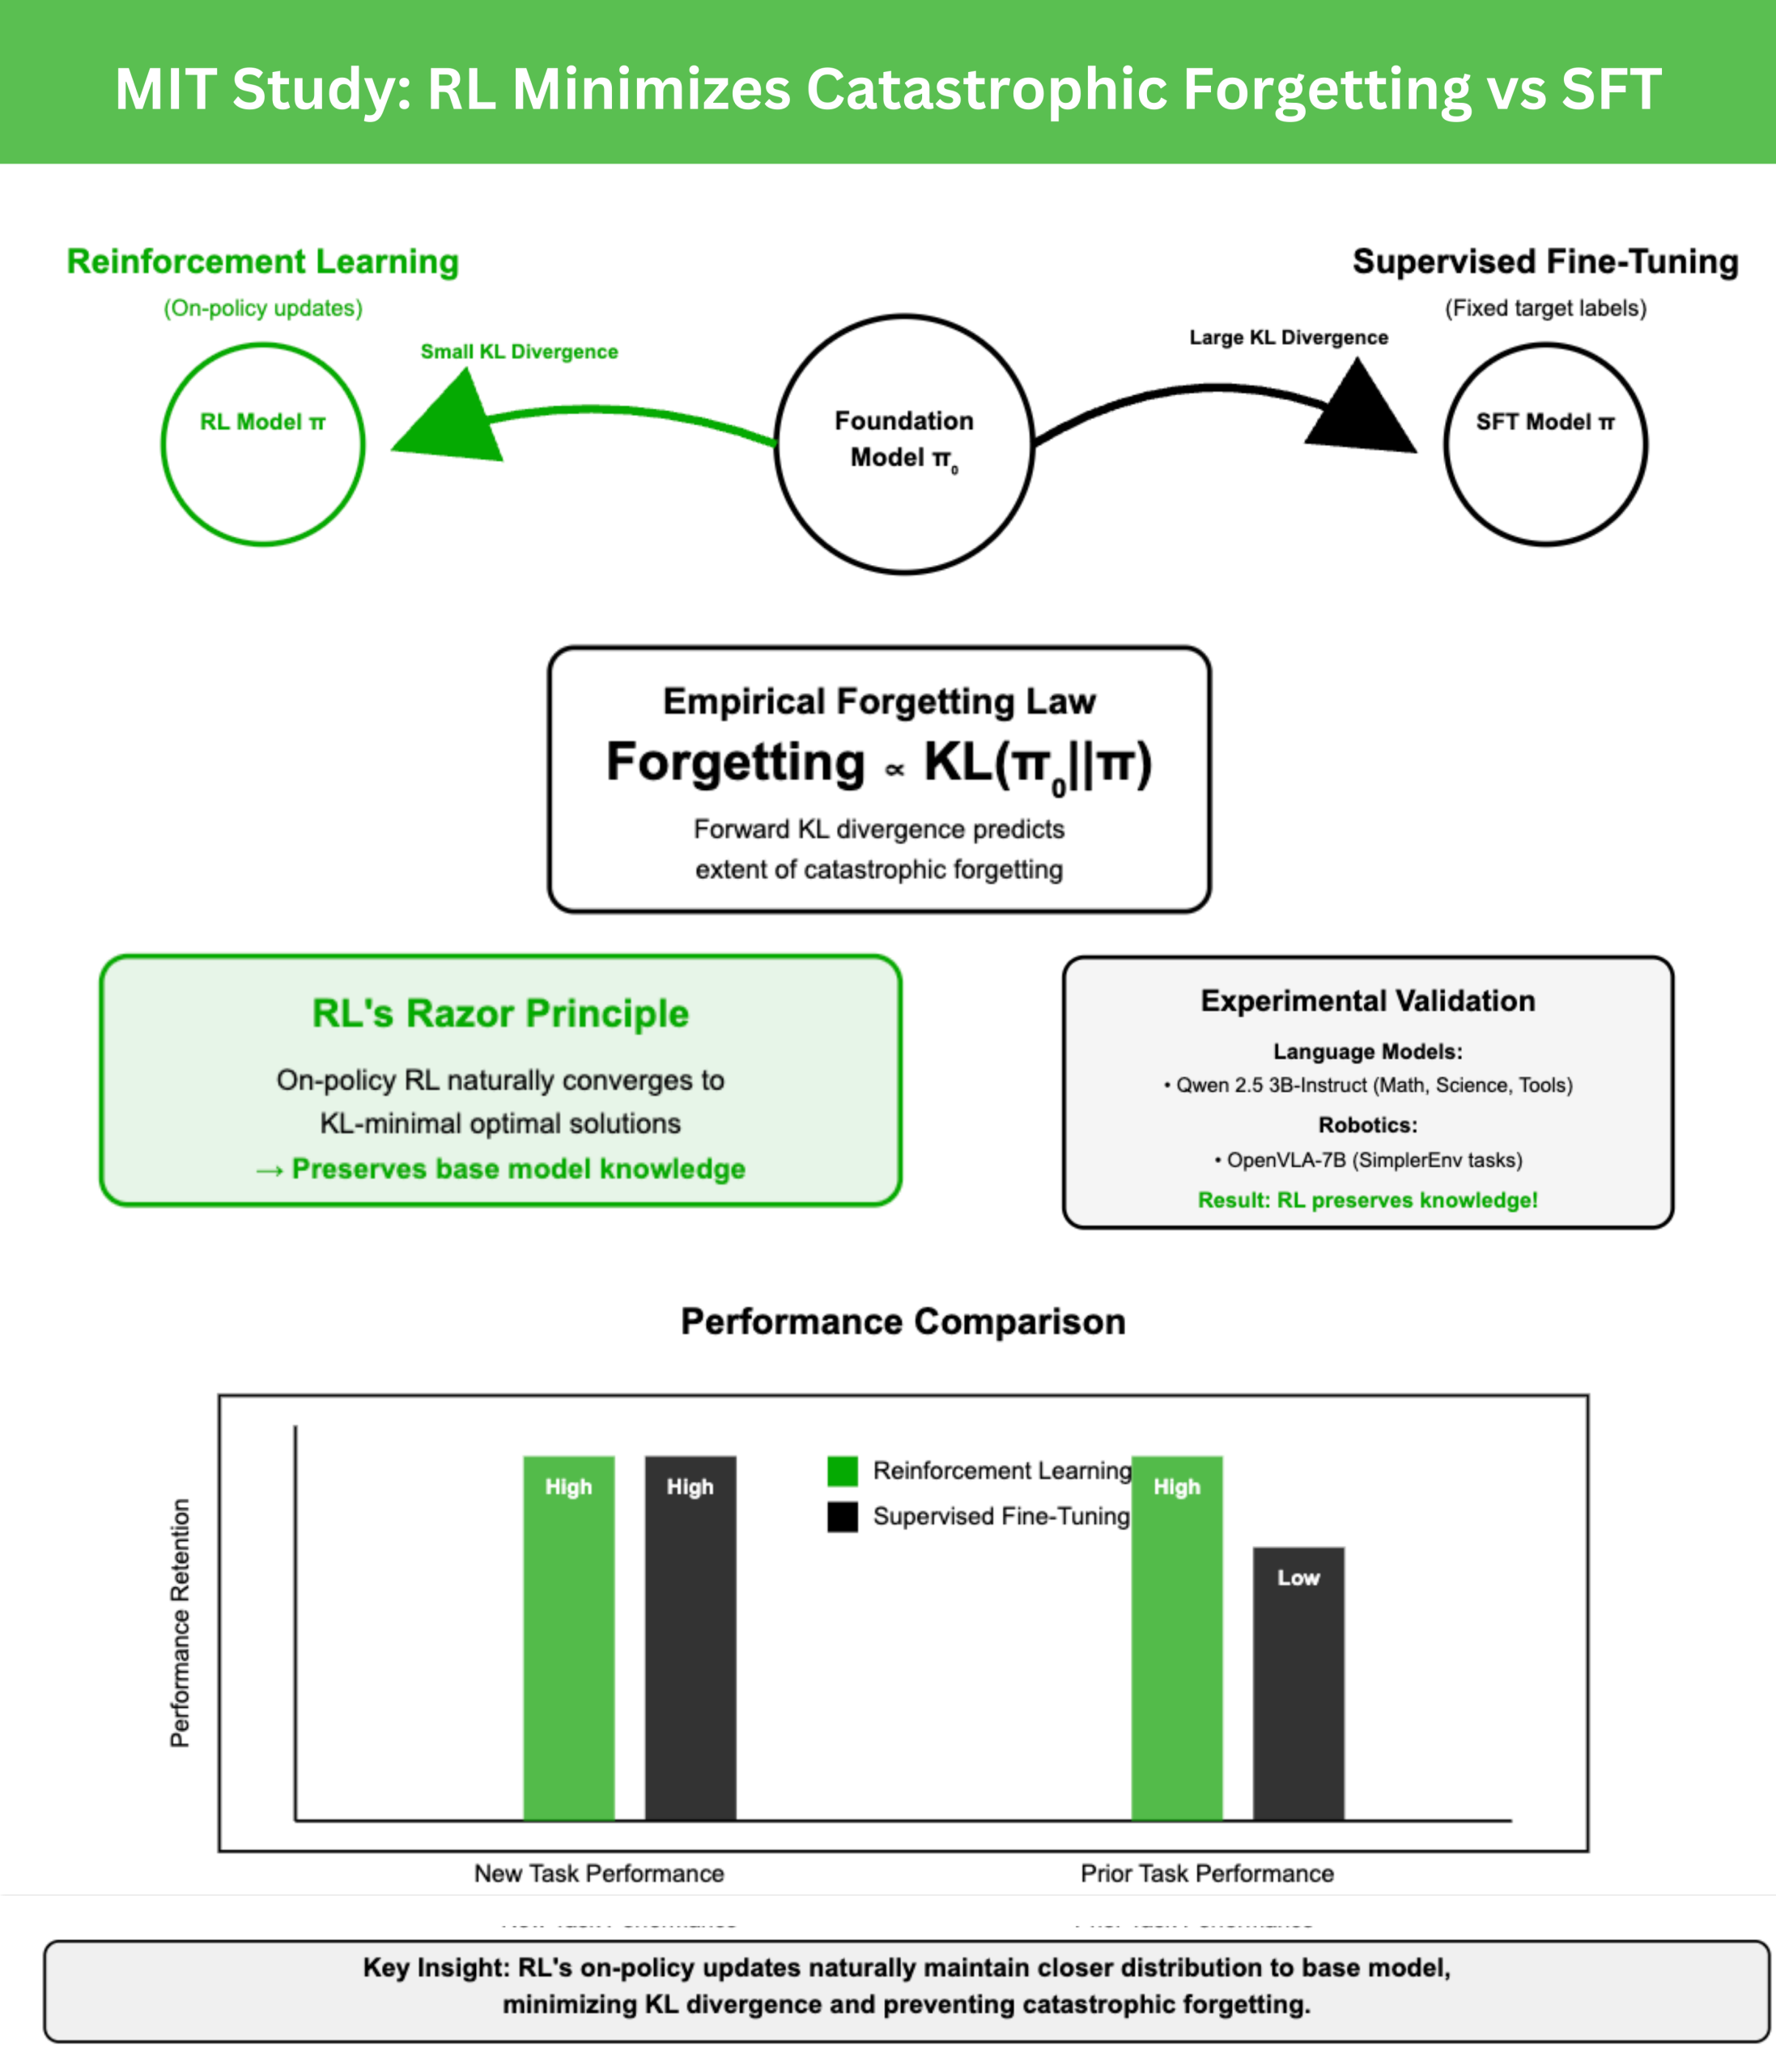
Se compara un nuevo estudio del MIT Aprendizaje de refuerzo (RL) y ajuste de fino supervisado (SFT). Ambos pueden lograr un alto rendimiento en nuevas tareas, pero SFT tiende a sobrescribir habilidades previas. RL, por el contrario, los conserva. La clave radica en cómo cada método cambia la distribución de salida del modelo en relación con la política base.

¿Cómo se puede medir el olvido?
El equipo de investigación propone una ley empírica de olvido:
Olvidar∝kl (π0 ∣π)
donde π0 es el modelo base y π es el modelo ajustado. El Divergencia KL hacia adelante KLmedido en la nueva tarea, predice fuertemente el alcance del olvido. Esto hace que olvidar cuantificable sin necesidad de datos de tareas anteriores.
¿Qué revelan los experimentos en modelos de idiomas grandes?
Usando el instructo QWen 2.5 3B como modelo base, el ajuste fino se realizó en:
- Razonamiento matemático (Open-Relesterer-Zero),
- Preguntas y respuestas de la ciencia (Subconjunto sciknoweval),
- Uso de la herramienta (Toolalpaca).
El rendimiento se evaluó en puntos de referencia anteriores como HellaSwag, MMLU, Teryfulqa y Humaneval. Los resultados mostraron que RL mejoró la precisión de la nueva tarea mientras mantiene estable la precisión de la tarea anterior, mientras que SFT consistentemente sacrificó el conocimiento previo.
¿Cómo se compara RL con SFT en tareas de robótica?
En experimentos de control robótico con OpenVLA-7B ajustado en Sencillo Escenarios de selección y lugar, la adaptación RL mantuvo habilidades generales de manipulación en todas las tareas. SFT, aunque exitoso en la nueva tarea, degradó las habilidades de manipulación previa, que ilustra el conservadurismo de RL para preservar el conocimiento.
¿Qué ideas provienen del estudio paritymnist?
Para aislar mecanismos, el equipo de investigación introdujo un problema de juguete, Paritymnist. Aquí, RL y SFT alcanzaron la alta precisión de la nueva tarea, pero SFT indujo más aguas disminuyendo en el punto de referencia auxiliar de FashionMnist. Crucialmente, el olvido de la divergencia de KL reveló una sola curva predictiva, validando a KL como factor de gobierno.
¿Por qué son importantes las actualizaciones de la política?
Las muestras de RL en la política de las propias salidas del modelo, rehaciéndolas incrementalmente por recompensa. Este proceso limita el aprendizaje a las distribuciones que ya están cerca del modelo base. SFT, en contraste, optimiza contra etiquetas fijas que pueden estar arbitrariamente distantes. El análisis teórico muestra que los gradientes de políticas convergen a Soluciones óptimas de KL-Minimalformalizando la ventaja de RL.
¿Son suficientes otras explicaciones?
El equipo de investigación probó alternativas: cambios en el espacio de peso, deriva de representación oculta, escasez de actualizaciones y métricas de distribución alternativas (KL inversa, variación total, distancia de L2). Ninguno coincidió con la fuerza predictiva de Divergencia KL hacia adelante KLreforzar esa cercanía distributiva es el factor crítico.
¿Cuáles son las implicaciones más amplias?
- Evaluación: El post-entrenamiento debe considerar el servicio de servicio KL, no solo la precisión de la tarea.
- Métodos híbridos: Combinar la eficiencia de SFT con minimización explícita de KL podría producir compensaciones óptimas.
- Aprendizaje continuo: Razor de RL ofrece un criterio medible para diseñar agentes adaptativos que aprendan nuevas habilidades sin borrar las antiguas.
Conclusión
La investigación del MIT reformulan el olvido catastrófico como un problema de distribución gobernado por Divergencia KL hacia adelante KL. El aprendizaje de refuerzo se olvida menos porque sus actualizaciones en la política son un sesgo naturalmente hacia Soluciones KL-Minimal. Este principio—Razor de RL—Prota una explicación de la robustez de RL y una hoja de ruta para desarrollar métodos posteriores a la capacitación que respalden el aprendizaje permanente en los modelos de fundaciones.
Control de llave
- El aprendizaje de refuerzo (RL) conserva el conocimiento previo mejor que Ajuste de fino supervisado (SFT): Incluso cuando ambos logran la misma precisión en nuevas tareas, RL conserva las capacidades previas mientras que SFT las borra.
- El olvido es predecible por la divergencia de KL: El grado de olvido catastrófico se correlaciona fuertemente con la divergencia KL delantera entre la política de ajuste y base, medido en la nueva tarea.
- Principio de navaja de afeitar de RL: RL en política converge a Soluciones KL-Minimalasegurar que las actualizaciones permanezcan cerca del modelo base y reduciendo el olvido.
- Validación empírica en todos los dominios: Experimentos sobre LLMS (Matemáticas, preguntas y respuestas de ciencias, uso de herramientas) y las tareas de robótica confirman la robustez de RL contra el olvido, mientras que SFT comercia constantemente con el conocimiento antiguo por el rendimiento de la nueva tarea.
- Los experimentos controlados confirman la generalidad: En el entorno de juguete paritymnist, tanto RL como SFT mostraron olvido alineado con la divergencia de KL, lo que demuestra que el principio es más allá de los modelos a gran escala.
- Eje de diseño futuro para post-entrenamiento: Los algoritmos deben evaluarse no solo por la precisión de la nueva tarea sino también por cuán conservadoramente cambian de distribuciones en el espacio KL, abriendo vías para los métodos híbridos RL-SFT.
Mira el PAPEL y Página del proyecto. No dude en ver nuestro Página de Github para tutoriales, códigos y cuadernos. Además, siéntete libre de seguirnos Gorjeo Y no olvides unirte a nuestro Subreddit de 100k+ ml y suscribirse a Nuestro boletín.
Michal Sutter es un profesional de la ciencia de datos con una Maestría en Ciencias en Ciencias de Datos de la Universidad de Padova. Con una base sólida en análisis estadístico, aprendizaje automático e ingeniería de datos, Michal se destaca por transformar conjuntos de datos complejos en ideas procesables.