
utilice el descenso de gradiente para encontrar los valores óptimos de sus pesos. La regresión lineal, la regresión logística, las redes neuronales y los grandes modelos de lenguaje se basan en este principio. En los artículos anteriores, utilizamos un descenso de gradiente simple porque es más fácil de mostrar y de entender.
El mismo principio también aparece a escala en los grandes modelos lingüísticos modernos, donde el entrenamiento requiere ajustar millones o miles de millones de parámetros.
Sin embargo, el entrenamiento real rara vez utiliza la versión básica. A menudo es demasiado lento o demasiado inestable. Los sistemas modernos utilizan variantes de descenso de gradiente que mejoran la velocidad, la estabilidad o la convergencia.
En este artículo extra nos centramos en estas variantes. Analizamos por qué existen, qué problema resuelven y cómo cambian la regla de actualización. No utilizamos un conjunto de datos aquí. Usamos una variable y una función, solo para hacer visible el comportamiento. El objetivo es mostrar el movimiento, no entrenar un modelo.
1. Descenso de gradiente y mecanismo de actualización
1.1 Configuración del problema
Para hacer visibles estas ideas, no utilizaremos aquí un conjunto de datos, porque los conjuntos de datos introducen ruido y dificultan la observación directa del comportamiento. En su lugar, usaremos una única función:
f(x) = (x – 2)²
Comenzamos en x = 4 y el gradiente es:
gradiente = 2*(x – 2)
Esta sencilla configuración elimina las distracciones. El objetivo no es entrenar un modelo, sino entender cómo las diferentes reglas de optimización cambian el movimiento hacia el mínimo.
1.2 La estructura detrás de cada actualización
Cada método de optimización que sigue en este artículo se basa en el mismo bucle, incluso cuando la lógica interna se vuelve más sofisticada.
Primero, leemos el valor actual de x. Luego, calculamos el gradiente con la expresión 2*(x – 2). Finalmente, actualizamos x según la regla específica definida por la variante elegida.
El destino sigue siendo el mismo y el gradiente siempre apunta en la dirección correcta, pero la forma en que nos movemos en esa dirección cambia de un método a otro. Este cambio de movimiento es la esencia de cada variante.
1.3 Descenso de gradiente básico como línea de base
El descenso de gradiente básico aplica una actualización directa basada en el gradiente actual y una tasa de aprendizaje fija:
x = x – lr * 2*(x – 2)
Esta es la forma más intuitiva de aprendizaje porque la regla de actualización es fácil de entender y de implementar. El método avanza constantemente hacia el mínimo, pero a menudo lo hace lentamente y puede tener dificultades cuando la tasa de aprendizaje no se elige con cuidado. Representa la base sobre la que se construyen todas las demás variantes.
2. Disminución de la tasa de aprendizaje
Learning Rate Decay no cambia la regla de actualización en sí. Cambia el tamaño de la tasa de aprendizaje entre iteraciones para que la optimización se vuelva más estable cerca del mínimo. Los pasos grandes ayudan cuando x está lejos del objetivo, pero los pasos más pequeños son más seguros cuando x se acerca al mínimo. El decaimiento reduce el riesgo de sobrepasarse y produce un aterrizaje más suave.
No existe una única fórmula de descomposición. En la práctica existen varios horarios:
decaimiento exponencial decaimiento inverso (el que se muestra en la hoja de cálculo) decaimiento basado en pasos decaimiento lineal coseno o programas cíclicos
Todos ellos siguen la misma idea: la tasa de aprendizaje se reduce con el tiempo, pero el patrón depende del horario elegido.
En el ejemplo de la hoja de cálculo, la fórmula de descomposición es la forma inversa:
lr_t = lr / (1 + decaimiento * iteración)
Con la regla de actualización:
x = x – lr_t * 2*(x – 2)
Este programa comienza con la tasa de aprendizaje completa en la primera iteración y luego la reduce gradualmente. Al comienzo de la optimización, el tamaño del paso es lo suficientemente grande como para moverse rápidamente. A medida que x se acerca al mínimo, la tasa de aprendizaje se reduce, estabilizando la actualización y evitando oscilaciones.
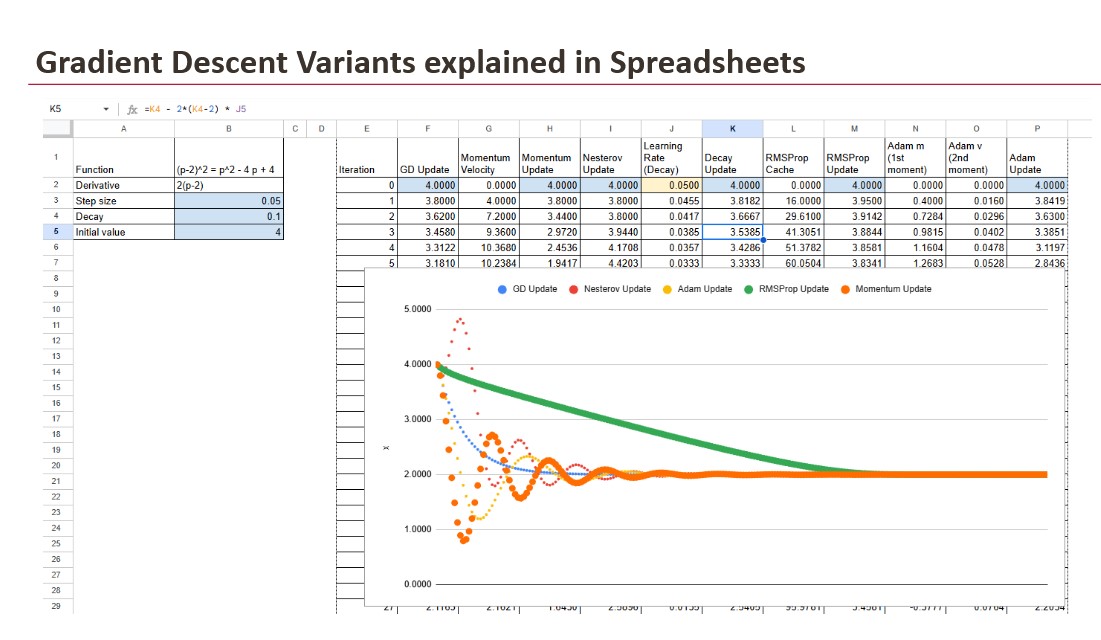
En el gráfico, ambas curvas comienzan en x = 4. La versión de tasa de aprendizaje fija se mueve más rápido al principio pero se acerca al mínimo con menos estabilidad. La versión en decadencia se mueve más lentamente pero permanece controlada. Esto confirma que la decadencia no cambia la dirección de la actualización. Solo cambia el tamaño del paso y ese cambio afecta el comportamiento.

3. Métodos de impulso
El descenso de gradiente se mueve en la dirección correcta, pero puede ser lento en regiones planas. Los métodos de impulso solucionan este problema añadiendo inercia a la actualización.
Acumulan dirección con el tiempo, lo que crea un progreso más rápido cuando el gradiente se mantiene constante. Esta familia incluye Momentum estándar, que aumenta la velocidad, y Nesterov Momentum, que anticipa la siguiente posición para reducir el exceso.
3.1 Momento estándar
El impulso estándar introduce la idea de inercia en el proceso de aprendizaje. En lugar de reaccionar sólo al gradiente actual, la actualización mantiene una memoria de los gradientes anteriores en forma de una variable de velocidad:
velocidad = 0.9velocidad + 2(x – 2)
x = x – lr * velocidad
Este enfoque acelera el aprendizaje cuando el gradiente permanece constante durante múltiples iteraciones, lo que resulta especialmente útil en regiones planas o poco profundas.
Sin embargo, la misma inercia que genera velocidad también puede llevar a sobrepasar el mínimo, lo que crea oscilaciones alrededor del objetivo.
3.2 El impulso de Nésterov
Nesterov Momentum es un refinamiento del método anterior. En lugar de actualizar la velocidad solo en la posición actual, el método primero estima dónde estará la siguiente posición y luego evalúa el gradiente en esa ubicación anticipada:
velocidad = 0.9velocidad + 2((x – 0.9*velocidad) – 2)
x = x – lr * velocidad
Este comportamiento de anticipación reduce el efecto de sobreimpulso que puede aparecer en el Momentum normal, lo que conduce a un acercamiento más suave al mínimo y a menos oscilaciones. Mantiene el beneficio de la velocidad al tiempo que introduce un sentido de dirección más cuidadoso.
4. Métodos de gradiente adaptativo
Los métodos de gradiente adaptativo ajustan la actualización según la información recopilada durante el entrenamiento. En lugar de utilizar una tasa de aprendizaje fija o depender únicamente del gradiente actual, estos métodos se adaptan a la escala y el comportamiento de los gradientes recientes.
El objetivo es reducir el tamaño del paso cuando las pendientes se vuelven inestables y permitir un progreso normal cuando la superficie es más predecible. Este enfoque es útil en redes profundas o superficies de pérdida irregulares, donde el gradiente puede cambiar en magnitud de un paso al siguiente.
4.1 RMSProp (propagación cuadrática media)
RMSProp significa Propagación de raíz cuadrática media. Mantiene un promedio móvil de gradientes cuadrados en un caché, y este valor influye en la agresividad con la que se aplica la actualización:
caché = 0,9 caché + (2(x – 2))²
x = x – lr / sqrt(caché) * 2*(x – 2)
La caché aumenta cuando los gradientes son inestables, lo que reduce el tamaño de la actualización. Cuando los gradientes son pequeños, la caché crece más lentamente y la actualización se mantiene cerca del paso normal. Esto hace que RMSProp sea efectivo en situaciones donde la escala de gradiente no es consistente, lo cual es común en los modelos de aprendizaje profundo.
4.2 Adán (estimación del momento adaptativo)
Adam significa Estimación del momento adaptativo. Combina la idea de Momentum con el comportamiento adaptativo de RMSProp. Mantiene un promedio móvil de gradientes para capturar la dirección y un promedio móvil de gradientes cuadrados para capturar la escala:
metro = 0,9m + 0,1(2(x – 2)) v = 0,999v + 0,001(2(x – 2))²
x = x – lr * m / raíz cuadrada (v)
La variable m se comporta como la velocidad en impulso y la variable v se comporta como el caché en RMSProp. Adam actualiza ambos valores en cada iteración, lo que le permite acelerar cuando el progreso es claro y reducir el paso cuando el gradiente se vuelve inestable. Este equilibrio entre velocidad y control es lo que convierte a Adam en una opción estándar en el entrenamiento de redes neuronales.
4.3 Otros métodos adaptativos
Adam y RMSProp son los métodos adaptativos más comunes, pero no son los únicos. Existen varios métodos relacionados, cada uno con un objetivo específico:
AdaGrad ajusta la tasa de aprendizaje en función del historial completo de gradientes cuadrados, pero la tasa puede reducirse demasiado rápido. AdaDelta modifica AdaGrad limitando cuánto afecta el gradiente histórico a la actualización. Adamax utiliza la norma infinita y puede ser más estable para gradientes muy grandes. Nadam añade a Adam un comportamiento de anticipación al estilo Nesterov. RAdam intenta estabilizar a Adam en la fase inicial del entrenamiento. AdamW separa la caída de peso de la actualización de gradiente y se recomienda en muchos marcos modernos.
Estos métodos siguen la misma idea que RMSProp y Adam: adaptar la actualización al comportamiento de los gradientes. Representan refinamientos o extensiones de los conceptos presentados anteriormente y son parte de la misma familia más amplia de algoritmos de optimización adaptativa.
Conclusión
Todos los métodos de este artículo apuntan al mismo objetivo: mover x hacia el mínimo. La diferencia es el camino. Gradient Descent proporciona la regla básica. El impulso añade velocidad y Nesterov mejora el control. RMSProp adapta el paso a la escala de gradiente. Adam combina estas ideas y Learning Rate Decay ajusta el tamaño del paso con el tiempo.
Cada método resuelve una limitación específica del anterior. Ninguno de ellos reemplaza a la línea de base. Lo extienden. En la práctica, la optimización no es una regla, sino un conjunto de mecanismos que funcionan juntos.
El objetivo sigue siendo el mismo. El movimiento se vuelve más efectivo.