
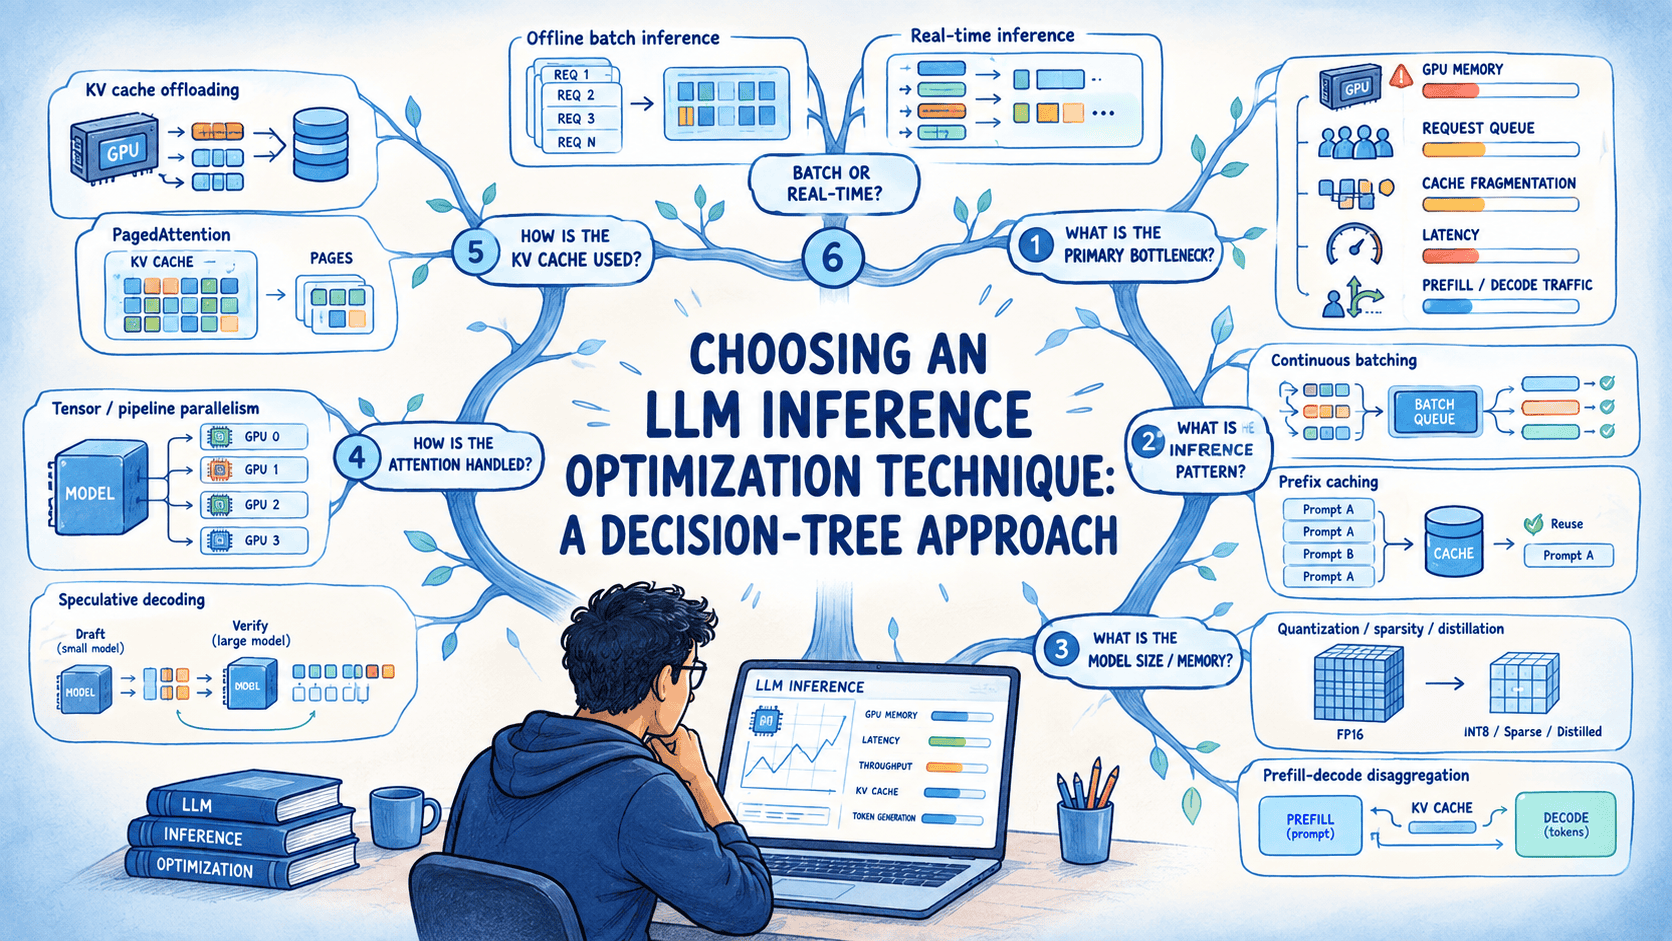
En este artículo, aprenderá cómo hacer coincidir una técnica de optimización de inferencia de LLM con el cuello de botella real de su carga de trabajo mediante un árbol de decisión de seis preguntas.
Los temas que cubriremos incluyen:
Lo que cada técnica importante de optimización de inferencias, desde la cuantificación hasta la desagregación previa al llenado y la decodificación, supone sobre su carga de trabajo. Cómo trabajar a través de un árbol de decisiones que lo encamine hacia la técnica correcta según su modelo y tráfico. Cómo se comparan las técnicas en cuanto a compensaciones y qué síntomas muestran que una técnica elegida no está funcionando.
Introducción
La inferencia LLM se vuelve lenta y costosa a medida que crece el tráfico. Las solicitudes se ponen en cola detrás de largas generaciones, la memoria de la GPU se llena con un estado de atención en caché y el hardware pasa gran parte de su tiempo esperando lecturas de memoria.
La optimización de la inferencia es el conjunto de técnicas que ayudan aquí. Algunas técnicas se centran en la memoria, otras en la computación y otras en cómo se programan las solicitudes entre sí. Cada técnica supone algo específico acerca de su carga de trabajo, por lo que la elección correcta depende de qué suposiciones se aplican a la suya. Este artículo cubre:
Lo que supone cada técnica importante de optimización de inferencias sobre su carga de trabajo. Un árbol de decisiones que lo dirige a una técnica. Cómo se comparan las técnicas en cuanto a latencia, rendimiento y costo de implementación. Los síntomas que muestran que una técnica no funciona.
Empezamos con lo que supone cada técnica.
Lo que supone cada técnica de optimización de la inferencia
La inferencia LLM tiene muchas técnicas de optimización, pero cada una aborda un tipo diferente de cuello de botella. Antes de utilizar uno, es útil comprender para qué carga de trabajo está diseñado.
Técnica Lo que supone Cuantización/escasez/destilación El modelo en sí es demasiado grande para el hardware o el presupuesto de latencia, y reducirlo merece cierto riesgo de precisión Almacenamiento en caché de prefijos Muchas solicitudes comparten una secuencia inicial idéntica de tokens, por lo que volver a calcular ese prefijo es un trabajo desperdiciado Procesamiento por lotes continuo (en vuelo) Las solicitudes llegan simultáneamente con longitudes de salida impredecibles, y esperar a que llegue el más lento de un lote desperdicia la memoria caché de GPU PagedAttention KV está fragmentada o sobreaprovisionado, limitando el tamaño del lote por debajo de lo que el hardware podría contener de otro modo Decodificación especulativa La decodificación es el cuello de botella, los tokens se generan uno a la vez y un modelo borrador más barato puede adivinar varios de ellos correctamente Desagregación de precarga y decodificación El precarga y la decodificación compiten por la misma GPU, y esa contienda está perjudicando tanto el tiempo hasta el primer token como la latencia entre tokens a la vez Paralelismo tensor/canalización El modelo no cabe en un solo dispositivo La memoria o el cómputo por dispositivo es el límite del rendimiento. Descarga de caché KV. Las entradas de caché útiles se están eliminando demasiado pronto porque la memoria de la GPU no puede contener todo lo que desea conservar. Inferencia por lotes sin conexión. Las solicitudes no necesitan una respuesta interactiva y el rendimiento total supera la latencia por solicitud.
Elija la técnica según el cuello de botella de su carga de trabajo para evitar complejidades innecesarias.
Trabajar a través de un árbol de decisiones para elegir una técnica
El árbol siguiente tiene seis preguntas ramificadas. Cada uno reduce el campo en función de una propiedad específica de su modelo o su tráfico. Cada pregunta termina de la misma manera: una respuesta directa si la condición se cumple y un puntero a la siguiente pregunta si no se cumple.
Pregunta 1: ¿El modelo se ajusta cómodamente al hardware de destino?
Antes de pasar a la pila de servicio, compruebe si el modelo en sí es el problema. Un modelo que apenas cabe en la memoria de la GPU casi no deja espacio para el caché KV, lo que limita el tamaño de su lote sin importar qué tan bueno sea su programador.
Si el modelo es demasiado grande o la inferencia está vinculada al cálculo incluso en un tamaño de lote uno, comience con la compresión a nivel de modelo:
La cuantificación reduce la precisión de los pesos y activaciones. La escasez estructurada elimina pesos menos importantes para reducir el cálculo. La destilación entrena un modelo más pequeño para imitar un modelo más grande.
Estas técnicas son en su mayoría independientes de la pila de servicio y es posible que desee considerarlas primero porque determinan cuánta capacidad de hardware queda.
Si el modelo ya cabe y tiene espacio libre, pase a la Pregunta 2.
Pregunta 2: ¿Sus solicitudes comparten una estructura de avisos repetidos?
Las aplicaciones de chat reenvían el historial de conversaciones completo en cada turno. Los marcos de agentes reutilizan el mismo mensaje del sistema en miles de llamadas. Las canalizaciones de generación aumentada de recuperación (RAG) a menudo anteponen las mismas instrucciones a diferentes contextos recuperados.
Si una parte significativa de su tráfico tiene un prefijo idéntico, ya sea un aviso del sistema o un historial de chat en crecimiento, el almacenamiento en caché de prefijos es la técnica de mayor influencia disponible. Omite volver a calcular la caché KV para los tokens que el modelo ya ha procesado, y las ganancias aumentan a medida que las conversaciones se hacen más largas.
⚠️ El almacenamiento en caché de prefijos solo funciona cuando el prefijo compartido coincide exactamente, carácter por carácter. Coloque el contenido estable y reutilizable primero y el contenido variable al final del mensaje.
Si sus indicaciones son en su mayoría únicas y tienen poca estructura compartida, pase a la Pregunta 3.
Pregunta 3: ¿Llegan solicitudes al mismo tiempo con longitudes de salida variables?
Un chatbot de soporte que devuelve una respuesta de una frase y un asistente de código que devuelve cuatrocientas líneas rara vez terminan al mismo tiempo, incluso si comenzaron juntos. En el método de procesamiento por lotes ingenuo, todo el lote espera la solicitud más lenta.
Si su tráfico mezcla generaciones cortas y largas y llega en ráfagas superpuestas, el procesamiento por lotes continuo soluciona el tiempo de inactividad que esto genera. Las secuencias finalizadas abandonan el lote inmediatamente, lo que permite que se inicien nuevas solicitudes sin esperar un límite de lote. La mayoría de los motores de servicio habilitan esto de forma predeterminada.
Si su tráfico ya está bien distribuido y el tiempo de inactividad de la GPU no es un problema, pase a la Pregunta 4.
Pregunta 4: ¿La fragmentación de la caché de KV limita el tamaño del lote?
Algunos motores reservan un bloque de memoria fijo y contiguo por solicitud dimensionado para la máxima longitud de secuencia posible, incluso cuando la mayoría de las solicitudes son mucho más cortas. Ese espacio reservado no se utiliza durante la vida de la solicitud y bloquea el uso de otras solicitudes.
Si la caché KV desperdicia memoria o limita el tamaño del lote, PagedAttention puede ayudar. Divide el caché en páginas de tamaño fijo, lo que permite asignar memoria en fragmentos más pequeños en lugar de grandes bloques contiguos. La mayoría de los motores de servicio modernos ya lo admiten, así que verifique si está habilitado antes de agregar una nueva configuración.
Si la memoria no es la limitación, pase a la Pregunta 5.
Pregunta 5: ¿Es la latencia de decodificación por token la métrica en la que se está centrando?
Si su objetivo es una transmisión de tokens más rápida para cada usuario en lugar de un mayor rendimiento general, considere la decodificación especulativa.
Un modelo borrador más pequeño predice varios tokens por delante y el modelo principal los verifica en una sola pasada. Cuando el modelo preliminar predice correctamente, se pueden completar juntos varios pasos de decodificación secuenciales, lo que reduce la latencia entre tokens.
La compensación es el modelo adicional y los gastos generales de verificación. Si no dispone de un modelo preliminar adecuado o sus predicciones se aceptan muy raramente, es posible que la complejidad añadida no dé sus frutos. En ese caso, pase a la pregunta 6.
Pregunta 6: ¿Prefill y Decode compiten por la misma GPU a escala?
Esto es principalmente una preocupación a escala de producción porque cambia la arquitectura de servicio.
Si los prerrellenos prolongados retrasan las solicitudes de decodificación y perjudican tanto el tiempo de obtención del primer token como la latencia entre tokens, la desagregación del prellenado de decodificación puede separar las dos fases en hardware dedicado. Complete previamente las solicitudes de proceso de los nodos y luego pase el caché KV para decodificar los nodos optimizados para la generación de tokens.
Esto agrega sobrecarga de enrutamiento y transferencia de caché KV, por lo que solo tiene sentido cuando el tráfico justifica esa complejidad. Para cargas de trabajo más pequeñas o solicitudes no interactivas, la inferencia por lotes fuera de línea suele ser más sencilla. Si no se aplica ninguna de estas condiciones, comience con el procesamiento por lotes continuo y el almacenamiento en caché de prefijos.

Asignación del árbol de decisión a una técnica de optimización
Trabajar en el árbol le llevará a una de las técnicas de la siguiente tabla:
Técnica ideal para compensaciones Cuantificación/escasez/destilación Modelos demasiado grandes para el hardware de destino o el presupuesto de latencia Alguna pérdida de precisión y las activaciones cuantificadas son más difíciles de acertar que los pesos cuantificados Almacenamiento en caché de prefijos Chat, agentes y cargas de trabajo de RAG con estructura de avisos repetidos Interrupciones en cualquier discrepancia a nivel de caracteres en el prefijo compartido Procesamiento por lotes continuo Tráfico simultáneo con longitudes de salida variables Desventaja mínima; principalmente una cuestión de si está habilitado PagedAttention Cargas de trabajo con cuellos de botella por la fragmentación de la caché KV Agrega una capa de tabla de páginas al cálculo de atención Decodificación especulativa Generación de un solo usuario sensible a la latencia Necesita un modelo preliminar con una tasa de aceptación razonablemente alta para dar sus frutos Desagregación de precarga y decodificación Tráfico a gran escala donde el precarga y la decodificación compiten por la misma GPU Costo de red de mover la caché KV entre nodos, además de la complejidad del enrutamiento Paralelismo tensor/canalización Modelos que no lo hacen caben en un solo dispositivo Burbujas de canalización y sobrecarga de comunicación entre dispositivos Descarga de caché KV Cargas de trabajo de contexto largo o de alta concurrencia que se quedan sin memoria de GPU para el caché La recuperación del caché descargado agrega latencia Inferencia por lotes sin conexión Cargas de trabajo no interactivas que priorizan el rendimiento total No se puede utilizar para nada con un requisito estricto de tiempo de respuesta
Reconocer los errores comunes de la optimización de la inferencia
Una técnica que cree que funcionará puede comportarse de manera muy diferente en la práctica. Las señales a continuación le indican cuándo sucede esto y qué verificar primero.
Síntoma Causa probable Solución La tasa de aciertos de la caché del prefijo es cercana a cero a pesar de los mensajes repetidos Serialización no determinista o contenido dinámico colocado al principio del mensaje Cargue frontalmente el contenido estático y corrija el orden de las claves en el contexto serializado El tamaño del lote no crecerá incluso con memoria de sobra PagedAttention no está habilitada o el tamaño de la página está mal configurado Verifique los indicadores de procesamiento por lotes y caché del motor de servicio directamente en lugar de asumir valores predeterminados La decodificación especulativa es más lenta que la decodificación simple La tasa de aceptación del borrador del modelo también lo es bajo para el modelo de destino Elija un modelo borrador con un comportamiento más cercano al objetivo, o elimine la decodificación especulativa para esta carga de trabajo La desagregación empeoró la latencia, no mejor La carga de trabajo es demasiado pequeña, o la mayoría de las solicitudes son cortas y tienen mucho caché Recurra al prellenado local y revise la desagregación solo después de un umbral de tráfico definido Las ganancias de rendimiento de la cuantificación no aparecieron Solo se cuantificaron los pesos mientras las activaciones permanecieron con total precisión, y la GPU todavía vuelve a convertir antes del cómputo Perfil donde se invierte el tiempo antes suponiendo que la cuantificación por sí sola solucionará el rendimiento
Si una técnica constantemente tiene un rendimiento inferior, verifique su suposición subyacente antes de agregar más complejidad.
Concluyendo
La elección de una técnica de optimización de inferencia comienza con la identificación del cuello de botella. El tamaño del modelo, la superposición de solicitudes, la concurrencia del tráfico, la fragmentación de la memoria y el equilibrio entre el rendimiento y la latencia por usuario apuntan hacia una respuesta diferente, y la mayoría de los sistemas necesitarán una combinación de algunos de estos en lugar de depender de solo uno.
Si está interesado en obtener más información, puede que le resulte útil La hoja de ruta para dominar la optimización de inferencias de LLM.
¡Feliz aprendizaje!
Acerca de Bala Priya C
Bala Priya es una desarrolladora, educadora y escritora técnica que vive en la India. Escribe sobre programación, ciencia de datos, aprendizaje automático e inteligencia artificial, centrándose en hacer que las ideas técnicas complejas sean prácticas y accesibles. Con más de cinco años de experiencia en redacción técnica, crea tutoriales, guías prácticas y análisis profundos que ayudan a los desarrolladores a crear, resolver problemas y comprender conceptos técnicos complejos. Sus intereses técnicos incluyen aplicaciones LLM, IA agente, algoritmos gráficos, visión por computadora, IA explicable y sistemas de aprendizaje automático. Cuando no escribe o codifica, Bala suele leer literatura clásica, fantasía épica o ficción especulativa. También le gusta hablar sobre libros, aprender cosas nuevas y compartir lo que aprende con la comunidad de desarrolladores.