
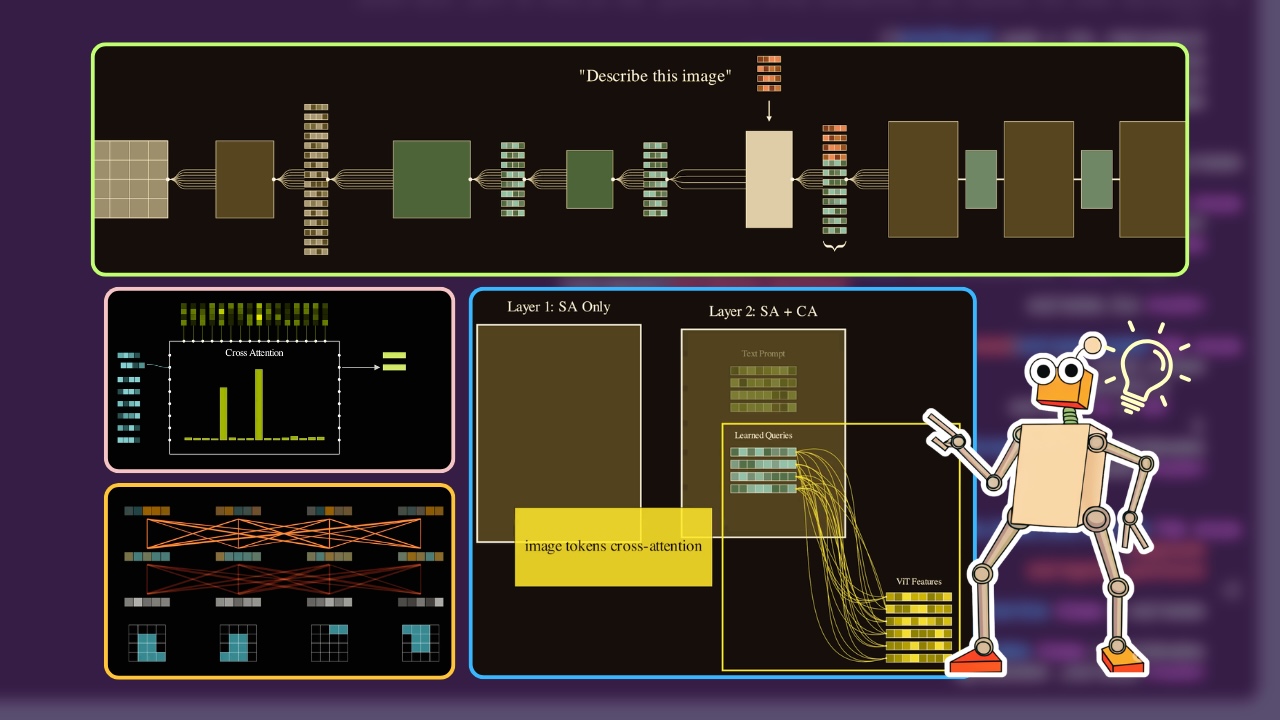
para transformar un pequeño modelo de lenguaje de solo texto y otorgarle el poder de la visión. Este artículo pretende resumir todos mis aprendizajes y profundizar en las arquitecturas de red detrás de los modelos de lenguaje de visión modernos.
El código es de código abierto, puede consultar el enlace de GitHub al final del artículo. También hay un vídeo complementario de YouTube de 30 minutos que explica todo el artículo en un formato visualmente rico.
Además, a menos que se indique lo contrario, todas las imágenes de este artículo son producidas por el autor.
Espera, ¿realmente vas a “entrenar desde cero”?
Sí… quiero decir, no… tiene un poco de matices.
En 2026, los laboratorios de investigación ya no entrenarán modelos multimodales desde “cero”. ¡Es simplemente demasiado caro enseñar una visión modelo y un lenguaje (textual) al mismo tiempo! Requiere más datos, computación, tiempo y dinero. Además, a menudo conduce a peores resultados.
En cambio, los laboratorios toman modelos de lenguaje de solo texto previamente entrenados y los ajustan para brindar “capacidades de visión”. En teoría (y en la práctica), esto es mucho más eficiente desde el punto de vista informático.
La arquitectura estándar
Aunque requiere menos datos, ajustar los LM de solo texto para que de repente comiencen a ver imágenes seguramente abriría su propia lata de gusanos.
¿Cómo incrustamos la imagen, es decir, la convertimos en representaciones numéricas que una red neuronal pueda entender? ¿Cómo ajustamos las incrustaciones de imágenes para que sean compatibles con el texto? ¿Cómo ajustamos los pesos del modelo de texto para que conserve su conocimiento mundial previo, pero también generamos texto a partir de incrustaciones de imágenes?

Estos módulos son:
The Image Backbone: un modelo que convierte imágenes sin procesar en incrustaciones. La capa adaptadora: estos son modelos que convierten las incrustaciones de imágenes en una incrustación "compatible con texto". Esta es la parte más desafiante: qué arquitecturas usar, qué funciones de pérdida, etc. La capa de lenguaje: el modelo de lenguaje que entrenaremos para ingresar las incrustaciones adaptadas y generar texto a partir de él.
Discutamos uno por uno.
1. La columna vertebral de la imagen
El objetivo de la columna vertebral de su imagen es simple:
Entrada: un mapa/imagen de píxeles 2D sin procesar.
Salida: una secuencia de incrustaciones de vectores que representan la imagen.
En general, solo utilizamos un modelo de imagen disponible en el mercado que ha sido entrenado previamente con un corpus masivo de imágenes, generalmente en tareas autosupervisadas.
Puede utilizar una red neuronal convolucional (como ResNet) para utilizarla como columna vertebral de la imagen. Pero los VLM modernos de última generación han pasado casi por completo a los ViT porque escalan mejor con los datos y son más flexibles para la fusión multimodal.
¿Entreno la columna vertebral de la imagen o la mantengo congelada?
En la mayoría de las investigaciones sobre VLM, existe una clara tendencia a mantener los backbones estáticos (congelados) para ahorrar costos. Además, el entrenamiento de visión y lenguaje generalmente necesita conjuntos de datos de imagen y texto emparejados. Dado que estos conjuntos de datos son siempre mucho más pequeños que el conjunto de datos previo al entrenamiento de VIT, el ajuste fino de la columna vertebral a menudo conduce a un sobreajuste y un rendimiento degradado.
Al mantener estos pesos congelados, básicamente estamos transfiriendo la propiedad del aprendizaje visión-lenguaje a partes posteriores de la red (es decir, la capa adaptadora y la columna vertebral del texto).
En mis experimentos utilicé el modelo ViT-Base. Este modelo toma la entrada de la imagen, la divide en parches de imágenes de 16 × 16 y les aplica atención propia para generar una secuencia de incrustación de 197 vectores. Cada vector tiene 768 dimensiones de largo (el tamaño de incrustación del VIT).
2. La capa adaptadora
Aquí es donde vamos a pasar la mayor parte de nuestro tiempo. Ya hemos convertido imágenes en incrustaciones, pero esas incrustaciones ignoran por completo el texto.
Los Vision Transformers están preentrenados únicamente en píxeles de la imagen. Ni en sus subtítulos ni en ninguna característica textual local. La función del adaptador es conectar las incrustaciones de imágenes basadas en píxeles en una secuencia (a menudo más corta) de incrustaciones de imágenes basadas en texto.
Hay muchas formas de hacer esto, como usar modelos CLIP, pero veremos uno de los enfoques más populares: el Query Former de Q-Former.
Q-ex
Muy bien, entonces, ¿qué es un Q-Former? En el artículo BLIP-2 se introdujo un Q-Former o Query-Former.
¿Cómo entreno a un Q-Former?
Los Q-Formers estándar se pueden entrenar utilizando cualquier conjunto de datos de pares de imagen y texto multimodal. Por ejemplo, puede utilizar el conjunto de datos Conceptual Captions, que es un corpus masivo de imágenes y sus correspondientes títulos. En mi proyecto, utilicé sólo 50.000 pares para entrenar al Q-Former.
Puede entrenar un Q-Former desde cero, pero la recomendación BLIP-2 es utilizar un modelo BERT previamente entrenado. Entonces eso es lo que haremos.
En un nivel alto, aquí está nuestro plan de juego básico:
Entrene un espacio de incrustación de articulaciones multimodal. Un espacio donde texto e imágenes se “conocen”. Básicamente, ingresaremos pares de imágenes y leyendas, e incrustaremos ambos en el mismo espacio conjunto. Las imágenes y los subtítulos incompatibles se asignarán en lugares separados en este nuevo espacio de inserción, y los subtítulos compatibles se asignarán cerca unos de otros.
Configurar capas de atención cruzada
Hay un problema: los modelos BERT son modelos puramente de texto. No tienen idea de qué es una imagen.
Por lo tanto, nuestro objetivo es introducir primero nuevas capas de atención cruzada para unir las incorporaciones de visión que surgen de VIT y las incorporaciones de texto de BERT. Analicemos paso a paso cómo convertimos BERT en un Q-Former:
Muestreo de un par de imagen y texto del conjunto de datos. Pase la imagen a través del modelo VIT congelado para convertir la imagen en incrustaciones de imágenes, con la forma [197, 768] Inicialice “incrustaciones de consultas que se pueden aprender”. Estas son (digamos 32) incrustaciones de vectores que usaremos para convertir la secuencia de incrustación de imágenes en una secuencia de incrustación de tokens basada en texto. Observe que 32 es mucho menor que la longitud de la secuencia de inclusión de VIT original (197). Ingresamos las incrustaciones de leyendas de texto y las incrustaciones de consultas en la primera capa BERT. La capa aplica autoatención a estas entradas.
Por ahora, supongamos que los tokens de consulta sólo atienden entre sí y los tokens de texto entre sí (es decir, los tokens de consulta y los tokens de texto no se ven entre sí).
En la segunda capa del BERT sucede algo INTERESANTE. Los dos conjuntos de incrustaciones pasan por otra capa de atención propia como antes. Pero esta vez, también utilizamos una capa de atención cruzada para contextualizar las incrustaciones de consultas con las incrustaciones de imágenes ViT que calculamos anteriormente.
Por supuesto, el BERT normal no tiene capas de atención cruzada, por lo que nosotros mismos introducimos estas capas de atención cruzada de múltiples cabezales.
Así, alternamos entre una capa de autoatención pura (donde las consultas y el texto se autoatiendan entre sí de forma independiente) seguida de una capa de atención cruzada (donde las incrustaciones de consultas atienden las incrustaciones VIT congeladas).
En la capa final, elegimos una pérdida de entrenamiento de incrustación conjunta, como ITC (Pérdida de contraste de texto de imagen) o ITM (Pérdida de coincidencia de texto de imagen) o ITG (Pérdida de generación de texto de imagen, etc.). Más sobre esto más adelante.
¿Qué hace la atención cruzada?
Contextualiza el contenido de la imagen con las incrustaciones de consultas. Puede imaginar que cada consulta intenta hacer coincidir un patrón de incrustación específico con las 197 incrustaciones de VIT.
Por ejemplo, si una consulta tiene una alta coincidencia con un único vector de imagen, capturará esa característica de manera muy destacada. Si la consulta coincide con una combinación de vectores, será un promedio de esas incrustaciones, y así sucesivamente.
Recuerde que entrenamos 32 de estas incrustaciones de consultas, por lo que está permitiendo que Q-Former aprenda múltiples coactivaciones diferentes dentro de las incrustaciones de imágenes. Debido a la naturaleza del entrenamiento, se fomentan estas coactivaciones para maximizar la alineación entre la imagen y el texto.
A medida que entrenemos al Q-Former, tanto las incorporaciones de consultas iniciales como los pesos de atención cruzada se optimizarán para que podamos extraer características relevantes de los tokens de imágenes VIT.
Las incrustaciones anteriores de la consulta no intentan capturar todos los detalles de estas 197 incrustaciones; en cambio, intentan aprender cómo combinarlas en una secuencia compacta de 32 tokens.
Tenga en cuenta que después de entrenar Q-Former, en realidad no usaremos la parte de texto de Q-Former para nada. Simplemente pasaremos las incrustaciones de consultas a través del Q-former y, alternativamente, ejecutaremos la atención propia y la atención cruzada solo en ellas.
Funciones de pérdida para entrenar Q-Formers
La forma en que se entrena el modelo Q-Former está estrechamente relacionada con la forma en que atendemos entre los tokens de consulta y de texto en todas las capas.
Pérdida de contraste de imagen-texto (nuestra configuración)
Para esta tarea utilizamos una máscara de autoatención unimodal. Los tokens de consulta asisten entre sí, los tokens de texto entre sí.
La función de pérdida puede ser cualquier función de pérdida contrastiva estándar tipo CLIP. Alinearemos la imagen y el texto en el mismo espacio de incrustación. Básicamente, tomamos el resultado de las consultas y el resultado del codificador de texto y calculamos su similitud. Si una imagen y un título van juntos, queremos que sus vectores estén lo más cerca posible.
Esto obliga a las consultas a extraer una representación visual "global" que coincida con el tema general del texto sin mirar las palabras todavía.
Pérdida de coincidencia imagen-texto (ITM)
Esto utiliza una máscara de autoatención bidireccional. Aquí, cada token de consulta puede ver cada token de texto, ¡y cada token de texto puede ver cada consulta!
Para la función de pérdida, utilizamos una tarea de clasificación binaria en la que el modelo tiene que predecir: "¿Esta imagen y este texto coinciden, sí o no?". Pérdida de entropía cruzada binaria.
Debido a que las modalidades son completamente mixtas, el modelo puede realizar comparaciones detalladas. Las consultas pueden mirar objetos específicos en la imagen (a través de la atención cruzada) y verificar si corresponden a palabras específicas en el texto. Esto es mucho más detallado que la pérdida contrastiva y garantiza que los 32 tokens capturen detalles localizados.
Pérdida de generación de imagen-texto (ITG)
Finalmente, tenemos la tarea generativa. Para ello utilizamos una máscara causal multimodal. Las consultas aún pueden verse entre sí, pero los tokens de texto ahora se tratan como una secuencia. Cada token de texto puede ver los 32 tokens de consulta, que actúan como un prefijo visual. Pero solo pueden ver los tokens de texto anteriores.
Para la función de pérdida, simplemente entrenamos el modelo para predecir el siguiente token en el título. Al obligar al modelo a "escribir" literalmente la descripción basada en las consultas, nos aseguramos de que esos 32 tokens contengan toda la información visual necesaria para que un modelo de lenguaje comprenda la escena.
Para mi proyecto, utilicé el más simple: ITC. Para un conjunto de datos pequeño como el que estaba usando, ¡esta era la forma más fácil! BLIP-2 recomienda utilizar una combinación de todos estos métodos de entrenamiento. El repositorio de github compartido al final del artículo proporciona la receta para utilizar cualquiera de los esquemas de atención anteriores.
En la siguiente sección, daremos el paso final: ¡entrenar el VLM!
3. La capa del lenguaje
Ahora viene el paso final. Usaremos VIT y Q-Former para convertir un modelo de lenguaje en un modelo de visión. Elegí uno de los modelos de lenguaje adaptados a instrucciones más pequeños: el SmolLM2-135M. Afortunadamente, esta parte no es tan complicada como el entrenamiento Q-Former.
Tenemos las incrustaciones de imágenes (procedentes de VIT y Q-Former) y tenemos los tokens de texto (procedentes del tokenizador SmolLM). Veamos algunos detalles.
Tomamos una muestra de una imagen y un título de nuestro conjunto de datos.
Elegimos aleatoriamente de una lista de indicaciones simples del sistema, similares a: "Eres un asistente útil. Responde sinceramente al usuario".
También seleccionamos la consulta del usuario de una lista de mensajes, por ejemplo: "¿Qué ves en esta imagen?"
También tokenizamos los títulos de salida tomados del conjunto de datos.
Estas 3 cosas forman las fichas de texto. Los tokenizamos todos usando el tokenizador SmolLM2, pero no vamos a insertarlo en el LLM todavía; primero debemos procesar la imagen.
Pasamos la imagen a través del VIT congelado, luego a través del Q-Former (nuevamente, tenga en cuenta que los títulos de texto no se pasan al Q-Former, solo se ejecuta la canalización de la imagen)
Introducimos una pequeña capa MLP que convierte la salida de Q-Former en nuevas incrustaciones que tienen la misma forma que el tamaño de incrustación esperado del LLM. A medida que entrenamos, esta capa MLP asignará la incrustación de Q-Former al espacio de incrustación de LLM.
Ahora que tenemos la secuencia de tokens de texto y las nuevas incrustaciones de imágenes (VIT -> Q-Former -> MLP). Pasaremos los tokens de texto a través de la capa de incrustación nativa del LLM. Intercalamos las incrustaciones de texto e imágenes en la siguiente secuencia:
…y pasarlo por el resto del LLM.
¿Por qué esa secuencia específica? Dado que los LLM autorregresivos utilizan enmascaramiento causal, esencialmente entrenaremos modelos para generar la secuencia de salida (título) dado el prefijo completo (mensaje del sistema, mensaje del usuario e incrustaciones de imágenes).
Agregamos adaptadores LoRA (matrices de adaptación de bajo rango) en lugar de entrenar todo el LLM desde cero. Al envolver nuestro LLM con LoRA, congelamos los millones de parámetros originales y solo entrenamos matrices pequeñas y de bajo rango inyectadas en las capas de atención. Esto hace que el modelo se pueda entrenar en hardware de consumo manteniendo intacta toda esa inteligencia preexistente.
¡Y eso es todo! Pasamos estas incrustaciones y etiquetas cosidas al LLM. El modelo atiende a las instrucciones de texto y a los tokens visuales simultáneamente y, gracias a LoRA, aprende a actualizar su cableado interno para comprender este nuevo lenguaje visual. Solo se entrenan las capas Q-Former, la capa MLP y los adaptadores LORA. Todo lo demás se mantiene congelado.
Después de entrenar esto durante unas pocas horas con un pequeño subconjunto de datos, el VLM entrenado ahora puede ver las imágenes y generar texto al respecto. El aprendizaje automático es tan hermoso cuando funciona.
En resumen
Puede encontrar el repositorio completo de github aquí:
https://github.com/avbiswas/vlm
Y mira el vídeo de youtube aquí:
[insertar]https://www.youtube.com/watch?v=Oj27kALfvr0[/embed]
Resumamos todos los módulos en las canalizaciones de Vision Language.
Una columna vertebral de visión (como el VIT) que toma la entrada de la imagen y la convierte en incrustaciones. Una capa adaptadora (como el Q-Former) que conecta la imagen con texto. Un LLM que entrenamos para consolidar el texto y las incrustaciones de imágenes para aprender el lenguaje de la visión.
Mi patrón:
https://www.patreon.com/NeuralBreakdownwithAVB
Mi canal de YouTube:
https://www.youtube.com/@avb_fj
Sígueme en Twitter:
https://x.com/neural_avb
Estoy construyendo Paper Breakdown, un lugar para estudiar trabajos de investigación.
https://paperbreakdown.com
Lee mis artículos:
https://towardsdatascience.com/author/neural-avb/