
que tus redes sociales te conozcan demasiado bien.
Cuando navegas por las redes sociales, notas un comportamiento muy típico: miras un vídeo y, de repente, tu línea de tiempo se inunda con más de lo mismo. Hace 5 años, se sentía un poco mágico. Pero hoy hablamos del “algoritmo” como si fuera una entidad misteriosa moviendo los hilos en algún sótano de Silicon Valley. La verdad es mucho menos dramática y mucho más interesante.
El algoritmo no es intrínsecamente malo, no se queda ahí tramando tu radicalización. Es solo un fragmento de código que ejecuta similitudes de cosenos y promedios ponderados, tratando de predecir en qué hará clic a continuación. El problema es que aquello con lo que interactuamos genera compromiso. Y la forma más segura de mantener a los humanos interesados resulta ser la peor manera de mantenerlos informados (cebos de ira, noticias falsas o algo peor).
Esta publicación trata sobre cómo funcionan los motores de recomendación, por qué nos inclinan hacia las cámaras de eco y, debido a que leer sobre algo nunca es lo mismo que verlo, construiremos uno desde cero, lo dirigiremos a datos de noticias reales y veremos cómo se forma la burbuja.
El motor de participación: cómo funcionan los recomendadores
Un algoritmo de redes sociales es, en esencia, un curador. Su trabajo es examinar millones de publicaciones y ofrecerle aquellas con las que es más probable que interactúe: haga clic, mire, dé me gusta, comparta, comente con furia. Lo hace basándose en una palabra: datos.
Cada acción que realizas es una pista:
En qué publicaciones permaneces (incluso sin hacer clic) Qué videos miras y durante cuánto tiempo Qué cuentas sigues, silencias o bloqueas Qué temas buscas a la 1 a.m.
Utilizando el aprendizaje automático, el algoritmo detecta patrones en esta manguera de comportamiento. Constantemente se hace la misma pregunta: ¿qué mantiene a esta persona en la plataforma por más tiempo? Recuerda que este es el objetivo más importante de cualquier empresa de redes sociales: mantenerte en la plataforma por más tiempo.
Dos técnicas clásicas se encuentran detrás de la mayoría de los sistemas de recomendación:
El filtrado colaborativo encuentra usuarios que se comportan como usted y recomienda lo que les gustó. Si a Alice y Bob les encantaban The Matrix e Inception, y Alice también amaba Interstellar, el sistema empuja Interstellar hacia Bob. Bastante fácil de entender. El filtrado basado en contenido analiza las características de lo que te ha gustado y encuentra cosas similares. Si miras muchos videos de cocina, aparecerán más videos etiquetados como "cocina", "receta" o "habilidades con el cuchillo", que se parecen a los que ya disfrutaste.
Las plataformas reales combinan estos métodos con cientos de otras señales. Pero la idea central es la misma: aprende de tu comportamiento, predice qué más podría atraparte.
El algoritmo no pretende mostrarte contenido malo o falso. Optimiza el compromiso. Y una de las formas más seguras de mantener a los humanos comprometidos es aprovechar nuestras emociones, especialmente las fuertes y negativas. O vídeos de gatos.
Creación de un recomendador de noticias sobre datos reales
Dejemos de hablar de esto de manera abstracta y construyamos uno. Utilizaremos registros de clics anónimos reales de Microsoft News. El conjunto de datos se llama MIND (Microsoft News Dataset), publicado para investigación académica por Microsoft Research. Esta muestra contiene 50 000 usuarios, más de 51 000 artículos de noticias en inglés en 17 categorías (noticias, deportes, finanzas, estilo de vida, salud, viajes y más) y más de 156 000 sesiones de impresiones reales, cada una de las cuales registra lo que se le mostró a un usuario y en qué hizo clic. Todo cabe en unas 30 líneas de Python, aunque realmente no es necesario conocer este detalle:
importar numpy como np importar pandas como pd desde scipy.sparse importar csr_matrix desde sklearn.metrics.pairwise importar cosine_similarity # Construir una matriz dispersa de usuario × artículo (1 = se hizo clic, 0 = no se hizo) matriz = csr_matrix((np.ones(len(clics)), (user_rows, Article_cols)), shape=(n_users, n_articles)) def recomendar(user_id, Matrix, top_n=15, n_neighbors=50): """Encuentre los 50 usuarios más similares y clasifique los artículos en los que hicieron clic y que nuestro usuario aún no ha visto.""" u = user_idx[user_id] # Similitud de coseno entre este usuario y todos los demás sims = cosine_similarity(matrix[u], Matrix).flatten() sims[u] = 0 # no te lo recomiendes a ti mismo # Selecciona los 50 usuarios más similares top_neighbors = np.argsort(sims)[-n_neighbors:][::-1]weights = sims[top_neighbors] # Califica los artículos por la suma ponderada de los clics de los vecinos puntuaciones = np.asarray(matrix[top_neighbors].T.dot(weights)).flatten() # Elimina a cero los artículos en los que el usuario ya hizo clic puntuaciones[matrix[u].toarray().flatten() > 0] = 0 # Devuelve los artículos con mayor puntuación top_articles = np.argsort(scores)[-top_n:][::-1] return top_articles
La similitud del coseno encuentra a tus cincuenta vecinos más cercanos, personas que hacen clic en el mismo tipo de artículos que tú. Tomamos los artículos en los que hicieron clic, los ponderamos según el parecido de cada vecino con usted y presentamos los quince primeros. Ésta es la base de lo que impulsa una industria de miles de millones de dólares.
¿Porque qué similitud?
La similitud del coseno puede parecer sacada de un libro de texto de matemáticas, pero tengan paciencia, es más fácil de lo que parece. Para mostrarle cómo funciona, hagamos un desvío rápido.
Imagine los siguientes puntos de datos repartidos en dos ejes, mecánico versus biológico y ternura:
La similitud del coseno mide el ángulo entre dos flechas, cada una comenzando desde el origen (0,0) y apuntando hacia uno de nuestros puntos de datos. Cuanto menor sea el ángulo entre ellos, más similares serán los dos elementos.
Piénselo de esta manera: si dos flechas casi apuntan en la misma dirección, los elementos que representan comparten características similares. Tomemos como ejemplo a los perros y gatos. Ambos obtienen puntuaciones altas en "biológico" y altas en "ternura", por lo que sus flechas apuntan casi en la misma dirección y la similitud del coseno devuelve un valor cercano a 1 (su máximo).
Pero si comparamos a los gatos con los ositos de peluche, aunque son similares en la dimensión linda, son diferentes en el eje biológico:

Si comparamos a los gatos con los ositos de peluche, aunque son similares en la dimensión linda, son diferentes en el eje biológico, un gato es completamente biológico, mientras que un osito de peluche puntúa cero.
Esto separa sus flechas. El ángulo entre ellos se amplía y la similitud del coseno devuelve un valor más bajo, lo que refleja que a pesar de compartir un rasgo, estos dos objetos ocupan regiones muy diferentes de nuestro espacio.
Y, por supuesto, al comparar gatos con automóviles, casi no hay similitud ya que las flechas entre ambos apuntan en direcciones diferentes:
Los modelos de IA utilizan este tipo de información para recomendar contenido que probablemente provoque una respuesta similar en usted. Imagina un espacio bidimensional donde un eje captura cómo te hace sentir un vídeo (tranquilo, entretenido, indignado) y el otro captura su tema. Cada vídeo se traza en algún lugar de ese espacio.
Si haces clic en un vídeo político que te hace enojar y lo ves completo. La plataforma registra ambas dimensiones: el tema y la respuesta emocional. Utilizando la similitud del coseno, encuentra otros videos cuya 'flecha' apunta en la misma dirección (videos políticos que provocan ira) y se los muestra a continuación. Cuanto más participas, con más confianza aprende el algoritmo qué rincón de ese espacio te mantiene mirando.
Conozca al usuario U92876 (llamémoslo Joe): el aficionado a los deportes
Elegí un usuario del conjunto de datos MIND cuyo historial de lectura es puro deporte, clasificaciones de poder de la NFL, rumores comerciales de la NBA, prohibiciones de la MLB. Leyó veinticinco artículos, todos deportivos.
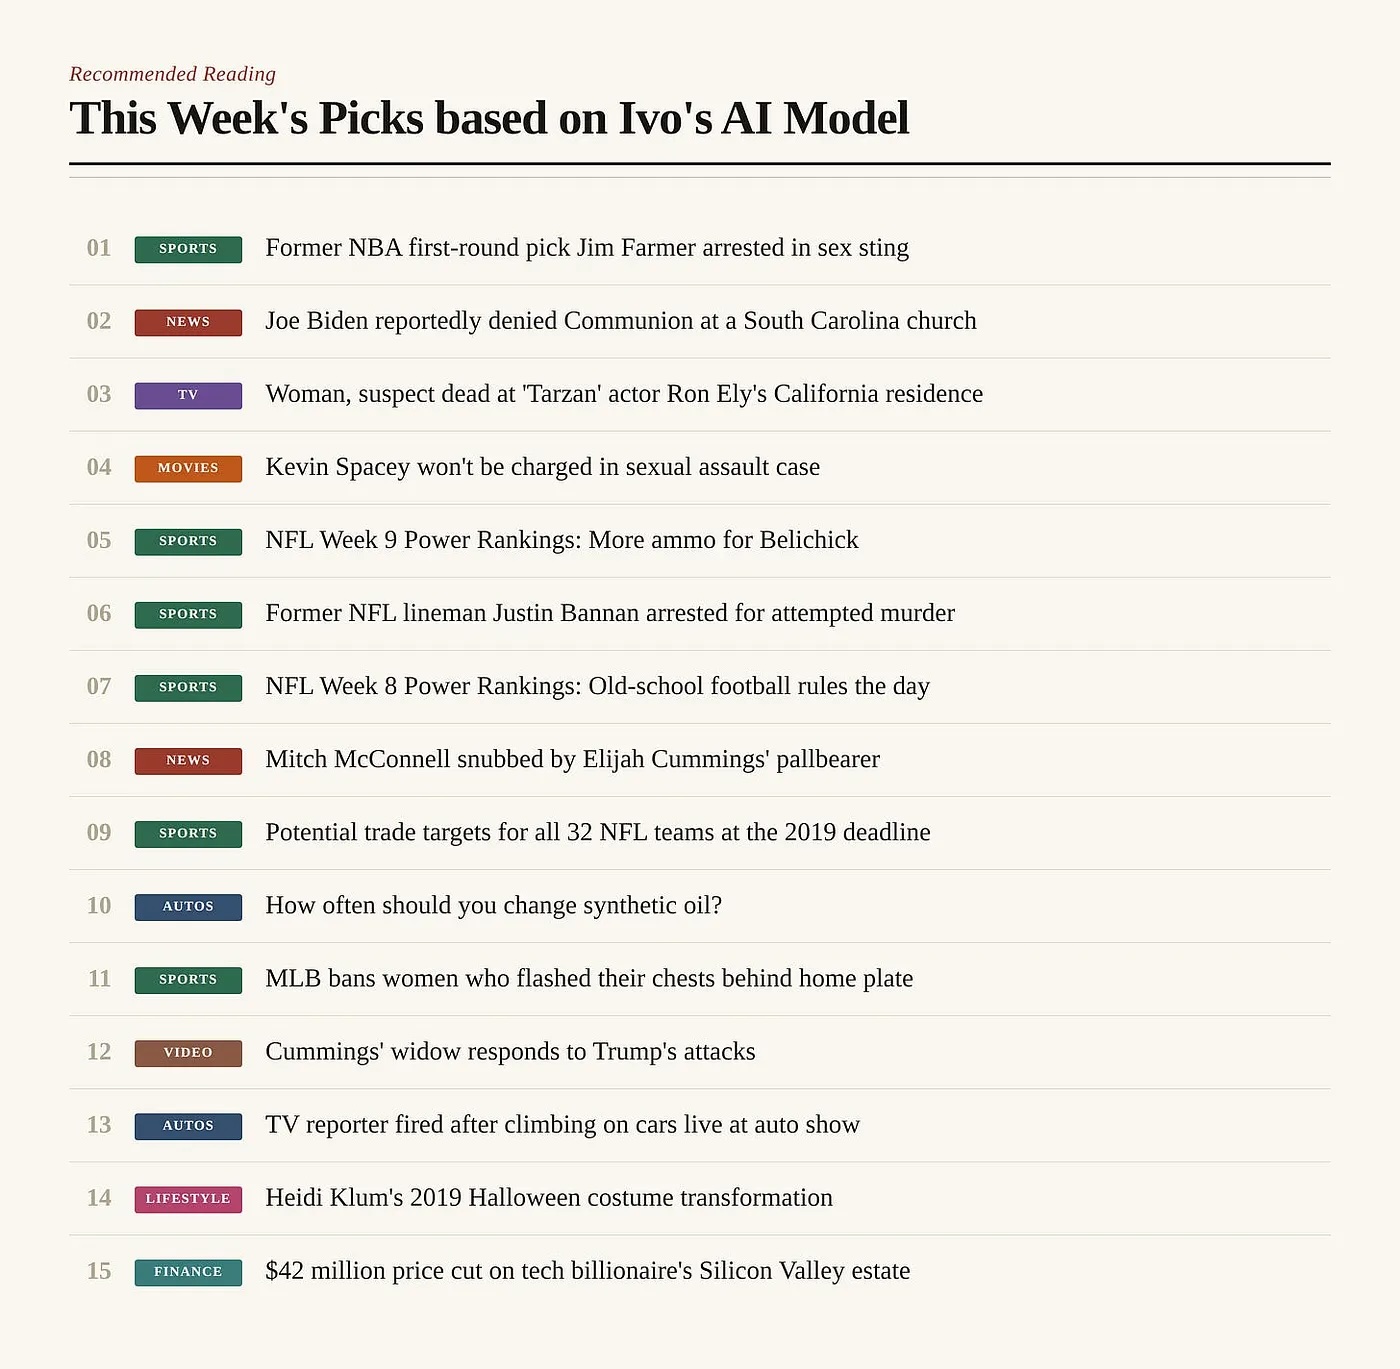
Preguntémosle al recomendador qué servirle:
El desglose de categorías:
40% deportes 13% noticias 13% automóviles 34% dispersión de todo lo demás.
El algoritmo reconoce el hábito deportivo de esta persona y lo retroalimenta, pero también sirve una dieta razonablemente variada. Hay política, entretenimiento, estilo de vida, finanzas. No está mal, ¿verdad?
Ahora mira lo que pasa.
El momento de la curiosidad
Simulé algo mucho más común que un atracón masivo en una madriguera de conejo: un momento de curiosidad ociosa.
Nuestro aficionado a los deportes no pasó horas leyendo política. Al mirar su feed inicial, simplemente hicieron clic en tres elementos que llamaron su atención:
La noticia sobre Joe Biden. La noticia sobre Mitch McConnell. El vídeo sobre los ataques de Trump.
Sólo tres clics en menos de diez minutos de lectura y visualización. Quedan tres pequeñas migas de pan para el algoritmo y Joe continúa con su vida durante el resto del día.
Ahora, si ejecutamos esos clics a través de las 30 líneas básicas de código Python que escribimos anteriormente, no sucedería gran cosa. Matemáticamente, 25 clics históricos en deportes aún superarían a 3 nuevos clics políticos. El algoritmo seguiría viendo un usuario que está interesado en un 89% en los deportes y el feed apenas se movería.
Pero aquí está el ingrediente secreto más importante de las redes sociales modernas: la ponderación de la actualidad (o decaimiento del tiempo).
Los algoritmos reales no tratan todos sus clics por igual, ya que un clic que hizo hace tres años es prácticamente historia antigua; un clic que hiciste hace tres minutos es oro. Para mantenerte enganchado a la sesión actual, las plataformas aplican un gran multiplicador a cualquier cosa que estés haciendo recientemente.
Una sola línea de código implementa esto en el algoritmo que vimos anteriormente. Si decidimos que los clics más recientes deberían tener hasta 100 veces más peso que los más antiguos, podríamos escribir algo como esto:
time_decay_weights = np.array([0.1 si historic_click o 10.0 para hacer clic en user_history])
Si hacemos esto, ejecutemos las recomendaciones nuevamente:
Este es el daño que solo 3 clics le han causado a nuestro sistema de recomendación de ponderación del tiempo:
Las noticias políticas pasaron del 13% al 40% del feed. Un aumento de 3x. De una tarde de hacer clic y leer tres noticias. Los deportes (lo que esta persona ha leído durante años) pueden pasar de la categoría dominante al segundo lugar. El algoritmo no se detuvo a pensar “espera, esta persona tiene 25 artículos deportivos en su historia, y una tarde de política no los define”.
No piensa, simplemente recalcula matrices de similitud ponderadas en el tiempo, encuentra un nuevo conjunto de vecinos y ofrece lo que otros usuarios que hicieron clic en esto pueden disfrutar.
Saltan a la vista dos cosas:
La velocidad. Puede llevar una noche invertir toda la composición del feed de un usuario. Las plataformas reales recalculan más rápido que esta demostración, ya que se actualizan en tiempo real. Probablemente notes esto en tu feed con anuncios relacionados con productos que has estado buscando últimamente. Lo que desaparece. No se trata sólo de lo que agrega el algoritmo, sino también de lo que elimina. La dieta informativa del usuario no sólo se volvió más política, sino que se hizo más estrecha. Y más estrecho es el verdadero peligro aquí.
Nota: las plataformas reales no publican sus constantes de caída, por lo que esto es ilustrativo, no una medida, pero el mecanismo es real y la dirección es lo que importa. Mi ejemplo de 100x es posiblemente una exageración del sesgo de actualidad.
Lo que nos dice la investigación
Ahora sabes cómo los clics influyen en las matemáticas de lo que el algoritmo te muestra a continuación.
Pero esto empeora: el contenido que nos enoja, nos asusta o nos sorprende nos pega a la pantalla mucho mejor que el contenido que nos hace sentir bien o informados. Las empresas de redes sociales no diseñaron esto conscientemente, sus algoritmos simplemente lo descubrieron.
Un estudio masivo de 2025 que analizó los datos de seguimiento digital de 25.000 usuarios de SmartNews encontró que los humanos poseen un “sesgo de negatividad” a nivel de rasgo al seleccionar noticias. Evolutivamente, estamos programados para prestar atención a las amenazas; evitar el peligro era fundamental para la supervivencia de nuestros antepasados. ¿Qué sucede cuando este antiguo instinto se encuentra con el aprendizaje automático moderno? El estudio confirmó que las recomendaciones personalizadas toman nuestro sesgo de negatividad inherente y lo aumentan activamente.
Además, los datos de investigadores que analizan cientos de millones de publicaciones en plataformas como Facebook y X (anteriormente Twitter) revelan que los usuarios de redes sociales tienen aproximadamente 1,91 veces más probabilidades de compartir enlaces de noticias negativos que positivos. Negatividad es igual a viralidad y nace el ciclo de indignación.
El costo cognitivo: no es solo lo que piensas, sino cómo piensas
El impacto de estos bucles algorítmicos no se trata sólo del tipo de contenido que consumimos; se trata de cómo altera fundamentalmente nuestro cerebro. Una revisión sistemática reciente de 2025 que analizó 71 estudios y 98,299 participantes de transmisiones de videos cortos (como TikTok, Instagram Reels y YouTube Shorts) encontró profundas consecuencias cognitivas.
Una mayor interacción con estas plataformas de desplazamiento interminable se asocia con un rendimiento cognitivo más deficiente, lo que afecta específicamente nuestra atención sostenida y nuestro control inhibidor.
Los psicólogos señalan un doble proceso de habituación y sensibilización para explicar este fenómeno. La naturaleza rápida y de alta estimulación de los videos cortos nos insensibiliza a tareas más lentas y que requieren más esfuerzo, como leer un libro o resolver problemas en profundidad. Al mismo tiempo, la entrega instantánea de contenido seleccionado por parte del algoritmo sensibiliza el sistema de recompensa de nuestro cerebro, reforzando los patrones de participación impulsiva y fomentando la búsqueda habitual de gratificación instantánea.
Los usuarios habituales de estas plataformas presentan una actividad electrofisiológica reducida durante las tareas que exigen atención. Algunos investigadores incluso señalan diferencias estructurales en regiones clave de control cognitivo, incluida la corteza prefrontal y los circuitos de recompensa del cuerpo estriado, relacionadas con este bombardeo constante de estímulos algorítmicos altamente gratificantes.
El costo social
Debido a las matrices matemáticas, cada uno de nosotros está en su propia burbuja personalizada de información.
A corto plazo, resulta molesto para la mayoría de la gente. Pero al alejar el zoom la imagen se oscurece. Cuando los algoritmos nos proporcionan contenido que confirma lo que ya creemos, experimentamos un sesgo de confirmación con esteroides.
Estas burbujas de filtro profundizan la división social que tenemos hoy. Seguiremos extremadamente divididos y no hay un final a la vista para este abismo.
La desinformación prospera en circuitos cerrados porque las historias falsas no quedan expuestas al escrutinio fuera de la burbuja. Para cuando sale una verificación de hechos, la mentira original ha dado una vuelta alrededor de la plataforma y ha creado un pequeño ejército de creyentes.
Y la democracia, que depende de una base compartida de la realidad y de cierta voluntad de discutir en público, se ve afectada cuando los ciudadanos ocupan burbujas de realidad completamente diferentes.
Recuperando tu feed
No eres impotente aquí. El algoritmo responde, pero hay un par de cosas que puedes hacer que, aunque molestas, pueden sacarte de tu burbuja.
El mismo mecanismo que construyó su burbuja puede usarse para ampliarla. Algún movimiento práctico:
Diversificar los insumos. Siga activamente algunas fuentes fuera de su zona de confort. Si se inclina políticamente hacia un lado, siga algunas voces reflexivas del otro lado. Reinicie periódicamente. Borra tu historial de reproducciones. Utilice "No estoy interesado" en sugerencias que lo siguen atormentando. Pruebe la plataforma sin iniciar sesión o en modo incógnito y observe lo diferente que se ve el mundo sin sus datos. Utilice feeds cronológicos. La mayoría de las plataformas todavía te permiten desactivar la clasificación algorítmica y simplemente ver las publicaciones de las personas que sigues, en orden. Haga una pausa antes de compartir. Cada me gusta, comentario y acción compartida es un voto por "más de esto, por favor". Si algo te pone furioso, es exactamente cuando es más probable que el algoritmo te esté explotando. Limita el tiempo. Establece límites de tiempo frente a la pantalla. Programe horas fuera de línea. Cuanto menos dependas de la alimentación para tu dieta informativa, menos poder tendrá para moldear lo que crees.
Más allá de la burbuja
Espero que esta publicación de blog le haya informado sobre cómo funcionan estas burbujas de sistemas de recomendación. Creamos un recomendador a partir de datos de noticias reales y fueron necesarios tres clics para cambiar el feed de un aficionado a los deportes de un 40 % de deportes a un 53 % de política.
El primer paso para liberarse es simplemente ser consciente. La próxima vez que se encuentre en un frenesí en línea, respire y pregunte: ¿Por qué veo esto? ¿Quién se beneficia de que reaccione de esta manera? La respuesta generalmente se remonta a un algoritmo que hace su trabajo, y ese trabajo rara vez consiste en "informarle".
Manténgase informado, tenga la mente abierta,
-Ivo