
localmente suena sencillo. Descargue los pesos, inicie el servidor y envíe solicitudes. Esto funciona para un chatbot, pero no funciona automáticamente para un agente. En mi caso, he estado construyendo un agente para el análisis automatizado de secuencias de ARN unicelulares. La idea es que, dados los datos sin procesar, el agente pueda ejecutar todo el proceso por sí solo, decidiendo qué herramientas llamar, leyendo los resultados y trabajando en el análisis paso a paso.
Quizás se pregunte por qué no utilizar algo como Claude Code con una habilidad de análisis unicelular. La respuesta corta es que, para los flujos de trabajo científicos, eso no es suficiente. En última instancia, las habilidades son indicaciones y, por lo tanto, pueden anularse o ignorarse. Más importante aún, el trabajo científico requiere reproducibilidad y seguimiento de procedencia: saber exactamente qué parámetros se utilizaron, qué células se filtraron, qué resolución de agrupamiento produjo qué resultado, etc. Ese registro debe ser estructurado y persistente, no reconstruirse a partir de una conversación. Para sesiones de larga duración, también se necesita una gestión explícita del estado mundial en lugar de depender de la compactación del contexto para preservar lo que importa. Estas son cosas que debes construir deliberadamente. Construir todo esto sobre un modelo local también significa que eres dueño de la infraestructura, y en eso me voy a centrar aquí.
El agente que creamos se ejecuta en hardware HPC institucional utilizando modelos abiertos recientes. Es fácil suponer que los modelos de peso abierto no son lo suficientemente fuertes para este tipo de trabajo. Pero eso es cada vez menos cierto. Lanzamientos recientes como Qwen3.6–27B y Gemma 4–31B son realmente útiles para cargas de trabajo estructuradas basadas en herramientas (si está interesado en mantenerse al día con la evolución del código abierto, Interconnects AI tiene material interesante que puede seguir). Y esa es una de las principales razones por las que el alojamiento local tiene sentido aquí. Nuestro agente también admite API en la nube como Claude y GPT, pero cuando las usa, toda la infraestructura que voy a describir es invisible para usted. Alguien más ya lo ha solucionado. Cuando aloja el modelo usted mismo, esos problemas pasan a ser suyos.
Cuando ejecuté el modelo por primera vez, funcionó en un sentido estricto. El modelo llamaría herramientas, las herramientas se ejecutarían y el análisis avanzaría. Pero todavía no era realmente utilizable. Un análisis simple de una sola celda podría tener entre 50 y 80 llamadas a herramientas en un bucle. Cada llamada llevaba el mismo equipaje fijo: el mensaje del sistema, los esquemas de las herramientas y el creciente historial de conversaciones. Para este agente, solo el indicador del sistema y los esquemas de herramientas ascendieron a aproximadamente 36.000 tokens. Antes de que el modelo pudiera decidir algo, primero tuvo que leer decenas de miles de tokens de instrucciones y definiciones de herramientas. Luego tuvo que hacerlo nuevamente en la siguiente iteración. Y nuevamente en el siguiente. Cada iteración tomó de 10 a 15 segundos. Y una sesión larga eventualmente colapsaría con errores de desbordamiento de contexto, llevándose consigo todo el estado del análisis en memoria. Este artículo trata sobre cómo solucionar ambos problemas.
La primera parte cubre cómo hacer que la inferencia sea más rápida a través de un conjunto de optimizaciones compuestas para el servidor de inferencia vLLM (un motor de inferencia de código abierto creado para el servicio LLM de alto rendimiento). La segunda parte cubre mantener vivas sesiones largas a través de una mejor gestión del contexto y un estado mundial estructurado que sobreviva al recorte. Realicé experimentos en las GPU A100 y H100 para medir el impacto de cada cambio, y se describen a continuación.
Parte 1: Hacer inferencias rápidamente
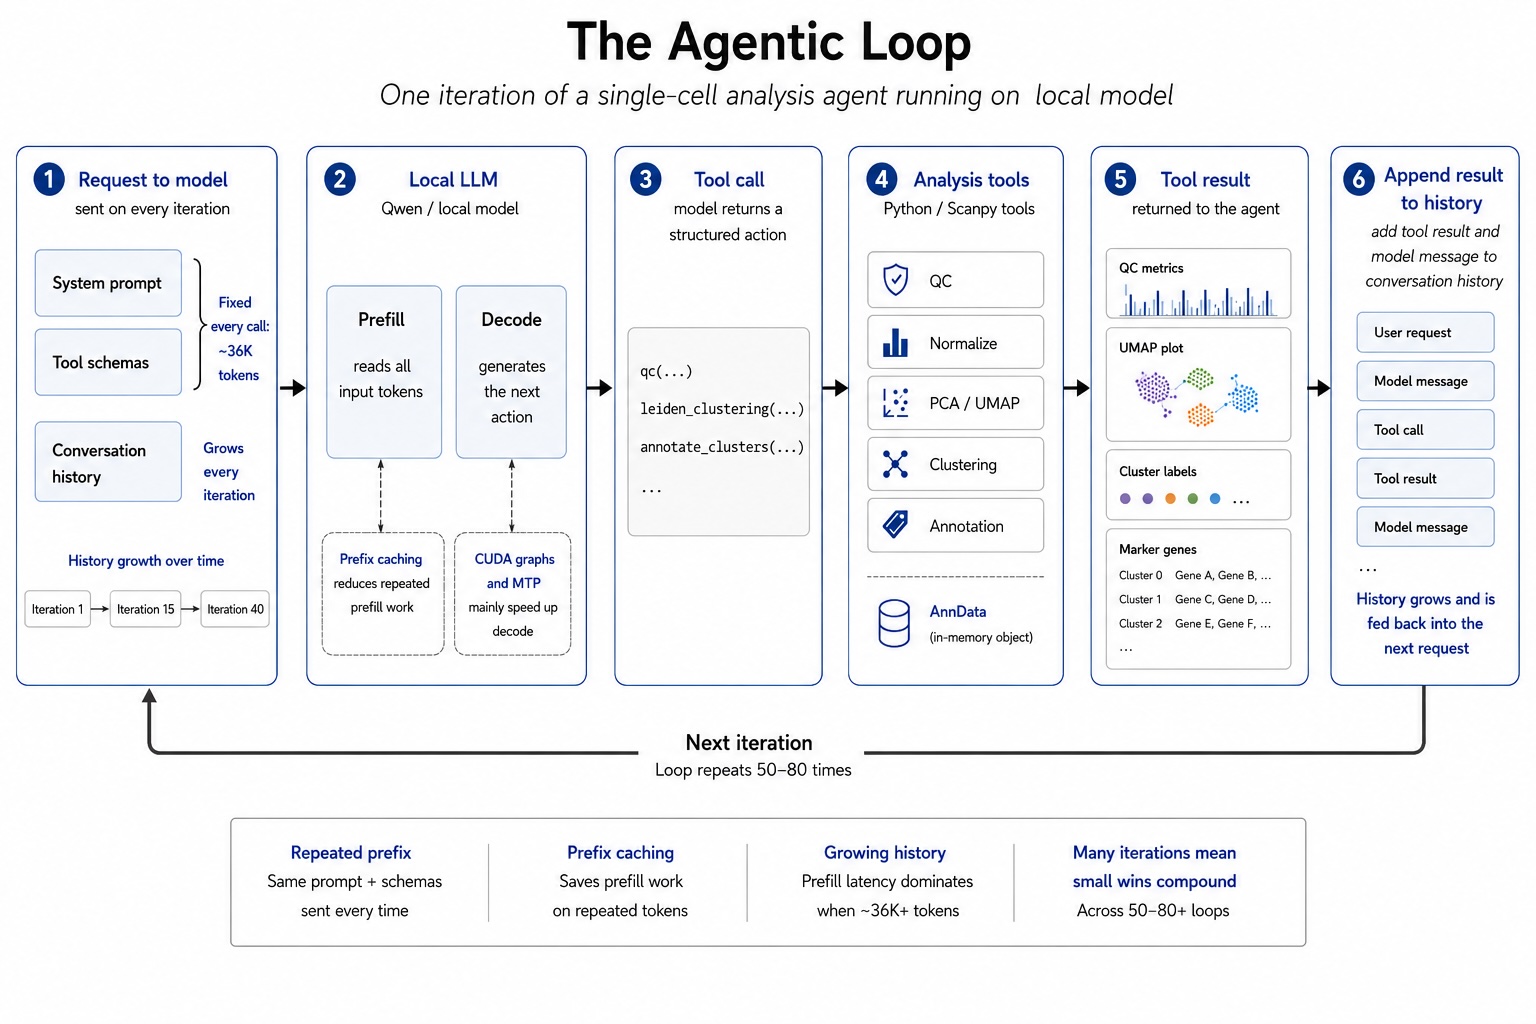
Antes de entrar en las optimizaciones individuales, es útil comprender qué sucede realmente en cada iteración del ciclo del agente. El siguiente diagrama muestra una única iteración: el agente envía una solicitud que contiene el mensaje del sistema, los esquemas de herramientas y el historial de conversaciones completo al modelo. El modelo lo lee todo y decide qué herramientas llamar. La herramienta se ejecuta y devuelve un resultado, y ese resultado se agrega al historial antes de que comience la siguiente iteración. Aquí vale la pena señalar dos cosas. El prefijo fijo, que es el mensaje del sistema más los esquemas de herramientas, tiene aproximadamente 36.000 tokens y se envía en cada llamada. Y el historial de conversaciones crece con cada iteración. En la iteración 40, el modelo ya no lee una instrucción breve. Es leer una transcripción de análisis larga con muchas llamadas a herramientas, resultados de herramientas, resultados intermedios, etc. Ambas cosas afectan el rendimiento del agente.
1.1 Gráficos CUDA: reducción de cientos de instrucciones por token a una
Para entender esto, es útil saber qué sucede dentro de una GPU cuando genera un único token.
Generar un único token durante la fase de decodificación implica ejecutar una secuencia de núcleos de GPU en orden: atención, retroalimentación, normalización, etc. Cada uno de estos lanzadores de kernel tiene un pequeño costo de coordinación en el lado de la CPU. La CPU tiene que poner en cola una instrucción que le dice a la GPU exactamente qué kernel ejecutar, con qué formas tensoriales y punteros de memoria. Para un modelo de 27 mil millones de parámetros con el que hemos estado trabajando, esto significa cientos de envíos individuales por token. Cada uno es pequeño, pero suman.
Los gráficos CUDA eliminan esta sobrecarga. Antes de manejar cualquier solicitud real, vLLM puede ejecutar un pase de preparación en el que registra todos los envíos del kernel para el paso de decodificación en un único objeto reproducible. Después de eso, generar cada token es una instrucción para la GPU en lugar de cientos. El resultado es aproximadamente entre un 20% y un 25% menos de latencia con este único cambio, sin cambios en el modelo en sí.
Esto es genial, pero los gráficos CUDA también requieren formas de tensor estático, lo que significa que el gráfico se compila para un tamaño de lote y una longitud de secuencia específicos. Lo que esto significa para nosotros es que la primera puesta en marcha lleva más tiempo que las siguientes. Las startups posteriores son mucho más rápidas. Como se muestra en la Figura 8 a continuación, para un agente que ejecuta cientos de iteraciones, el efecto acumulativo es grande.
1.2 Colocar más en la memoria
Cada peso en una red neuronal es un número, y el formato que se utiliza para almacenar ese número afecta tanto la cantidad de memoria que se necesita como la velocidad a la que la GPU puede trabajar con él. El formato estándar para los LLM modernos (al menos para capacitación) es BF16, que almacena cada peso como un número flotante de 16 bits. Para los 27 mil millones de parámetros de Qwen3.6–27B, son aproximadamente 56 GB de datos de peso solo para cargar el modelo.
FP8 almacena cada peso en un byte en lugar de dos. El mismo modelo ahora cabe en alrededor de 31 GB. Ahora podemos usar esa memoria liberada para la caché KV, que es la que almacena el contexto de la conversación. Más caché KV significa que el modelo puede manejar entradas más largas antes de quedarse sin espacio. Pero la memoria que liberamos para la caché KV no se utiliza de la misma manera en todos los modelos. La cantidad de contexto real que obtenemos de esa memoria depende de la arquitectura del modelo en sí. Un número útil aquí es la memoria KV por token, que es básicamente cuánta memoria GPU necesita el modelo para almacenar un token de contexto.
Esta es la razón por la que dos modelos con recuentos de parámetros similares pueden comportarse de manera diferente en la práctica. Por ejemplo, Gemma 4–31B utiliza aproximadamente 1,1 MB de caché KV por token. Qwen3.6–27B, dependiendo de cómo se cuenten sus capas de atención, puede estar más cerca de 256 KB por token en una estimación conservadora. Eso significa que la misma cantidad de GPU sobrante te permite obtener muchos más tokens de contexto en Qwen que en Gemma.
Por ejemplo, supongamos que después de cargar el modelo en dos GPU de 80 GB y dejar algo de tiempo de ejecución adicional, tenemos alrededor de 82 GB disponibles para la caché KV. Con Gemma, obtenemos 82 GB/1,1 MB ≈ 74k tokens. Con Qwen, si usamos 256 KB por token, 82 GB/256 KB ≈ 320 k tokens. En la práctica, la longitud máxima de contexto configurada del modelo limita esto a alrededor de 262 000 tokens (bueno, en realidad, si usa YaRN, se puede extender a 1 millón de tokens), pero el punto es el mismo. Qwen puede usar la misma memoria GPU de manera mucho más eficiente para cargas de trabajo de contexto prolongado.
Volviendo a trabajar con FP8 para los pesos de nuestros modelos, en realidad multiplicar los números de FP8 usando núcleos tensoriales de hardware requiere unidades aritméticas de FP8 dedicadas, que NVIDIA introdujo en la generación Hopper. El H100 los tiene. El A100 no. Entonces, en A100 usamos pesas BF16 y en H100 usamos pesas FP8. El beneficio de velocidad se deriva directamente de esto. Durante la decodificación, la GPU tiene que leer los pesos del modelo de la memoria en cada token que genera. En el tamaño de lote 1, que es lo que parece una sesión de agente de un solo usuario, la lectura de la memoria es el cuello de botella, no el cálculo en sí. Pesos más pequeños significan menos datos para leer por token, lo que significa una generación más rápida.
Aparte de los pesos del modelo en sí, hay un segundo lugar en el que ayuda FP8, y este funciona en ambas GPU. Almacenar vectores de caché KV en FP8 en lugar de BF16 reduce a la mitad el costo por token (para Qwen3.6–27B, pasa de 256 KB a 128 KB), duplicando directamente la cantidad de tokens que caben en la memoria. Los vectores se almacenan en FP8 para mejorar la eficiencia de la memoria, pero se descuantifican a BF16 cuando realmente se usan en el cálculo de atención, por lo que esto no requiere núcleos tensoriales de FP8.

Hay una cosa más que agrava el beneficio de la memoria. Al ejecutar el modelo en varias GPU con paralelismo tensorial se dividen las matrices de peso en ambas tarjetas. Cada GPU ahora tiene la mitad del peso, lo que libera aún más espacio por GPU para la caché KV. En A100, esto reduce el peso por GPU de 56 GB a 28 GB, dejando 44 GB por GPU para caché KV en lugar de 16 GB. Esto se traduce en una ventana de contexto de alrededor de 180 000 tokens en el hardware A100, lo que es suficiente para que se ejecute una sesión de análisis completa sin desbordamiento (el paralelismo tensor es diferente de FSDP, que es otro método de distribución de carga de trabajo. Puede leer mi otro artículo aquí para obtener más información).
1.3 Almacenamiento en caché de prefijos
Recuerde el prefijo fijo que mencionamos anteriormente: el mensaje del sistema y los esquemas de herramientas que se envían en cada iteración del bucle del agente. Para este agente, son aproximadamente 36.000 tokens. En cada iteración, antes de que el modelo pueda decidir algo, primero tiene que leer y procesar todos esos tokens desde cero. Eso significa calcular la atención total sobre 36K tokens en cada llamada, aunque nada en ese prefijo haya cambiado desde la última llamada.
El almacenamiento en caché de prefijos resuelve este problema almacenando los vectores de clave y valor para cualquier secuencia de tokens que el modelo ya haya procesado. Si la siguiente solicitud comienza con el mismo prefijo, esos vectores se recuperan directamente del caché en lugar de volver a calcularse. El modelo solo paga el costo total de precarga en la primera solicitud. Cada solicitud posterior en la misma sesión salta directamente a los nuevos tokens al final. Pero si algo cambia en ese prefijo a mitad de la sesión, es necesario leer todo el historial desde cero. Por ejemplo, si edita el mensaje del sistema o edita la lista de herramientas agregando herramientas MCP, por ejemplo, es necesario volver a leer todo. Lo mismo ocurre si cambia el modelo a mitad de sesión. Es posible que haya visto esto en Claude Code, donde le indica que es necesario volver a leer el mensaje completo si intenta cambiar el modelo a mitad de la sesión.
Para un bucle de agente, esto es particularmente valioso porque la porción fija es grande y la nueva porción agregada en cada iteración es comparativamente pequeña. A medida que avanza la sesión, la tasa de aciertos de la caché mejora. En la iteración 40, la mayor parte de la solicitud es un historial almacenado en caché y solo las incorporaciones más recientes necesitan un nuevo cálculo.
Para medir el impacto real, ejecutamos el sistema real del agente y los esquemas de herramientas, los tokens completos de 36 KB, a través del servidor vLLM con y sin almacenamiento en caché de prefijo habilitado, en hardware A100 y H100. Medimos el tiempo hasta el primer token en el inicio en frío, que es la primera solicitud en la que el caché está vacío y el prefijo completo debe calcularse desde cero, y en solicitudes en caliente posteriores en las que el caché ya está lleno. En A100, el tiempo de arranque en frío hasta el primer token (TTFT) fue de 11470 ms. Con un caché cálido, eso se redujo a 706 ms. En el H100, el arranque en frío fue de 2655 ms, cayendo a 249 ms en el arranque en caliente. Esto se debe a que el prefijo no se vuelve a calcular. Sólo se procesan los nuevos tokens en la cola.
1.4 Decodificación especulativa
La decodificación es inherentemente secuencial. El modelo genera un token, lo agrega al contexto y luego genera el siguiente de manera autorregresiva. Cada token depende de todos los anteriores, por lo que no se puede paralelizar entre tokens de la misma manera que se puede paralelizar entre un lote. Para una sesión de agente de un solo usuario con un tamaño de lote 1, este cuello de botella secuencial es la principal limitación en el rendimiento.
La decodificación especulativa soluciona esto introduciendo un pequeño borrador de modelo que se adelanta al modelo principal. El borrador del modelo propone los próximos k tokens de forma económica y rápida. Luego, el modelo principal verifica todos los k tokens propuestos en un único pase directo paralelo. Debido a que el modelo principal lee k tokens simultáneamente en lugar de generarlos uno por uno, el paso de verificación cuesta aproximadamente lo mismo que generar un solo token normalmente. Si se aceptan la mayoría de las propuestas, obtendrá k tokens por casi el precio de uno.
La variable clave es la tasa de aceptación. Si las propuestas del modelo borrador son consistentemente incorrectas, el modelo principal las rechaza y vuelve a generar un token a la vez, pero aún así usted paga los gastos generales de ejecutar la ruta del borrador. El punto de equilibrio exacto depende del modelo preliminar, la cantidad de tokens propuestos, el hardware y la implementación del servicio. En nuestra configuración, una aceptación inferior a aproximadamente el 40% no valía la pena.
Aquí es donde la elección del modelo de proyecto es muy importante. Inicialmente probamos DFlash, un pequeño modelo separado utilizado como borrador. La tasa de aceptación de nuestra carga de trabajo fue del 4 al 7%, muy por debajo del punto de equilibrio. De hecho, hizo que las cosas fueran más lentas. (Para ser justos, en el día en que escribo este artículo, los creadores de DFlash en el laboratorio Z dijeron que el modelo preliminar de Qwen3.6–27B todavía estaba en entrenamiento, por lo que podría ser mejor una vez que esté hecho). Pero para nuestro caso, Qwen3.6–27B tiene algo mejor integrado: un cabezal de predicción multitoken (MTP), que es un cabezal de predicción auxiliar entrenado junto con el modelo principal y integrado directamente en los pesos. Debido a que el jefe de MTP se entrena junto con el modelo principal y utiliza los propios estados ocultos del modelo, sus propuestas están mucho mejor alineadas con lo que el modelo habría generado de todos modos.
Medimos las tasas de aceptación de MTP en sesiones de agentes reales tanto en A100 como en H100. Con una aceptación media de ~89%, MTP se encontraba con seguridad en el lado útil de la compensación. Muy por encima del punto de equilibrio y estable en diferentes partes del flujo de trabajo de análisis.
Poniéndolo todo junto
Cada una de estas optimizaciones se comparó de forma acumulativa, y cada configuración se basó en todas las anteriores. La pila completa se midió en el hardware A100 y H100 en el modelo Qwen que hemos estado usando con nuestro sistema de token real de 36K, coincidiendo con las condiciones reales de una sesión de agente.
Algunas cosas destacan. Los gráficos CUDA son la ganancia de decodificación dominante, dando aproximadamente 3x en A100 y 6x en H100. La línea base H100 en realidad comienza más lenta que la A100, lo cual es contradictorio (en realidad, una cosa a tener en cuenta aquí es que el protocolo de comunicación entre sus GPU es muy importante, además del tipo de GPU. El estándar de oro es usar NVLink a través de NVSwitch seguido de NVLink Bridge y luego PCIe). Refleja cuán severamente la sobrecarga de distribución de CPU limita los núcleos FP8 antes de que se compilen los gráficos. Sin embargo, una vez que se habilitan los gráficos, el H100 avanza y permanece allí.
La caché de FP8 KV y el almacenamiento en caché de prefijos tienen un rendimiento de decodificación estable, lo que se esperaba. Se ocupan de la capacidad de la memoria y la latencia de precarga respectivamente, no de la velocidad de generación de tokens. El efecto de almacenamiento en caché de prefijo se muestra claramente en el lado TTFT de la cascada: una línea plana a través de las tres primeras configuraciones, luego una caída pronunciada cuando el almacenamiento en caché está habilitado.
MTP es el segundo mayor contribuyente de decodificación en ambas GPU, sumando alrededor del 37 % en A100 y el 20 % en H100.
Parte 2: Mantener vivas las sesiones largas
Cuando se utilizan modelos en la nube, la gestión del contexto es más fácil de ignorar. Las ventanas de contexto suelen ser lo suficientemente grandes para sesiones de chat normales y la infraestructura de servicio se maneja por usted. Cuando ejecuta un modelo local, la ventana contextual se convierte en un presupuesto de hardware. Más contexto significa más caché KV. Más caché KV significa más memoria GPU. En una de nuestras configuraciones anteriores del A100, la ventana de contexto efectiva era de alrededor de 74 000 tokens.
Un análisis de una sola celda puede ejecutar de 50 a 80+ iteraciones. Cada iteración agrega llamadas a herramientas, resultados de herramientas, observaciones intermedias, gráficos, errores, correcciones y restricciones del usuario al historial de conversaciones. Cuando se llena sin ninguna administración, la API devuelve un error de longitud de contexto excedida y la sesión finaliza, llevándose consigo todo el estado del análisis en memoria, incluido el objeto AnnData que contiene el conjunto de datos procesado.
Así que el problema no era sólo hacer que el modelo fuera rápido. El agente también necesitaba sobrevivir el tiempo suficiente para terminar.
La gestión del contexto parece sencilla. Realice un seguimiento de qué tan llena está la ventana y recórtela cuando esté demasiado llena. En la práctica, sin embargo, hay algunos lugares donde las implementaciones ingenuas pueden salir mal.
Anthropic tiene un libro de cocina sobre ingeniería de contexto para agentes y describe tres estrategias para tareas de largo horizonte: compactación, toma de notas estructuradas y arquitecturas de múltiples agentes. La compactación es la solución más común y, para un asistente de uso general, funciona bien. Cuando el contexto se llena, el historial de conversaciones se devuelve al modelo para resumirlo y la sesión continúa con esa versión comprimida.
Para un asistente general, eso puede funcionar. Para el análisis científico, se pierden las cosas equivocadas.
El problema del flujo de trabajo científico es que un resumen en prosa pierde exactamente la información que necesita. "El análisis agrupó los datos y ejecutó el control de calidad" es un resumen válido, pero descarta los umbrales de control de calidad, la resolución de agrupamiento, la cantidad de células retenidas, etc. Esos parámetros exactos son los que el agente necesita para reproducir un paso, describir su metodología o responder correctamente una pregunta sobre lo que hizo. Esos no son detalles cosméticos. Ellos son el análisis. Un agente científico necesita el registro exacto, no sólo la esencia.
Más allá del problema conceptual de la compactación, existen formas más básicas en las que la gestión del contexto puede fallar. La primera es la contabilidad de costos fijos. Cada llamada a la API incluye el aviso del sistema, los esquemas de herramientas y el presupuesto de finalización reservado antes de que aparezca un único mensaje de historial. Para este agente, los esquemas de herramientas y mensajes del sistema por sí solos representan alrededor de 36 000 tokens. Si el umbral de recorte no resta esos costos fijos primero, el agente puede terminar recortando un presupuesto que ya se superó antes de que se incluyera cualquier historial.
Más allá del problema conceptual de la compactación, existen formas más básicas en las que la gestión del contexto puede fallar. La primera es la contabilidad de costos fijos. Cada llamada a la API incluye el aviso del sistema, los esquemas de herramientas y el presupuesto de finalización reservado antes de que aparezca un único mensaje de historial. Para este agente, los esquemas de herramientas y mensajes del sistema por sí solos representan alrededor de 36 000 tokens. Si el umbral de recorte no resta esos costos fijos primero, el agente puede terminar recortando un presupuesto que ya se superó antes de que se incluyera cualquier historial.
El tercero es el descubrimiento de límites de contexto. El límite de contexto es el denominador de todo cálculo presupuestario. Si la consulta de metadatos del modelo falla y el código vuelve silenciosamente a un valor predeterminado codificado, todas las decisiones de recorte posteriores son incorrectas.
El mejor enfoque es dejar de tratar el historial de la conversación como el registro de lo sucedido. Para un flujo de trabajo científico, ya dispone de un registro más fiable: el registro estructurado de cada paso que dio el agente, con parámetros y resultados exactos. A esto lo llamamos el estado mundial.
El estado mundial es un objeto de Python que rastrea el análisis a medida que avanza. Cada llamada a la herramienta que se completa escribe una entrada estructurada: qué paso se ejecutó, con qué parámetros y cuáles fueron los resultados. Esto se serializa en el indicador del sistema en cada iteración. Se necesitan menos de 1000 tokens, contiene los parámetros exactos en lugar de un resumen en prosa de ellos y se encuentra en el indicador del sistema, que nunca se recorta. Cuando los resultados de herramientas antiguas se eliminan del historial de mensajes, el registro de análisis sobrevive intacto.
Esto cambia su forma de pensar sobre el recorte. En lugar de tratar el historial de mensajes como algo valioso que debe preservarse porque contiene el registro de lo que sucedió, puede recortarlo agresivamente porque el registro está en otra parte. La historia se convierte en un contexto útil. El Estado mundial se convierte en la verdad fundamental.
El Estado mundial se ocupa de la cuestión de qué preservar. Las correcciones restantes abordan la cuestión de cómo saber cuándo recortar y en qué medida.
La primera solución fue dejar de tratar toda la ventana de contexto como historial disponible. El presupuesto disponible se calcula restando los costos fijos por adelantado:
disponible = (límite_contexto – tokens_esquema_herramienta – tokens_sistema – RESERVA_COMPLETACIÓN – margen_seguridad)
Con una ventana de contexto de 262 KB y una sobrecarga típica, esto deja alrededor de 219 000 tokens para el historial de mensajes. Con un contexto más estricto de 32K, informa correctamente solo unos pocos miles de tokens disponibles. Eso es útil. Le indica inmediatamente que las sesiones largas no funcionarán en ese tamaño de contexto, en lugar de fallar silenciosamente 3 iteraciones más tarde.
La segunda solución fue la autocalibración del recuento de tokens. En lugar de intentar igualar las reglas exactas de tokenización de Qwen, utilizamos la propia respuesta de la API para corregir nuestras estimaciones. Después de cada llamada, la respuesta incluye la cantidad real de tokens procesados. Comparamos eso con nuestra estimación y ajustamos el factor correcto hacia arriba si el recuento real fue mayor:
si tokens_actuales > nuestra_estimación: calibración = max(calibración, tokens_actuales / nuestra_estimación) calibración = min(calibración, 4.0)
El factor sólo aumenta. Una sobreestimación provoca un recorte ligeramente más frecuente. Una subestimación hace que falle la siguiente llamada. Las consecuencias son asimétricas, por lo que la corrección es unidireccional.
La tercera solución fue recortar estratégicamente en lugar de uniformemente. Al acercarse al presupuesto, el agente recopila los resultados de las herramientas elegibles, los clasifica por tamaño y elimina primero los más grandes. Una única salida de ejecución de código grande puede contener de 50 a 200 KB de registros, tablas o datos de trazado codificados en base64. Eliminar un bloque grande puede ahorrar tanto contexto como eliminar docenas de mensajes pequeños. Los mensajes de usuario nunca se recortan. Contienen la intención científica y las limitaciones que definen lo que se supone que debe hacer el análisis.
En conjunto, estos cambios hicieron que el agente fuera realmente utilizable. Ahora se ejecuta un análisis completo de más de 50 iteraciones sin que el usuario vea un error de contexto.
Conclusión
La ejecución de un LLM localmente para una carga de trabajo agente real expone problemas que son fáciles de pasar por alto cuando se utiliza una API en la nube. El modelo no sólo tiene que ser bueno. El servidor de inferencia debe configurarse deliberadamente y la ventana contextual debe administrarse deliberadamente. Ninguno de los problemas es imposible, pero tampoco es automático.
Las optimizaciones en la Parte 1 se combinan de maneras que no son obvias desde el principio. Los gráficos CUDA toman una base apenas funcional y la hacen utilizable. El almacenamiento en caché de prefijos cambia la sensación interactiva del agente al evitar el costo de volver a leer el mismo prefijo de 36 000 tokens en cada llamada. La caché FP8 KV aumenta la cantidad de contexto que cabe en la memoria. MTP agrega un rendimiento de decodificación significativo además. En conjunto, estos cambios llevan al agente de 10 a 15 segundos por iteración a aproximadamente de 1 a 3 segundos.
Los cambios en la gestión del contexto en la Parte 2 resuelven un problema diferente: la corrección. Un agente científico veterano necesita recordar lo que hizo, no simplemente continuar la conversación. La historia de la conversación es un contexto útil, pero es una frágil fuente de verdad. Crece, se recorta y, finalmente, hay que comprimirlo o desecharlo. El enfoque del estado mundial, en particular, es algo que recomendaría a cualquiera que cree un agente de dominio específico para flujos de trabajo científicos o analíticos. El registro duradero debe vivir fuera de la transcripción, en un estado estructurado que registre cada paso con parámetros y resultados exactos.
Esa fue la principal lección de la construcción de este sistema. Un agente útil no es sólo un LLM con herramientas. Es un circuito con infraestructura a su alrededor. El modelo decide qué hacer a continuación, pero el sistema que lo rodea determina si el bucle es lo suficientemente rápido, estable y confiable para terminar el trabajo.
¡Gracias por leer y espero que te haya resultado útil!