
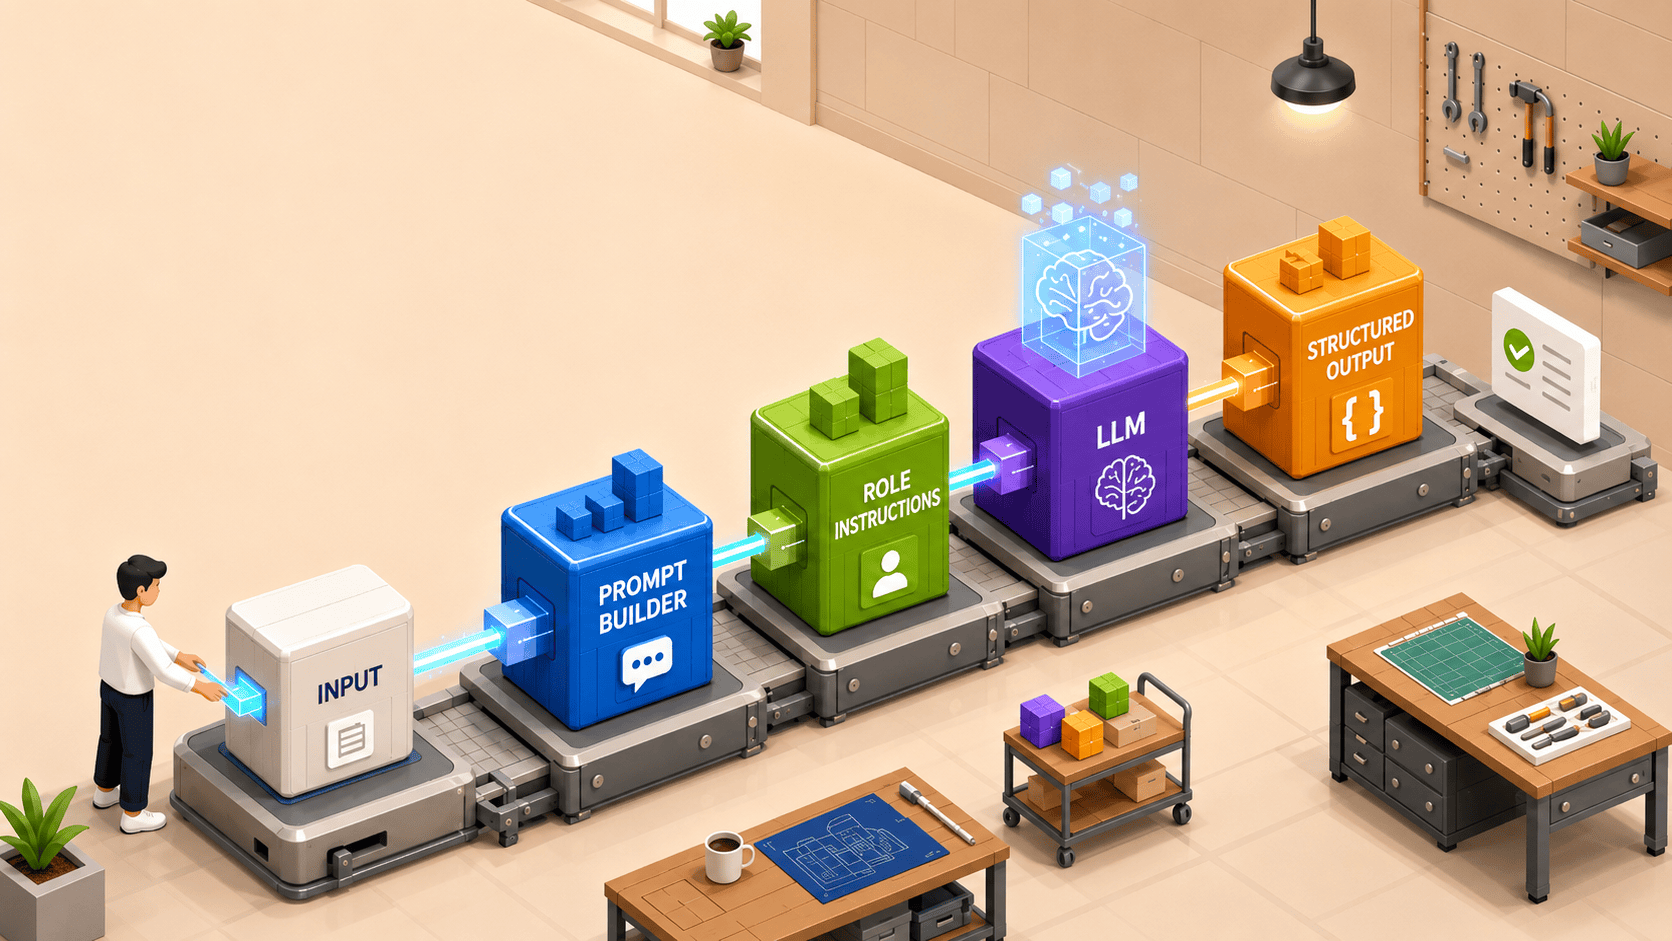
una solicitud de LLM.
Ok, el primer pensamiento que te viene a la mente es: ¡construyamos un agente poderoso!
Pero inmediatamente te preguntas: ¿qué framework de agente debería utilizar? ¿Debería ser CrewAI? ¿LangGraph? ¿Marco del agente de Microsoft? ¿O algo más?
Luego abre algunas páginas de documentación, compara ejemplos e intenta decidir qué marco se adapta mejor al problema que tiene entre manos. Pasaron un par de horas, te sientes abrumado y ni siquiera has empezado a codificar.
Pero espere un segundo: ¿realmente necesita un marco de agente aquí? De hecho, ¿necesita siquiera crear un agente de LLM?
En los últimos dos años, he creado bastantes aplicaciones de LLM en diferentes dominios. Una lección que aprendí es que para muchas aplicaciones LLM útiles, lo que al final funciona de manera confiable no es realmente un agente autónomo. Es un flujo de trabajo.
Y para crear flujos de trabajo, es posible que ni siquiera necesite ningún marco en primer lugar.
En esta publicación, le mostraré cómo crear un prototipo de un flujo de trabajo de LLM utilizando Python simple, funciones locales, resultados estructurados y la API OpenAI Responses (el mismo patrón también se aplica a otros proveedores de LLM). Nos pondremos manos a la obra y resolveremos un problema de explicación de anomalías.
Mi objetivo aquí no es argumentar que los marcos sean malos. Son claramente útiles en varios escenarios y lo discutiremos al final de esta publicación. Mi objetivo es mostrar que, para muchas aplicaciones, un flujo de trabajo claro puede ser la primera abstracción que realmente se necesita.
1. Pruebe los flujos de trabajo antes de pasar a los agentes
Un agente LLM generalmente se refiere a un sistema autónomo que puede decidir por sí mismo qué hacer a continuación.
Le das un objetivo y un conjunto de herramientas. Luego planificará, actuará, observará el resultado y continuará iterando. En lugar de seguir un camino fijo, el agente elige dinámicamente el siguiente paso en función de la situación actual. Para problemas abiertos, esto es poderoso.
Pero muchos problemas del mundo real no son tan abiertos.
En muchos casos, sabemos aproximadamente cómo se debe resolver el problema. Pero si ya lo sabemos, ¿por qué pedirle al modelo que reinvente la rueda?
Aquí es donde entran los flujos de trabajo.
En un flujo de trabajo de LLM, los desarrolladores definimos los pasos principales y el LLM se utiliza dentro de los pasos seleccionados como motor de razonamiento. Esta sigue siendo una aplicación impulsada por LLM. La diferencia es que el LLM no se trata como el sistema completo. Se trata sólo como un nodo de decisión dentro de un proceso más amplio.
Entonces, ¿cuáles son los beneficios de adoptar un flujo de trabajo LLM? Los siguientes puntos son importantes en mi opinión:
Un flujo de trabajo es transparente. Puede examinarlo fácilmente, ya que cada paso tiene una función bien definida y un contrato de entrada y salida claro. Un flujo de trabajo es modular, lo que significa que puede cambiar un paso sin tener que reescribir toda la aplicación. Lo más importante es que un flujo de trabajo tiene un flujo de control determinista. El razonamiento y las decisiones del LLM aún pueden variar dentro de un paso, pero el camino general depende del código. Eso por sí solo elimina mucha incertidumbre cuando intentamos construir algo confiable.
Lo sé, esto suena menos emocionante que crear un agente totalmente autónomo. Pero su objetivo es ofrecer una solución eficaz. Si las cosas aburridas funcionan, entonces deberíamos usarlas con gusto.
2. Lo que realmente necesitamos diseñar
En mi experiencia, hay cuatro ingredientes clave:
Flujo de control Instrucciones de rol (solicitudes del sistema) Generadores de solicitudes Salida estructurada
Déjame descomprimir cada uno de ellos.
2.1 Controlar el flujo
El flujo de control define cómo la aplicación pasa de la entrada a la salida.
Una forma útil de pensar en el flujo de control es verlo como un gráfico. En este gráfico, tenemos nodos y aristas:
Nodos: cada nodo representa un paso en la aplicación. Puede ser un paso de procesamiento determinista realizado por el código (por ejemplo, cargar datos, llamar a una función local). También puede ser un paso de LLM, donde se emplea un LLM para tomar una decisión, extraer información o escribir una explicación. Bordes: cada borde representa cómo la información se mueve de un paso al siguiente. Al igual que los nodos, las aristas también tienen diferentes tipos. Por ejemplo, el borde puede ser estático, es decir, siempre llama a un siguiente paso predefinido después de procesar el paso actual; o puede ser condicional, por ejemplo, si el LLM en los pasos actuales dice que se necesita más evidencia, el borde se vincula a un nodo de herramienta local; Si el LLM cree que se ha reunido suficiente evidencia, el borde apunta a la explicación final.
Una cosa clave: en un flujo de trabajo, el código es dueño de este gráfico. Los LLM están vinculados a nodos específicos en lugar de ejecutarse libremente.
Comenzaría aquí, ya que te obliga a pensar primero en lo que realmente tiene que hacer la aplicación, qué tareas deben manejarse mediante código determinista, cuáles van a LLM, dónde se bifurca el flujo de trabajo y cuándo debe detenerse.
2.2 Instrucciones de rol
Un flujo de trabajo normalmente utiliza LLM en varias funciones, y cada función necesita su propia instrucción (indicaciones del sistema).
Una instrucción de rol define cómo debe comportarse el LLM dentro de un nodo específico. Por lo general, le dice al LLM su personalidad, qué tareas está realizando, a qué debe prestar atención y qué evitar. Cualquier regla específica del dominio también debe especificarse aquí.
2.3 Constructores de avisos
Mientras que las instrucciones de rol definen cómo debe comportarse un LLM, los creadores de indicaciones deciden qué puede ver el LLM.
Los creadores de solicitudes ensamblan el contexto para una llamada de LLM en función del objetivo de este LLM y el estado actual del flujo de trabajo.
En la práctica, es solo una función: toma los valores dinámicos del flujo de trabajo actual, opcionalmente los preprocesa y los introduce en una plantilla de solicitud. El resultado es la carga útil final enviada al LLM.
Los constructores de mensajes son donde controlamos la ventana de contexto. El contexto debe ser adaptado y suficiente para respaldar el razonamiento de LLM.
2.4 Salida estructurada
En un flujo de trabajo, los resultados del LLM suelen ser resultados intermedios que se consumen en el siguiente paso. Permitir que LLM genere textos de formato libre no es una buena idea aquí, ya que hace que el análisis posterior sea frágil.
Un mejor enfoque sería pedir a los LLM que devuelvan una salida estructurada que siga un esquema de datos predefinido, comúnmente representado como un objeto JSON o un modelo Pydantic.
Ese esquema es el contrato entre los pasos del LLM. Al diseñar el esquema, es necesario pensar qué campos deberían existir, qué tipos deberían tener y qué valores están permitidos. Cuando la salida del modelo sigue ese esquema, el siguiente paso puede leer los campos directamente.
De hecho, la salida estructurada también es lo que permite la llamada a herramientas/funciones. Específicamente, le damos al esquema un campo para el nombre de una función y otro para sus argumentos, y el siguiente paso puede leer ambos y dejar que Python ejecute la función local correspondiente.
Ahora que hemos visto cuatro ingredientes principales del flujo de trabajo, es hora de ver cómo funcionan en acción.
3. Construyamos un flujo de trabajo real
Aquí, creamos un pequeño flujo de trabajo de investigación de calidad de datos utilizando el conjunto de datos Iris (CC BY 4.0).
En la práctica, a menudo necesitamos examinar conjuntos de datos y marcar registros sospechosos antes de enviarlos al entrenamiento del modelo. Pero señalar por sí solo rara vez es suficiente; A menudo, también queremos entender el por qué: ¿se trata de un problema real de calidad de los datos y qué evidencia respalda esa evaluación?
Aquí es donde los LLM pueden ayudar.
3.1 Configuración del problema
Para este estudio de caso, utilizamos el conjunto de datos Iris. Por supuesto, Iris es un conjunto de datos de clasificación sin anomalías etiquetadas. Pero para hacer las cosas más interesantes, perturbamos deliberadamente una muestra: esta muestra tiene la etiqueta versicolor, pero cambiamos las medidas de sus sépalos a valores inusuales. Esto nos da una clara anomalía en la calidad de los datos a nivel de característica.
Después de eso, seguimos un flujo de trabajo de detección normal. Primero, aprovechamos una lógica simple para señalar muestras sospechosas. Luego, utilizamos LLM para diagnosticar la muestra marcada y producir una evaluación con evidencia.
Nuestro flujo de trabajo tiene dos funciones LLM. El primero es un investigador de LLM que determina qué evidencia de diagnóstico recopilar a continuación. Este paso implica llamar a herramientas que tenemos predefinidas. El segundo es un explicador de LLM. Su trabajo es recibir la evidencia recopilada y producir una evaluación final con confianza.
Construiremos este flujo de trabajo sin utilizar ningún marco agente.
3.2 Paso 0: Preparación de la convocatoria LLM
Comenzamos definiendo un asistente reutilizable para llamar al LLM:
cliente = AzureOpenAI( api_key=os.environ["OPENAI_API_KEY"], azure_endpoint=os.environ["OPENAI_API_BASE"], api_version=os.environ["OPENAI_API_VERSION"], ) def call_llm( nombre_paso: str, instrucciones: str, solicitud: str, esquema_salida: tipo[BaseModel], ) -> BaseModel: """Llame al LLM una vez y devuelva una salida estructurada analizada.""" modelo = "gpt-5.4-mini" iniciado = time.perf_counter() respuesta = client.responses.parse( modelo=modelo, instrucciones=instrucciones, entrada=prompt, razonamiento={"effort": "medium"}, text_format=output_schema, ) uso = respuesta.usage.model_dump() si respuesta.usage else {} llm_telemetry.append( { "paso": nombre_paso, "esquema": esquema_salida.__nombre__, "modelo": modelo, "prompt_chars": len(prompt), "elapsed_s": round(time.perf_counter() – iniciado, 2), "input_tokens": use.get("input_tokens"), "output_tokens": use.get("output_tokens"), "total_tokens": use.get("total_tokens"), } ) devuelve respuesta.output_parsed
Aquí, utilizamos la API de respuestas de OpenAI, que nos permite especificar las instrucciones del sistema, el mensaje de entrada y el esquema de salida. Para nuestra tarea actual, utilizamos GPT-5.4-mini con un esfuerzo de pensamiento medio. Además, agregamos algo de telemetría liviana para registrar la latencia y los costos. Tenga en cuenta que necesitamos usar output_parsed para recuperar la salida estructurada.
3.3 Paso 1: Examinar muestra sospechosa
Ahora entramos en el paso de selección.
El propósito de este paso es emplear una lógica de detección simple para señalar muestras de datos anormales. Este paso no necesita un LLM.
Concretamente, para cada muestra, calculamos puntuaciones z por característica en relación con las muestras con la misma etiqueta de especie. Mantenemos la puntuación z absoluta más grande como "puntuación de anomalía".
La fila 55 está identificada correctamente, ya que esta es la muestra que modificamos:

Vale, pero en un entorno práctico, la identificación por sí sola no dice nada sobre cómo o por qué. Necesitamos echar un vistazo más de cerca en el siguiente paso.
3.4 Paso 2: Recopilación iterativa de evidencia
En este paso, queremos que el LLM primero recopile evidencia suficiente antes de intentar explicar la muestra anormal. Con ese fin, configuramos un rol de investigador de LLM para realizar esta tarea de recopilación de evidencia.
Comenzamos configurando su instrucción de rol, siguiendo una estructura Rol-Tarea-Salida esperada-Reglas:
# Nota: Esta instrucción ha sido pulida por AI INVESTIGATOR_INSTRUCTIONS = """ [Rol]: usted es un investigador de calidad de datos que revisa un registro marcado de un conjunto de datos tabulares de medición del iris. Cada registro contiene mediciones de sépalos, medidas de pétalos y una etiqueta de especie. [Tarea]: su trabajo es recopilar evidencia de diagnóstico que ayudará a un analista separado a evaluar por qué el registro puede ser anormal. Usted no es responsable de realizar la evaluación final. En cada paso, revise el registro marcado y cualquier evidencia ya existente. Luego decida si se necesita una verificación de diagnóstico más o si la evidencia disponible es suficiente. [Resultado esperado]: devuelva una solicitud para una función de diagnóstico, incluido el nombre de la función y los argumentos concretos, o una decisión de que se ha recopilado suficiente evidencia. [Reglas]: No invente mediciones, perfiles de especies, registros de vecinos o resultados de herramientas.
Para este investigador, exponemos dos herramientas locales. Una es comparar la muestra marcada con el perfil de la especie utilizando la puntuación z por característica, de modo que LLM pueda juzgar qué tan estadísticamente inusual parece la muestra actual:
CARACTERÍSTICAS = [ "sepal_length_cm", "sepal_width_cm", "petal_length_cm", "petal_width_cm", ] def compare_row_to_species_profile(row_id: int, especie: str) -> dict[str, Any]: """Compare una fila con el perfil de una especie utilizando puntuaciones z a nivel de característica.""" fila = trabajando_df.loc[working_df["row_id"] == fila_id].iloc[0]perfil_rows = work_df[(working_df["especies"] == especie) & (working_df["row_id"] != row_id)] perfil_stats = perfil_rows[CARACTERÍSTICAS].agg(["mean", "std"]) feature_comparisons =[]para característica en CARACTERÍSTICAS: media = perfil_stats.loc["media", característica] std = perfil_stats.loc["std", característica] valor = float(fila[característica]) característica_comparisons.append( { "característica": característica, "valor": valor, "especie_media": round(float(media), 3), "species_std": round(float(std), 3), "zscore": round(float((valor – media) / std), 3), } ) return { "row_id": row_id, "species": especie, "feature_comparisons": feature_comparisons, }
La otra es encontrar las K muestras más cercanas utilizando la biblioteca estándar scikit-learn. Esto le permite al LLM comprender qué muestras se parecen más al registro marcado en el espacio de medición:
def find_nearest_neighbors(row_id: int, k: int = 5) -> dict[str, Any]: """Buscar filas más cercanas con un modelo KNN en mediciones estandarizadas.""" rows =working_df.reset_index(drop=True) row_position = rows.index[rows["row_id"] == row_id][0]scaled_features = StandardScaler().fit_transform(rows[FEATURES]) knn = NearestNeighbors(n_neighbors=k + 1).fit(scaled_features) distancias, vecino_positions = knn.kneighbors(scaled_features[[row_position]]) vecinos =[]para distancia, posición_vecino en zip(distancias[0], posiciones_vecinos[0]): if posición_vecino == posición_fila: continuar vecino = filas.iloc[posición_vecino] vecinos.append( { "row_id": int(vecino["row_id"]), "especie": str(vecino["especie"]), "distance": round(float(distancia), 3), "medidas": {característica: float(vecino[característica]) para función en CARACTERÍSTICAS}, } ) return {"row_id": fila_id, "vecinos": vecinos}
Ahora que hemos definido las herramientas locales, debemos decirle al LLM qué puede ver en cada paso de la investigación. Este es el trabajo del constructor de mensajes:
def build_investigation_prompt( flagged_row: dict[str, Any], Collected_evidence: list[dict[dict[str, Any]], ) -> str: return f""" Registro marcado: {json.dumps(flagged_row, indent=2)} Evidencia recopilada hasta el momento: {json.dumps(collected_evidence, indent=2)} Funciones de diagnóstico disponibles: {json.dumps(TOOL_DESCRIPTIONS, indent=2)} Tarea: Decida si solicitar una función de diagnóstico más o detenerla porque se ha recopilado suficiente evidencia """.strip().
Hay dos entradas:
flagged_row es la muestra que se está investigando actualmente. Consta del ID de la fila, las cuatro medidas y la etiqueta de la especie. Collected_evidence es una lista de resultados de diagnóstico recopilados en rondas anteriores. Al principio, esta lista está vacía. Después de cada llamada a la herramienta, el flujo de trabajo agrega el resultado de la herramienta a esta lista y lo devuelve a la siguiente llamada LLM.
TOOL_DESCRIPTIONS es el pequeño menú de funciones expuestas al LLM:
TOOL_DESCRIPTIONS = [ { "name": "compare_row_to_species_profile", "description": "Compare una fila con un perfil de especie usando puntuaciones z a nivel de característica.", "arguments": {"row_id": "integer", "species": "setosa | versicolor | virginica"}, }, { "name": "find_nearest_neighbors", "description": "Buscar filas más cercanas con un KNN modelo en medidas estandarizadas.", "arguments": {"row_id": "integer", "k": "integer"}, }, ]
El ciclo de investigación se implementa directamente en Python:
evidencia_recopilada =[]para round_id en rango(1, MAX_ROUNDS + 1): decisión = call_llm( step_name=f"investigator_row_{row_id}_round_{round_id}", salida_schema=InvestigationDecision, instrucciones=INVESTIGATOR_INSTRUCTIONS, rápido=build_investigation_prompt(flagged_row, recopilar_evidencia),) if decision.status == "enough_evidence": break resultado_herramienta = ejecutar_llamada_herramienta (id_fila, decisión) evidencia_recopilada.append(resultado_herramienta)
En el bucle, una vez que el investigador de LLM devuelve una decisión, Python es responsable de ejecutar la función local seleccionada. La función se define de la siguiente manera:
def ejecutar_tool_call(row_id: int, decisión: InvestigaciónDecisión) -> dict[str, Cualquiera]: if decisión.tool_name == "compare_row_to_species_profile": argumentos = {"species": decisión.species} resultado = comparar_row_to_species_profile(row_id=row_id, **argumentos) else: argumentos = {"k": decisión.k} resultado = find_nearest_neighbors(row_id=row_id, **argumentos) return { "herramienta": decisión.nombre_herramienta, "argumentos": argumentos, "resultado": resultado, }
El bucle anterior utiliza el esquema de salida InvestigationDecision, que se define a continuación:
desde escribir import Literal desde pydantic import BaseModel, Field Species = Literal["setosa", "versicolor", "virginica"] ToolName = Literal["compare_row_to_species_profile", "find_nearest_neighbors"] class InvestigationDecision(BaseModel): status: Literal["need_more_evidence", "enough_evidence"] = Field( …, descripción="Si hay otra llamada a función local útil.", ) razonamiento: str = Campo(…, descripción="Breve justificación basada en evidencia.") nombre_herramienta: NombreHerramienta | Ninguno = Campo( Ninguno, descripción="Función de diagnóstico local a llamar, o nula cuando la evidencia es suficiente.", ) especie: Especie | Ninguno = Campo( Ninguno, descripción="Perfil de especie con el que comparar; solo se usa para comparar_fila_con_perfil_especie.", ) k: int | Ninguno = Campo (Ninguno, descripción="Número de filas más cercanas a devolver; solo se usa para find_nearest_neighbors.",)
Aquí, se utiliza Pydantic, una biblioteca de Python para definir modelos de datos tipificados, para definir el esquema. En Pydantic, Campo(…) significa que este campo es obligatorio y esto se aplica al estado y al razonamiento. Sin embargo, para otros campos, solo son necesarios cuando el investigador de LLM desea llamar a una función local. Como resultado, su tipo es ToolCall/Species/int | Ninguno y su valor predeterminado es Ninguno.
¡Excelente! Este fue el paso más denso del flujo de trabajo. Pero ese también es el punto: una vez que hacemos explícitos la instrucción de rol, el generador de indicaciones, el esquema, las herramientas y el bucle, no queda ninguna orquestación oculta.
Ahora podemos pasar al paso final de explicación del LLM. Verás cómo el patrón se repite.
3.5 Paso 3: Explicación de la muestra marcada
Una vez reunida la evidencia, el paso final es pedirle a otro LLM que interprete la evidencia y genere una evaluación.
Configuramos el explicador de LLM con una instrucción de rol separada:
# Nota: Esta instrucción ha sido pulida por AI EXPLAINER_INSTRUCTIONS = """ [Rol]: usted es un analista de calidad de datos que revisa un registro marcado de un conjunto de datos tabulares de medición del iris. Cada registro contiene mediciones de sépalos, medidas de pétalos y una etiqueta de especie. [Tarea]: su trabajo es producir la evaluación final para el registro marcado utilizando el registro mismo y la evidencia de diagnóstico recopilada. Decida si la evidencia apunta a una característica atípica, una posible etiqueta incorrecta, un límite de clase caso, o ningún problema claro. [Resultado esperado]: Devuelva una evaluación concisa con un nivel de confianza, una justificación de confianza, una explicación humana y la evidencia clave que respalda la evaluación. [Reglas]: Use solo el registro marcado y la evidencia de diagnóstico proporcionada en el mensaje. De lo contrario, use una confianza baja.
El generador de indicaciones para el explicador de LLM es más simple que el del investigador, porque solo necesita pasar el registro marcado y la evidencia de diagnóstico recopilada por el investigador:
def build_explanation_prompt( flagged_row: dict[str, Any], recopilado_evidence: list[dict[dict[str, Any]], ) -> str: return f""" Registro marcado: {json.dumps(flagged_row, indent=2)} Evidencia de diagnóstico: {json.dumps(collected_evidence, indent=2)} Tarea: Evaluar esta fila marcada y explicar la evidencia. """.tira()
Finalmente, definimos el resultado estructurado para el explicador LLM:
class CandidateExplanation(BaseModel): evaluación: Literal[ "likely_mislabel", "feature_outlier", "class_boundary_case", "no_clear_issue", ] = Field(…, descripción="Mejor interpretación basada en evidencia de la fila marcada.") confianza: Literal["low", "high"] = Field( …, descripción="Alta cuando la evidencia respalda firmemente la evaluación; baja en caso contrario.", ) confianza_rationale: str = Field( …, descripción="Por qué este nivel de confianza es apropiado dada la evidencia recopilada.", ) explicación: str = Field(…, descripción="Explicación concisa para un revisor humano.") key_evidence: list[str] = Field(…, descripción="Elementos de evidencia que respaldan la evaluación.")
Tenga en cuenta que predefinimos un pequeño conjunto de posibles categorías para la evaluación. Esta es una estrategia común en la práctica, donde podemos inyectar conocimiento del dominio en el flujo de trabajo y evitar que el LLM invente etiquetas arbitrarias.
Finalmente, podemos reutilizar el mismo asistente call_llm para iniciar la llamada explicativa:
explicación = call_llm( step_name=f"explainer_row_{row_id}", salida_schema=CandidateExplanation, instrucciones=EXPLAINER_INSTRUCTIONS, aviso=build_explanation_prompt(fila_marcada, evidencia_recopilada),)
Esto completa el flujo de trabajo.
4. Ejecutar el flujo de trabajo de un extremo a otro
Ahora que tenemos el flujo de trabajo completo, vamos a darle una vuelta. Solo un rápido recordatorio del flujo de trabajo que hemos creado:
Un paso de detección de Python señala un registro sospechoso. Un investigador de LLM que recopila evidencia de diagnóstico mediante llamadas iterativas a herramientas. Un explicador de LLM que convierte la evidencia recopilada en una evaluación final.
Después de ejecutar el flujo de trabajo, vimos que el investigador del LLM tomó cuatro rondas para recopilar la evidencia, que luego se introdujo en el explicador del LLM. La evaluación final producida es feature_outlier con alta confianza. El fundamento dado por el explicador de LLM es el siguiente:
"La muestra actual parece una característica atípica porque las medidas de sus sépalos son extremas, mientras que las medidas de sus pétalos siguen siendo ampliamente compatibles con el versicolor".
Esta valoración es correcta. De hecho, modificamos deliberadamente la muestra para que tenga valores de características atípicos. Por lo tanto, una etiqueta feature_outlier es apropiada.
Podemos inspeccionar más a fondo el rastro completo del investigador para comprender qué pruebas se recopilaron:
Podemos ver que el investigador del LLM ha seguido un camino sensato para reunir pruebas. Primero verificó el perfil de la especie etiquetada, luego inspeccionó a los vecinos más cercanos y finalmente comparó la fila con una especie alternativa. Después de estas verificaciones, decidió que la evidencia era suficiente para que el explicador produjera una evaluación significativa de las características atípicas.
Esto completa el estudio de caso. Creamos un flujo de trabajo LLM pequeño pero completamente funcional utilizando Python simple. El flujo de trabajo es iterativo e inspeccionable. ¡Nada mal!
5. ¿Cuándo necesitamos realmente agentes o marcos?
Hasta ahora, hemos evitado intencionalmente tanto los agentes como los marcos. Pero esto no significa que no sean útiles.
Es sólo una cuestión de qué tipos de problemas estamos resolviendo.
Aquí resulta útil separar dos decisiones que a menudo se confunden. La primera es cuánta autonomía le otorga al LLM, con un flujo de trabajo fijo y un agente que funciona libremente en los dos extremos del espectro. La segunda es si adoptas las abstracciones de otra persona. Puede desarrollar manualmente un Python simple desde cero o adoptar un marco establecido. Estas son opciones independientes, y nuestro caso de estudio se encontraba en un rincón, es decir, en un flujo de trabajo hecho a mano.
Luego podremos ver cuándo tiene sentido moverse a lo largo de cada eje.
5.1 Cuando realmente necesitas un agente
Respuesta corta: cuando no se conoce de antemano cuál es la mejor solución. Y puede suceder en dos escenarios.
El primer escenario es que simplemente no sabes cómo resolver el problema. No existe un procedimiento establecido ni conocimientos de dominio para codificar.
El segundo escenario es que usted sabe algo sobre cómo resolver el problema. Pero el problema es que el espacio de caminos factibles es tan vasto que enumerarlos a mano es simplemente imposible. O no podemos cubrir todas las ramas, o podemos, pero solo agregando tantas aristas condicionales que hagan que el flujo de trabajo sea difícil de razonar.
Pero tenga en cuenta al adoptar los agentes LLM: obtendrá flexibilidad, pero a costa de la confiabilidad y la depuración. Esas son exactamente las cosas que un flujo de trabajo te ofrece de forma gratuita.
Entonces, antes de adoptar los agentes LLM, pregúntese: ¿su problema es lo suficientemente abierto como para necesitar ese poder?
5.2 Cuando realmente necesitas un marco
Incluso si ha decidido que un flujo de trabajo tiene la forma correcta, aún puede buscar un marco para construirlo.
Mi experiencia es que una versión simple de Python es excelente para crear prototipos rápidamente. Puede concentrarse mucho en saber si el flujo de trabajo puede funcionar y cómo debería verse, sin preocuparse por aprender la sintaxis de ninguna biblioteca.
Sin embargo, ese cálculo cambia cuando pasas de preguntar "¿Funciona esto?" a "¿Esto sigue funcionando en producción?"
Ese es el vacío que llenan los marcos, con un mejor manejo de fallas, observabilidad, control humano en el circuito, persistencia, etc.
En resumen, los marcos son excelentes para resolver los problemas que pueda tener después de que su idea funcione.
6. Entonces, ¿qué aprendimos?
Para muchas aplicaciones LLM útiles, lo primero que necesita probablemente no sea un agente autónomo o un marco pesado.
Lo que necesita es un flujo de trabajo claro, con flujo de control, instrucciones de roles, creadores de mensajes, resultados estructurados y código Python simple para conectarlos.
Y no se preocupe si el flujo de trabajo hecho a mano será un esfuerzo inútil. No lo hará. El flujo de control, las indicaciones, los esquemas y las herramientas que escribe a mano pueden transferirse si luego realiza la transición a un agente o un marco.
Comience de manera simple, valide la idea clave rápidamente y luego agregue complejidad solo cuando el problema lo requiera.