
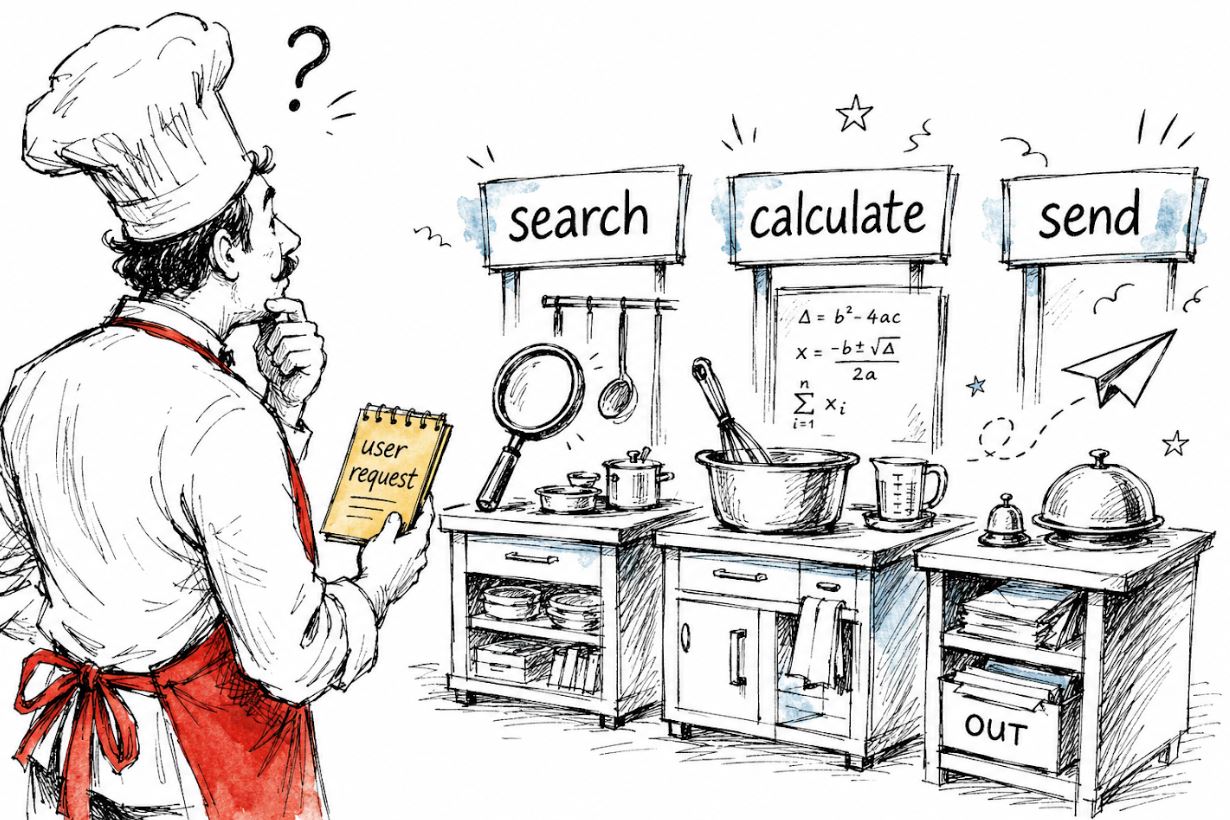
En mi última publicación, cómo obtener resultados estructurados y legibles por máquina como respuesta de un LLM, usando el modo JSON, llamadas a funciones y resultados estructurados. En esa publicación, abordamos brevemente la idea de la llamada a funciones, acercándola como un método para obtener respuestas estructuradas. Sin embargo, la llamada a funciones es algo que va mucho más allá de simplemente recuperar datos estructurados de un modelo, ya que es esencialmente la columna vertebral de los flujos de trabajo de IA agentes. Entonces, en la publicación de hoy, analizaremos más de cerca exactamente este tema.
En todos los ejemplos que hemos cubierto hasta ahora, el LLM simplemente se utiliza como respondedor pasivo, lo que significa que recibe una pregunta y luego genera una respuesta, y eso es todo. Pero, ¿qué pasa si queremos que el LLM no solo responda con algo sino que haga algo? O para decirlo más precisamente, ¿qué pasa si queremos que se desencadene una acción en función de la respuesta del modelo? Esta acción puede ser cualquier cosa: buscar datos en vivo, enviar un mensaje, consultar una base de datos, llamar a una API externa, etc.
Esto es posible con la llamada de herramientas. La llamada a herramientas es lo que transforma un LLM de un generador de texto muy inteligente a algo que realmente puede desencadenar acciones e interactuar con el mundo que lo rodea.
Entonces, ¡echemos un vistazo!
¿Qué es la llamada a herramientas?
La llamada a herramientas (también llamada llamada a funciones) es el mecanismo mediante el cual un LLM puede solicitar la ejecución de funciones externas o API como parte de la generación de su respuesta. En otras palabras, en lugar de simplemente devolver texto, el modelo puede ejecutar una función específica con argumentos específicos, como respuesta a la solicitud del usuario.
La clave que hay que entender aquí es que el modelo en sí no ejecuta la herramienta. Sólo decide a qué herramienta llamar y con qué argumentos. La ejecución real de la herramienta seleccionada ocurre en nuestro propio código, en el que se incluye la solicitud al modelo de IA. Luego, alimentamos el resultado de la herramienta al modelo de IA, que lo utiliza para generar una respuesta final para el usuario.
Este es el bucle de llamada a la herramienta, que incluye los siguientes pasos:
El usuario envía un mensaje. El modelo de IA toma el mensaje como entrada y produce una salida, que es esencialmente una decisión sobre qué herramienta utilizar y con qué argumentos. La respuesta del modelo que contiene la selección de herramientas y los respectivos argumentos que se utilizarán se devuelve al código. El código, sin la participación del modelo de IA, ejecuta la herramienta seleccionada con los argumentos seleccionados. Esta ejecución produce algún tipo de resultado (por ejemplo, un cálculo, información obtenida de una API, etc.) y este resultado luego se devuelve al modelo de IA. El modelo de IA toma como entrada el resultado de la herramienta y produce una respuesta final al usuario en base a eso.
Nuevamente, el modelo genera una llamada de herramienta, no una ejecución de herramienta. Las dos son cosas muy diferentes y combinarlas es una de las fuentes de confusión más comunes.
Pero ¿qué es exactamente una llamada a una herramienta? En la práctica, significa que el modelo devuelve una respuesta estructurada y legible por máquina mediante llamadas a funciones, como vimos en la publicación anterior. En esta respuesta, el contenido es Ninguno; no hay una respuesta en lenguaje natural, solo una instrucción estructurada que indica a qué herramienta llamar y con qué argumentos. Solo después de ejecutar la herramienta y devolver el resultado, el modelo genera una respuesta de texto real para el usuario.
¡Pero veamos esto en la práctica!
Comenzaremos con un ejemplo simple usando solo una herramienta y una llamada, y luego desarrollaremos progresivamente algunos escenarios más interesantes.
1. Una única herramienta: API meteorológica
Creo que el ejemplo más común de uso de herramientas con IA que me viene a la mente es una API meteorológica (la piedra angular de los datos personalizados y en vivo), así que imaginemos que estamos creando un asistente meteorológico. En particular, queremos crear un mecanismo en el que el usuario pregunte sobre el clima y, en lugar de simplemente dejar que el modelo de IA invente algo (lo que el modelo haría con mucho gusto 🙃), queremos que llame a una función meteorológica real y obtenga datos reales sobre el clima de otro lugar, fuera del LLM. Para obtener los datos meteorológicos, utilizaré Open-Meteo, una API meteorológica gratuita y de código abierto que felizmente no requiere clave API.
Para utilizar una herramienta, inicialmente debemos declararla en herramientas.
from openai import OpenAI import json client = OpenAI(api_key="your_api_key") # Paso 1: definir la herramienta herramientas = [ { "type": "function", "function": { "name": "get_current_weather", "description": "Obtener el clima actual de una ciudad determinada", "parameters": { "type": "object", "properties": { "city": { "type": "string", "description": "El nombre de la ciudad, por ejemplo Atenas" }, "unidad": { "type": "string", "enum": ["celsius", "fahrenheit"], "description": "La unidad de temperatura a usar" } }, "required": ["ciudad"] } } } ]
Observe cómo la herramienta real que se utilizará (la API meteorológica) no se menciona en ninguna parte hasta este punto. En cambio, el modelo decide a qué herramienta llamar basándose en tres cosas: la descripción de la función (“Obtener el clima actual para una ciudad determinada”), las descripciones de los parámetros (“El nombre de la ciudad, por ejemplo, Atenas”) y el esquema aplicado. Es únicamente a partir de esta información que el modelo determina si esta es la herramienta adecuada para solicitar un mensaje de usuario determinado y con qué argumentos. Por lo tanto, escribir descripciones claras y precisas al definir nuestras herramientas es de importancia clave para que el modelo identifique y llame con éxito a la herramienta adecuada en función de la entrada del usuario.
Entonces, después de haber definido la variable de herramientas, podemos realizar una solicitud al modelo de IA:
# Paso 2: enviar el mensaje de usuario junto con los mensajes de definición de la herramienta = [ {"role": "user", "content": "¿Cómo está el clima en Atenas en este momento?"} ] respuesta = client.chat.completions.create( model="gpt-4o-mini", herramientas=herramientas, mensajes=mensajes ) print(response.choices[0].mensaje)
Esto es lo que sucede cuando hacemos esta solicitud. El modelo lee el mensaje del usuario, "¿Cómo está el tiempo en Atenas en este momento?", y comprende que la herramienta disponible get_current_weather puede ayudar a responder esta consulta con datos reales y en vivo. Entonces, en lugar de generar una respuesta de texto directamente, decide llamar primero a la herramienta. Más específicamente, la respuesta del modelo en este punto se ve así:
ChatCompletionMessage( contenido=Ninguno, rol='asistente', tool_calls=[ ChatCompletionMessageToolCall( id='call_abc123', tipo='función', función=Función( nombre='get_current_weather', argumentos='{"ciudad": "Atenas", "unidad": "celsius"}' ) ) ] )
Observe que el contenido es Ninguno, porque el modelo no devuelve una respuesta de texto, sino una llamada a una herramienta. Ahora es nuestro trabajo ejecutar la herramienta, el modelo seleccionado y devolverle el resultado. En nuestro caso, esto será realizar la solicitud API a la API meteorológica, utilizando los argumentos (es decir, la ciudad y la unidad de medida) proporcionados en la respuesta del modelo de IA:
# Paso 3: ejecutar la herramienta usando las solicitudes de importación de la API de Open-Meteo def get_current_weather(city: str, unit: str = "celsius"): # geocodificar el nombre de la ciudad en las coordenadas geo = request.get( "https://geocoding-api.open-meteo.com/v1/search", params={"name": city, "count": 1} ).json() lat = geo["results"][0]["latitud"] lon = geo["resultados"][0]["longitud"] # buscar el clima actual clima = request.get( "https://api.open-meteo.com/v1/forecast", params={ "latitud": lat, "longitude": lon, "current": "temperature_2m,weather_code", "temperature_unit": unidad } ).json() temp = clima["current"]["temperature_2m"] return {"ciudad": ciudad, "temperature": temp, "unit": unit} # extrae la llamada a la herramienta de la respuesta tool_call = respuesta.choices[0].message.tool_calls[0]argumentos = json.loads(tool_call.function.arguments) # llamar a la función real weather_result = get_current_weather(**argumentos)
Luego podemos agregar el resultado de la herramienta al historial de mensajes y luego enviar todo nuevamente al modelo:
# Paso 4: agregue la llamada a la herramienta del asistente Y el resultado de la herramienta al historial de mensajes message.append(response.choices[0].message) # importante: agregue primero la llamada a la herramienta message.append({ "role": "tool", "tool_call_id": tool_call.id, # vincula el resultado a la llamada a la herramienta específica "content": json.dumps(weather_result) }) # Paso 5: envíe todo de regreso al modelo para una respuesta final final_response = client.chat.completions.create( model="gpt-4o-mini", herramientas=herramientas, mensajes=mensajes ) print(respuesta_final.opciones[0].mensaje.contenido)
Y ahora, finalmente recibimos una respuesta de texto adecuada:
Actualmente hace 29°C en Atenas. ¡Parece un gran día para estar al aire libre!
🍨 DataCream es un boletín que ofrece historias y tutoriales sobre inteligencia artificial, datos y tecnología. Si estás interesado en estos temas, ¡suscríbete aquí!
2. Dejar que el modelo elija entre múltiples herramientas
Ahora echemos un vistazo a un ejemplo más realista. En una aplicación agente del mundo real, el modelo normalmente tiene acceso no a una, sino a varias herramientas y, como resultado, necesita determinar cuál (o cuáles) debe usarse en función de lo que pregunta el usuario.
Ampliemos nuestro ejemplo inicial de API meteorológica agregando una herramienta adicional para monedas. Para esto, usaremos Frankfurter, una API de moneda que proporciona tasas diarias del Banco Central Europeo, nuevamente sin requisito de clave API. Entonces, actualicemos nuestra variable de herramientas agregando una segunda herramienta para convertir monedas:
tools = [ { "type": "function", "function": { "name": "get_current_weather", "description": "Obtener el clima actual para una ciudad determinada", "parameters": { "type": "object", "properties": { "city": {"type": "string", "description": "El nombre de la ciudad"}, "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]} }, "required": ["ciudad"] } } }, { "type": "function", "function": { "name": "convert_currency", "description": "Convertir una cantidad de una moneda a otra", "parameters": { "type": "object", "properties": { "amount": {"type": "number", "description": "La cantidad a convertir"}, "from_currency": {"type": "string", "description": "El código de moneda de origen, por ejemplo, USD"}, "to_currency": {"type": "string", "description": "El código de moneda de destino, por ejemplo, EUR"} }, "required": ["cantidad", "from_currency", "to_currency"] } } } ]
Y también configure la función convert_currency real usando la API de Frankfurter:
def convert_currency(monto: float, from_currency: str, to_currency: str): respuesta = request.get( f"https://api.frankfurter.dev/v2/rate/{from_currency}/{to_currency}" ).json() tasa = respuesta["rate"] convertido = round(monto * tasa, 2) return { "monto": cantidad, "from_currency": from_currency, "to_currency": to_currency, "monto_convertido": convertido, "tasa": tasa }
De esta manera, el modelo puede manejar una gama mucho más amplia de solicitudes de usuarios; ahora también puede responder sobre monedas, además del clima 😋. Ahora, si el usuario pregunta "¿Cuál es el tiempo en Atenas?", el modelo debería llamar a get_current_weather. Si preguntan "¿Cuánto son 100 USD en EUR?", debería llamar a convert_currency. Y si preguntamos algo irrelevante tanto para el clima como para las monedas y ninguna de las herramientas disponibles puede ayudar, el modelo simplemente responderá en texto sin llamar a ninguna herramienta.
Pero veamos esto en acción:
mensajes = [ {"role": "usuario", "contenido": "¿Cuánto son 200 USD en EUR?"} ] respuesta = client.chat.completions.create( model="gpt-4o-mini", herramientas=herramientas, mensajes=mensajes ) herramienta_llamada = respuesta.opciones[0].message.tool_calls[0]
Echemos un vistazo a la respuesta:
imprimir(llamada_herramienta.función.nombre)
de donde obtenemos convert_currency. Entonces, el modelo entendió que la pregunta “¿Cuánto son 200 USD en EUR?” es relevante para la herramienta convert_currency. Veamos también los argumentos:
imprimir (llamada_herramienta.función.argumentos)
de donde obtenemos
'{"cantidad": 200, "from_currency": "USD", "to_currency": "EUR"}'
Por lo tanto, el modelo identifica correctamente convert_currency como la herramienta adecuada y completa los argumentos apropiados, sin que nosotros hagamos nada más que proporcionar descripciones de herramientas apropiadas y que el usuario proporcione un mensaje apropiado. Este mecanismo exacto de toma de decisiones es lo que hace que las llamadas a herramientas sean la base de los sistemas agentes.
3. Llamar a varias herramientas a la vez
Otro escenario interesante de llamada de herramientas es que muchos modelos, como gpt-4o, pueden llamar a múltiples herramientas en una sola respuesta cuando la solicitud del usuario lo requiere. Esto se conoce como llamada de herramientas paralela.
Por ejemplo, imaginemos un escenario en el que el usuario solicita en una sola solicitud algo que requiere el uso de las herramientas get_current_weather y convert_currency para obtener la información requerida:
mensajes = [ {"role": "usuario", "content": "¿Cuál es el clima en Atenas y cuánto son 100 USD en EUR?"} ] respuesta = client.chat.completions.create( model="gpt-4o-mini", herramientas=herramientas, mensajes=messages ) para tool_call en respuesta.choices[0].message.tool_calls: print(tool_call.function.name) print(tool_call.function.argumentos)
En este caso la respuesta que obtenemos es la siguiente:
get_current_weather {"ciudad": "Atenas"} convert_currency {"cantidad": 100, "from_currency": "USD", "to_currency": "EUR"}
Observe cómo se llaman ambas herramientas en una única respuesta de modelo. Luego podemos ejecutar las herramientas respectivas con los argumentos proporcionados y devolver los resultados de la herramienta al modelo juntos. Esto es mucho más eficiente que las llamadas secuenciales y es la forma en que los agentes más avanzados manejan solicitudes de varias partes.
En mi mente: Entonces, ¿qué hace que esto sea agente?
Una cosa que siempre me ha puesto de los nervios es que el término "agentic" se aplica a todo. Agentes, flujos de trabajo de agentes, cualquier cosa que tenga su origen en la palabra agente es muy sexy hoy en día, pero como ya habrás descubierto, no todo lo que se vende como agente realmente lo es.
Entonces, demos un paso atrás y pensemos, en primer lugar, en qué es realmente un agente. En esencia, un agente es algo que percibe su entorno, procesa esa información de alguna manera, tiene un objetivo y luego decide qué acción tomar para lograrlo. Piense en lo que está haciendo nuestro mecanismo de llamada de herramientas: percibe las herramientas disponibles, decide cuál es apropiada para atender la solicitud del usuario (si corresponde) y pasa esa decisión al resto del código para su ejecución. Eso, en su forma más simple, es agencia.
En las aplicaciones agentes del mundo real, el bucle de llamada a la herramienta se ejecuta no una sino varias veces, y el modelo utiliza los resultados de una llamada a la herramienta para decidir si llamar a continuación y cuál. Esto a veces se denomina bucle ReAct (Razón + Actuación) y es lo que permite a los agentes manejar tareas complejas de varios pasos que no se pueden resolver en una sola llamada.
En última instancia, lo que encuentro más fascinante acerca de las llamadas a herramientas es cómo cambia la naturaleza de lo que es un LLM. Hasta este punto, un modelo de lenguaje era esencialmente una función de entrada y salida muy sofisticada, que toma texto como entrada y genera texto como salida. Pero con la llamada a la herramienta, obtenemos acceso a una colección infinita de funcionalidades adicionales, que podemos combinar con el poder de razonamiento del LLM para crear sistemas que son mucho más capaces que cualquiera de los dos por separado.
✨ ¡Gracias por leer! ✨
Si llegó hasta aquí, es posible que le resulten útiles los pialgoritmos , una plataforma que hemos estado creando y que ayuda a los equipos a gestionar de forma segura el conocimiento organizacional en un solo lugar.
¿Te encantó esta publicación? Únase a mí en 💌Substack y 💼LinkedIn
Todas las imágenes del autor, salvo que se indique lo contrario.