
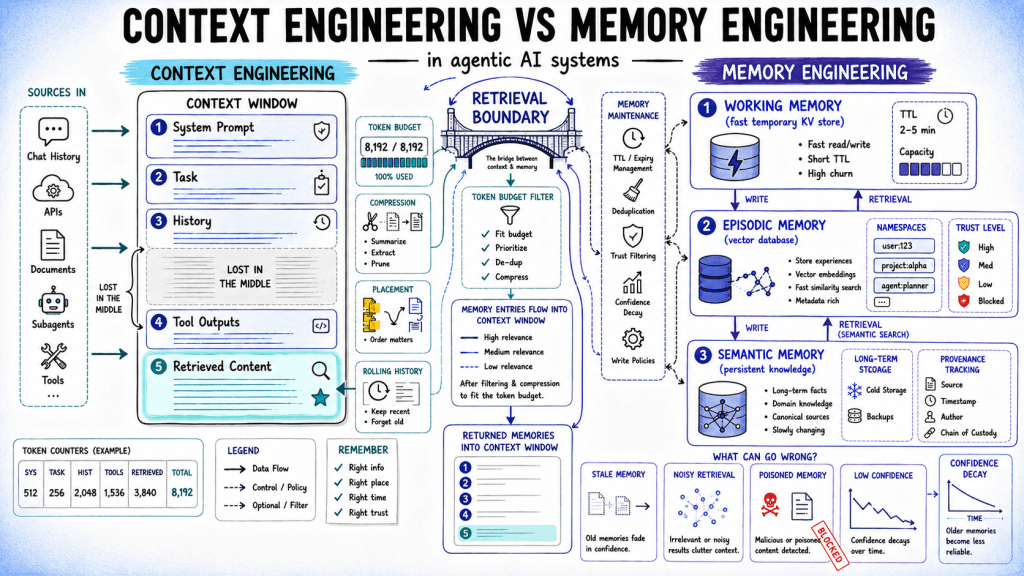
En este artículo, aprenderá cómo la ingeniería de contexto y la ingeniería de memoria resuelven diferentes problemas en sistemas de IA agentes y cómo las dos disciplinas se encuentran en el punto donde la memoria recuperada ingresa a la ventana de contexto.
Los temas que cubriremos incluyen:
Qué implica la ingeniería de contexto, incluida la inclusión selectiva, la ubicación estructural y la compresión, y por qué es importante para la calidad del razonamiento dentro de una única llamada de inferencia. Qué implica la ingeniería de memoria, incluido el diseño de políticas de escritura, la selección de la capa de almacenamiento, la estrategia de recuperación y el mantenimiento, y cómo estos dan forma a la confiabilidad a largo plazo. Cómo se encuentran la memoria y la ingeniería contextual en el límite de recuperación y los dos modos de falla más comunes que ocurren cuando este límite no se gestiona bien.
Con ese marco establecido, así es como funciona cada disciplina.
Introducción
A medida que los agentes de IA avanzan hacia flujos de trabajo más largos y casos de uso de múltiples sesiones, surge un patrón familiar. Las restricciones se eliminan a mitad de la tarea, la información recuperada resurge cuando no debería y el contexto de un paso anterior se fusiona con el actual. Las fallas son difíciles de identificar porque obviamente ningún componente tiene la culpa.
La mayoría de las veces, el problema radica en dos áreas que se construyen juntas, se combinan o se omiten: la ingeniería de contexto y la ingeniería de memoria. Están relacionados pero son distintos, fallan de diferentes maneras y requieren sistemas diferentes para funcionar correctamente.
Este artículo cubre las decisiones centrales detrás de cada disciplina y dónde interactúan:
Qué implica la ingeniería de contexto y las decisiones específicas que determinan si un agente razona bien en una sola llamada Qué implica la ingeniería de memoria y cómo la política de escritura, el almacenamiento, la recuperación y el mantenimiento afectan la confiabilidad a largo plazo Cómo las dos disciplinas comparten un límite en el momento de la recuperación y qué se necesita para gestionar bien ese límite
Comprender ambos, por separado y en conjunto, es lo que determina si un agente resiste cargas de trabajo reales.
Una descripción general de la ingeniería del contexto y la memoria
La ingeniería de contexto cubre el diseño de una única llamada de inferencia: qué incluir, qué comprimir, dónde colocar las cosas y qué descartar. Todo lo que está dentro del alcance es efímero; cuando finaliza la llamada, la ventana se borra.
La ingeniería de la memoria se centra en lo que sobrevive más allá de una única interacción con un modelo. Abarca los sistemas y políticas responsables de escribir, almacenar, recuperar, actualizar y gobernar la información para que futuras interacciones puedan hacer uso de ella. Cuando un agente recuerda información de una sesión anterior, se coordina con otro agente o aplica una preferencia de usuario aprendida días o semanas antes, se basa en la ingeniería de la memoria en lugar de la ingeniería del contexto.
Mientras que la ingeniería de contexto determina qué información está disponible para el modelo durante una solicitud específica, la ingeniería de memoria determina qué información persiste en las solicitudes y cómo se mantiene, recupera y confía en esa información a lo largo del tiempo. Aquí hay una descripción general:
Aspecto Ingeniería de contexto Ingeniería de memoria Alcance Una llamada de inferencia A través de llamadas, sesiones, agentes Dónde residen los datos Dentro de la ventana activa del modelo Almacenes externos: base de datos vectorial, K/V, relacional Problema principal Qué incluir y cómo organizarlo Qué persistir, recuperar y confiar Falla cuando La ventana se llena, la ubicación es incorrecta, el ruido abruma la señal Errores de recuperación, obsolescencia, envenenamiento, no hay política de escritura Superficie de ingeniería Estructura de aviso, compresión, presupuesto de tokens Esquema de almacenamiento, estrategia de recuperación, escritura y actualización políticas Vida útil de los datos Duración de una llamada LLM Depende del tipo de memoria
Ingeniería de contexto: ensamblaje de la ventana de contexto óptima
Para un agente que ejecuta un flujo de trabajo de varios pasos, cada llamada de inferencia reúne una ventana contextual de múltiples fuentes: aviso del sistema, descripción de la tarea, historial de conversaciones, resultados de herramientas, documentos recuperados, resúmenes de subagente. La ingeniería de contexto es el conjunto de decisiones que determinan qué aporta cada componente, de qué forma y en qué posición.
Inclusión selectiva
No todo lo disponible debe entrar en contexto. Una consulta de base de datos que devuelve cientos de filas, una búsqueda web que devuelve cinco artículos completos, un ejecutor de código que registra una salida detallada: todo esto infla la ventana y reduce la calidad del razonamiento antes de que se alcance el límite de token. La decisión sobre qué se incluye palabra por palabra, qué se comprime en hechos clave y qué se elimina es una elección de diseño, no una opción predeterminada.
Colocación estructural
El lugar donde se ubica la información en la ventana afecta la confiabilidad con la que la usa el modelo. Los modelos prestan más atención al contenido al principio y al final de contextos largos, y el material en el medio recibe significativamente menos peso. Esto se conoce como el efecto “perdido en el medio”.
Las restricciones estrictas y las instrucciones de tareas críticas se encuentran en la parte superior de la ventana. La información recuperada que sea más relevante para la tarea actual debe colocarse cerca del final de la ventana contextual.
La consulta o tarea del usuario actual normalmente debe seguir la información recuperada, posicionando tanto el contexto relevante como el objetivo inmediato lo más cerca posible del punto de generación. Esta disposición aumenta la probabilidad de que el modelo utilice eficazmente la información recuperada al producir su respuesta.

Descripción general de la ingeniería de contexto
Compresión a la llegada
Las salidas de la herramienta deben comprimirse después de que se devuelva una llamada, no después de que se llene la ventana. Una respuesta API sin procesar que contiene 3000 tokens, de los cuales el agente solo necesita 150, debe resumirse antes de entrar en contexto para el siguiente paso. Esperar hasta que la ventana esté llena y luego luchar para truncar es una gestión reactiva de un problema que evita la compresión en el origen.
Gestión del historial de conversaciones
El historial de conversaciones crece más rápido que cualquier otro componente del contexto. Para los agentes con una larga trayectoria, incluir el historial completo en cada llamada hace que cada inferencia posterior sea más costosa y menos confiable. Se debe aplicar una estrategia de compresión (ventana móvil, resumen jerárquico o extracción de estado estructurado) a intervalos definidos, no cuando la ventana se desborda.
Ingeniería de memoria: diseño de sistemas de memoria de IA persistentes
Una vez que se completa una llamada de inferencia, la ingeniería de la memoria determina qué merece persistir y bajo qué condiciones se vuelve a utilizar. Esto cubre cuatro preocupaciones distintas: qué escribir, dónde almacenarlo, cómo recuperarlo y cómo mantenerlo preciso a lo largo del tiempo.
Escribir diseño de políticas
El diseño de políticas de escritura es uno de los aspectos más pasados por alto de la ingeniería de memoria, pero tiene un impacto desproporcionado en la calidad de la memoria a lo largo del tiempo. Si bien los sistemas de recuperación suelen recibir la mayor atención, la calidad de la recuperación está, en última instancia, limitada por lo que ingresa al almacén de memoria en primer lugar.
Una política de escritura bien definida especifica:
Qué eventos desencadenan una escritura en la memoria Qué información es elegible para almacenamiento El formato en el que se almacena la información, como texto sin formato, registros estructurados, hechos extraídos o resúmenes Los requisitos de confianza o validación para aceptar nuevas entradas Qué agentes, herramientas o componentes del sistema pueden escribir en espacios de nombres de memoria específicos Cómo se manejan las actualizaciones, correcciones e información conflictiva Reglas de retención, políticas de vencimiento y requisitos de tiempo de vida (TTL) para diferentes tipos de memoria
Sin políticas de escritura explícitas, los sistemas a menudo almacenan demasiada información, asignan la misma confianza a todas las entradas y retienen los datos indefinidamente. Con el tiempo, se acumulan recuerdos obsoletos y de bajo valor, la relación señal-ruido disminuye y la calidad de recuperación se degrada. El resultado es un sistema de memoria que crece continuamente y al mismo tiempo se vuelve cada vez menos útil.
Selección de capa de almacenamiento
Los diferentes tipos de memoria sirven para diferentes propósitos y requieren diferentes backends de almacenamiento. La elección del backend también limita qué estrategias de recuperación están disponibles.
Tipo de memoria Qué almacena Almacenamiento Método de recuperación de backend Funcionamiento Estado de tarea activa, resultados intermedios K/V en memoria o de corta duración (Redis) Búsqueda directa de claves Episódicas Interacciones pasadas, ejecuciones de tareas, decisiones Almacén de vectores (Pinecone, Weaviate, Chroma) Búsqueda de similitud semántica Semántica Hechos persistentes, preferencias de usuario, conocimiento del dominio Almacén de vectores + K/V híbrido Búsqueda semántica o clave exacta Procesal Flujos de trabajo aprendidos, patrones de acción exitosos Almacenamiento estructurado o inyección rápida Patrón coincidencia, recuperación directa
El libro de recetas de personalización de contexto de OpenAI hace una distinción útil entre la memoria basada en recuperación y la memoria basada en estado para casos de uso que requieren continuidad. La memoria basada en la recuperación trata las interacciones pasadas como documentos vagamente relacionados y es frágil ante variaciones de fraseo y actualizaciones conflictivas. La extracción de estado estructurado (escribir hechos validados y escritos en lugar de incrustar fragmentos de conversación sin procesar) produce resultados más consistentes para los hechos que deben aplicarse de manera confiable en todas las sesiones.
Descripción general de la ingeniería de memoria
Estrategia de recuperación
Leer de memoria no es una sola operación. Una capa de recuperación bien diseñada verifica primero la memoria de trabajo (búsqueda de claves rápida, barata y exacta), recurre a la búsqueda semántica en la memoria episódica o semántica cuando no aparece nada relevante, aplica filtros de metadatos para determinar la actualidad y el nivel de confianza antes de devolver resultados, e inyecta solo lo que necesita el paso actual.
Mantenimiento de la memoria
Una tienda sin política de mantenimiento se degrada con el tiempo. Las entradas se acumulan, los hechos obsoletos compiten con los actuales y la calidad de recuperación disminuye a medida que disminuye la relación señal-ruido. Las siguientes rutinas de mantenimiento son importantes en la práctica: disminución de la confianza en hechos volátiles, deduplicación de entradas semánticamente similares, caducidad basada en TTL de la memoria de trabajo y datos urgentes, y compresión periódica de registros episódicos antiguos en resúmenes a nivel de sesión.
Un esquema MemoryEntry que codifica estas preocupaciones directamente hace que la lógica de escritura y mantenimiento sea más fácil de razonar sobre:
class MemoryEntry(BaseModel):
content: str
memory_type: str # working | episodic | semantic | procedural
importance: float # 0.0–1.0, gates long-term storage
confidence: float # decays over time for volatile facts
trust_level: float # 1.0 internal system, 0.5 user input, 0.0 external
created_at: datetime
expires_at: datetime | None
provenance: dict # agent_id, tool_name, session_id, input_hash
def should_write_to_long_term(entry: MemoryEntry) -> bool:
return (
entry.importance >= 0.6
and entry.confidence >= 0.7
and entry.trust_level >= 0.5
)
class MemoryEntry ( BaseModel ) :
content : str
memory_type : str # working | episodic | semantic | procedural
importance : float # 0.0–1.0, gates long-term storage
confidence : float # decays over time for volatile facts
trust_level : float # 1.0 internal system, 0.5 user input, 0.0 external
created_at : datetime
expires_at : datetime | None
provenance : dict # agent_id, tool_name, session_id, input_hash
def should_write_to_long_term ( entry : MemoryEntry ) -> bool :
return (
entry . importance >= 0.6
and entry . confidence >= 0.7
and entry . trust_level >= 0.5
)
Guía de diseño de memoria de agentes de IA: memoria de trabajo, a largo plazo y de procedimiento con gestión de olvido y estancamiento y 7 pasos para dominar la memoria en sistemas de IA agentes son descripciones útiles del diseño de la memoria de agentes.
El límite de la recuperación: conectando la memoria y la ingeniería contextual
La ingeniería de la memoria y la ingeniería del contexto a menudo se analizan como disciplinas separadas, pero en la práctica están profundamente interconectadas. Ambos existen para resolver el mismo problema fundamental: garantizar que un modelo tenga acceso a la información correcta en el momento adecuado.
A alto nivel:
La ingeniería de la memoria se centra en la persistencia: qué información debe almacenarse, actualizarse, retenerse u olvidarse con el tiempo. La ingeniería de contexto se centra en la utilización: qué información debe ingresar a la ventana de contexto activa para una tarea específica y cómo debe organizarse. La recuperación es el límite donde se encuentran estas dos disciplinas.
Los sistemas de memoria producen información candidata. La asamblea de contexto decide entonces:
Si esa información debe ingresar al mensaje Cuánto debe incluirse Dónde debe colocarse dentro de la ventana contextual
Gestionar bien este límite es lo que transforma una colección de componentes de memoria en un sistema de agentes coherente.
Modo de falla n.° 1: recuperación sin un presupuesto contextual
Uno de los fallos más comunes se produce cuando la recuperación se trata independientemente del ensamblaje del contexto.
Una búsqueda de memoria devuelve un conjunto de entradas relevantes y el ensamblador de contexto las inyecta todas en el mensaje. A medida que se agregan más recuerdos, la ventana contextual se llena gradualmente con contenido recuperado, dejando menos espacio para instrucciones, resultados de herramientas, rastreos de razonamiento e información específica de la tarea.
Los síntomas resultantes suelen ser engañosos:
La calidad de recuperación parece alta. Los recuerdos relevantes se encuentran exitosamente. El rendimiento del sistema aún se degrada.
En muchos casos, el sistema de memoria ha hecho su trabajo correctamente. El fallo se produce porque el conjunto de contexto carece de un mecanismo de presupuestación.
Un mejor enfoque es el ensamblaje de contexto con reconocimiento de recuperación. En lugar de recuperar primero y presupuestar después, la capa de contexto asigna un presupuesto simbólico antes de que comience la recuperación. Luego, la capa de recuperación devuelve solo los recuerdos de mayor valor que se ajustan a ese presupuesto.
async def retrieve_for_step(
self,
step: AgentStep,
max_tokens: int
) -> str:
candidates = await self.memory.search(
query=step.retrieval_query,
max_results=10,
filters={
“trust_level”: {“gte”: 0.5},
“expires_at”: {“gt”: datetime.now()}
}
)
selected =[]usado = 0 para la entrada en ordenado (candidatos, clave = lambda e: e.relevance_score, reverso = Verdadero): costo = self.token_count (entrada. contenido) si se usa + costo > max_tokens: romper seleccionado.append (entrada. contenido) usado + = costo de retorno "nn". unirse (seleccionado)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
asíncrono def recuperar_para_paso (
ser ,
paso : AgentePaso ,
tokens_max : entero
) -> cadena :
candidatos = esperar a uno mismo . memoria . buscar (
consulta = paso . consulta_recuperación ,
resultados_max = 10 ,
filtros = {
"nivel_confianza" : { "gte" : 0,5 } ,
"expire_at" : { "gt" : fecha y hora . ahora ( ) }
}
)
seleccionado = [ ]
usado = 0
para entrada en ordenado (
candidatos ,
clave = lambda mi : mi . puntuación_relevancia ,
reverso = Verdadero
) :
costo = ser . token_count ( entrada . contenido )
si usado + costo > tokens_max :
romper
seleccionado . agregar ( entrada . contenido )
usado += costo
devolver "nn" . unirse ( seleccionado )
La idea clave es simple: la recuperación debe operar dentro de las limitaciones del contexto, no asumir un espacio ilimitado en el futuro.
Modo de falla n.° 2: mala ubicación de la información recuperada
La calidad de la recuperación por sí sola no es suficiente. Incluso los recuerdos muy relevantes pueden fallar si se colocan incorrectamente dentro de la ventana contextual.
Un problema común es tratar la recuperación simplemente como un problema de búsqueda e ignorar la ubicación. Los recuerdos recuperados se adjuntan dondequiera que lleguen, sin considerar su papel en el paso de razonamiento actual.
Esto se vuelve más impactante en contextos largos. La atención no se distribuye uniformemente a lo largo del mensaje. La información ubicada en lo más profundo de un contexto largo puede recibir una influencia significativamente menor que la información ubicada cerca del principio o el final. Esto conduce a un modo de falla sutil:
Se recupera la información correcta. La información se inserta en contexto. El modelo se comporta como si faltara.
La recuperación tuvo éxito pero la colocación fracasó. Por lo tanto, el ensamblaje de contexto debería optimizar ambos:
Selección: qué ingresa a la ventana contextual Ubicación: dónde aparece dentro de la ventana contextual
La información recuperada que debe influir en el paso actual debe ubicarse cerca de la región de razonamiento activo en lugar de agregarse arbitrariamente.
La recuperación como paso en la construcción del contexto
La recuperación es el primer paso para convertir la memoria almacenada en un contexto utilizable. El objetivo no es solo recuperar información relevante, sino también garantizar que sea la información correcta para el paso actual, en la cantidad adecuada para ajustarse al presupuesto del contexto y colocada en el lugar correcto donde el modelo pueda usarla de manera efectiva.
Cuando la ingeniería de memoria y la ingeniería de contexto se tratan como un único canal de recuperación al contexto, en lugar de componentes aislados, los sistemas de agentes se vuelven más confiables, eficientes y escalables.
Ingeniería de contexto: LLM Memoria y recuperación para agentes de IA de Weaviate es una gran referencia.
Resumen
La ingeniería de contexto y de memoria son dos capas de un único sistema que controla lo que sabe el modelo, cuándo lo sabe y cómo se utiliza ese conocimiento.
La ingeniería de contexto opera en el momento de la inferencia, dando forma a la ventana de información activa. La ingeniería de la memoria opera a lo largo del tiempo, dando forma a qué información persiste y cómo se puede recuperar más adelante.
Dimensión Contexto Ingeniería Ingeniería de memoria Pregunta central ¿Qué debería ver el modelo en este momento y cómo? ¿Qué debería retener el sistema y durante cuánto tiempo? Artefacto primario Ventana de contexto ensamblada por llamada de inferencia Entradas de memoria persistentes entre llamadas y sesiones Gestión de tokens Asignación de presupuesto por componente de ventana Costo de almacenamiento por tipo de entrada; costo de recuperación por consulta Resultados de la herramienta de compresión resumidos antes de la inyección; historia enrollada o extraída Registros episódicos antiguos comprimidos; hechos obsoletos deteriorados o podados Frescura Ventana de historia móvil; los giros obsoletos arrojaron TTL por hechos volátiles; la confianza decae con el tiempo La jerarquía de la fuente de confianza gobierna el orden de montaje Se rastrea la procedencia por entrada; contenido de baja confianza desinfectado antes de escribir Multi-agente Cada agente ensambla su propia ventana de forma independiente Espacios de nombres con alcance por agente; espacio de nombres compartido para hechos entre agentes Modo de falla Desbordamiento, degradación de la atención, ensamblaje ruidoso Envenenamiento, estancamiento, pérdida de recuperación, crecimiento ilimitado Mantenimiento Compresión proactiva en intervalos definidos Caducidad de TTL, deduplicación, deterioro de la confianza, archivado episódico Donde se encuentran La memoria recuperada ingresa al contexto: el presupuesto y la ubicación gobiernan cómo el ensamblaje del contexto solicita la recuperación dentro de una restricción de presupuesto simbólico
En resumen, un sistema agente sólo funciona cuando ambas capas están alineadas: la memoria determina lo que está disponible y el contexto determina lo que se vuelve procesable.