
viviendo en la Estación Espacial Internacional durante más de un cuarto de siglo. Como le dirá el tomate viejo que está en la parte trasera de su refrigerador, es tiempo de sobra para comenzar a desarrollar moho. ¿Qué microbios son lo suficientemente resistentes para sobrevivir en la Estación Espacial Internacional con radiación estelar y sin gravedad? Podemos encontrar la respuesta usando la metagenómica.
Veamos cómo descubrir qué vive en la Estación Espacial Internacional. Se toma la secuencia de ADN sin etiquetar y se intenta encontrar una secuencia muy similar de una especie conocida, lo cual es muy similar a buscar documentos o páginas web similares. Como tal, los biólogos se han basado en las ideas de hash sensible a la localidad para identificar especies. Aquí revisaré el código, discutiré los resultados (incluido un hallazgo sorprendentemente sabroso) y describiré el algoritmo utilizado para identificar especies. Una vez que comprenda estas técnicas, podrá descubrir qué moho vive en cualquier parte del sistema solar.
En metagenómica, en lugar de estudiar el ADN de un solo organismo, se analiza el ADN de todas las especies diferentes en un solo lugar. Este artículo de Urbaniak et al. utilizó la metagenómica para estudiar todas las bacterias y hongos de 8 lugares diferentes alrededor de la Estación Espacial Internacional. Nos centraremos en sólo una de sus muestras; Tomaron un trozo de tela (tela científica estéril) y lo limpiaron sobre la mesa del comedor, extrajeron todo el ADN de esa tela y lo secuenciaron. Como se trataba de un estudio metagenómico, el método de muestreo captura ADN de cualquier cosa que pueda estar viva sobre la mesa. Fundamentalmente, en metagenómica no es necesario saber qué hay allí antes de poder observar su ADN.
Analizando el ADN
Urbaniak et al. puso a disposición sus datos de secuenciación en Sequence Read Archive bajo una licencia cero creative commons. Descargué la muestra F4_S5_P del Archivo Europeo de Nucleótidos porque es más fácil trabajar con él. Si desea elegir una muestra diferente, puede ver todos los detalles sobre su procedencia en la estación en el sitio web de la NASA.
# Descargue una muestra de mesa de comedor tratada con PMA wget -P data/rawreads -nc ftp://ftp.sra.ebi.ac.uk/vol1/fastq/SRR171/065/SRR17140465/SRR17140465_2.fastq.gz wget -P data/rawreads -nc ftp://ftp.sra.ebi.ac.uk/vol1/fastq/SRR171/065/SRR17140465/SRR17140465_1.fastq.gz
En lecturas sin formato, algunas secuencias pueden estar llenas de errores, tener secuencias adaptadoras o ser demasiado cortas para ser útiles. Entonces, antes de analizarlas, podemos recortar y filtrar las lecturas para eliminar las lecturas o secciones de lecturas de baja calidad. Estoy usando fastp porque es rápido y detecta adaptadores automáticamente.
fastp -i data/rawreads/${accession}_1.fastq.gz -I data/rawreads/${accession}_2.fastq.gz -o data/fastp/${accession}_1.fastq.gz -O data/fastp/${accession}_2.fastq.gz -h data/fastp/${accession}.html -j data/fastp/${accession}.json
Ahora que tenemos secuencias de ADN de alta calidad de una mesa en el espacio, es hora de descubrir qué vivía allí arriba. Kraken2 es una herramienta metagenómica muy rápida y ampliamente utilizada para identificar de qué especie proviene una secuencia de ADN. kraken2 es mucho más rápido que BLAST, otra herramienta de la que quizás hayas oído hablar. BLAST es muy bueno si tienes decenas o incluso cientos de secuencias para identificar, pero solo para nuestra muestra tenemos >75.000 pares de lecturas. Y este es un conjunto de lecturas pequeño; no es raro que las secuenciaciones modernas tengan millones de lecturas. Con todas estas lecturas necesitamos algo muy rápido, como kraken2.
¿Por qué kraken2 es mucho más rápido que BLAST? BLAST está alineando, alineando su secuencia con posibles coincidencias y teniendo en cuenta las diferencias entre ellas. De esa manera, incluso si su secuencia no coincide exactamente con otra secuencia similar, BLAST aún sabe exactamente en qué se parecen y en qué se diferencian. Esta puede ser información muy útil, pero es bastante lenta.
# Alineación BLAST CAAATAATTTGAAA || || ||||||| CACGTATTTTGAAA
En Kraken2 obtenemos un gran aumento de velocidad al buscar solo coincidencias exactas. No intentamos unir toda la secuencia de una vez, sino que la dividimos en partes más cortas de longitud k llamadas kk-mers. Los kk-mers no cuentan como coincidentes a menos que sean exactamente iguales, pero si las secuencias son similares, algunos de los múltiples kk-mers coinciden exactamente y obtenemos un resultado.
# Secuencia de consulta CAAATAATTTGAAA # k-mers CAAATAATT AAATAATTT AATAATTTG ATAATTTGA TAATTTGAA AATTTGAAA # Secuencia similar con 4/6 k-mers idénticos CGAATAATTTGAAA # k-mers CGAATAATT Sin coincidencia exacta GAATAATTT Sin coincidencia exacta AATAATTTG Coincidencia exacta ATAATTTGA Coincidencia exacta TAATTTGAA Coincidencia exacta AATTTGAAA Coincidencia exacta
Un punto importante a tener en cuenta es que kraken2 compara sus secuencias con una base de datos. Esto significa que sólo puedes identificar la especie correcta, si está en tu base de datos. Si la especie de la que proviene su ADN no está en la base de datos, es posible que no obtenga respuesta o que obtenga una coincidencia falsa con otra especie estrechamente relacionada. Ben Langmead, uno de los desarrolladores de kraken2, pone a disposición varias bases de datos en este sitio web. Seleccioné una base de datos con hongos y bacterias, y para acelerar las cosas elegí una con un límite de 8 GB, la base de datos PlusPF-8. Una vez que descargué y extraje la base de datos, ejecuté kraken2 para lecturas emparejadas, con la configuración –memory-mapping para hacerlo más fácil en mi computadora portátil.
w get -P ~/databases https://genome-idx.s3.amazonaws.com/kraken/k2_pluspf_08_GB_20260226.tar.gz tar -xvzf ~/databases/k2_pluspf_08_GB_20260226.tar.gz -C ~/databases kraken2 –db ~/databases/k2_pluspf_08_GB_20260226 –paired data/fastp/${accession}_1.fastq.gz data/fastp/${accession}_2.fastq.gz –threads 12 –memory-mapping –report data/kraken2/${accession}_kraken2_report.txt –output datos/kraken2/${accession}_kraken2_output.txt
¿Qué hay sobre la mesa?
El informe kraken2 le indica cuántas lecturas se asignaron a cada taxón observado; consulte la wiki de kraken2 para obtener detalles completos. El informe le indica la cantidad de lecturas que se corresponden exactamente con este taxón (columna 2) y también la cantidad de lecturas que se corresponden con cualquiera de sus taxones descendientes (columna 3). Por ejemplo, al género Acinetobacter se le asignan 134 lecturas directamente, pero 238 lecturas si se incluyen las lecturas asignadas a las nueve especies de Acinetobacter observadas y dos subgéneros. (Agregué los títulos de las columnas para ayudar).
% descendiente# exacto# rango nombre txid 0.32 238 134 G 469 Acinetobacter 0.10 76 76 S 40214 Acinetobacter johnsonii 0.02 12 0 G1 196816 Acinetobacter no clasificado 0.01 9 9 S 2743575 Acinetobacter sp. NEB 394 0,00 3 3 S 2953738 Acinetobacter sp. Z1 0,01 7 0 G1 909768 Complejo Acinetobacter calcoaceticus/baumannii 0,01 7 7 S 470 Acinetobacter baumannii 0,00 3 3 S 1776742 Acinetobacter vivianii 0,00 3 3 S 40215 Acinetobacter junii 0,00 1 1 S 29430 Acinetobacter haemolyticus 0,00 1 1 S 106649 Acinetobacter guillouiae 0,00 1 1 S 28090 Acinetobacter lwoffii
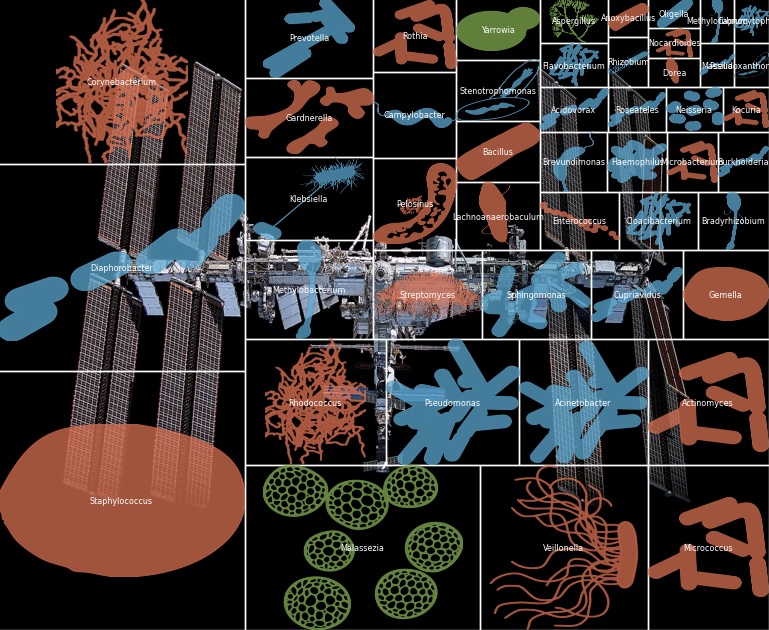
Podemos ordenar la tabla por número de lecturas y filtrar el rango de taxón a S para mostrar las especies más comunes que se encuentran en la mesa del comedor de la Estación Espacial Internacional. También podemos trazar estos datos usando figtreemap; consulte el código fuente para saber exactamente cómo. La información del linaje se agregó usando taxonkit para que sea más fácil colorear la trama.
datos de gato/kraken2/SRR17140465_kraken2_report.txt | taxonkit lineage –data-dir ~/databases/taxdump/ -i 5 > data/kraken2/SRR17140465_kraken2_report_lineage.txt figtreemap.squarify_images.figtreemap( tamaños, imgs, facecolor ="negro", edgecolor ="blanco", etiqueta = [name.replace(" ", "n") si tamaño > .1 else "" para nombre, tamaño en zip(nombres,tamaños)], text_kwargs={ "color":"blanco", "tamaño": "xx-pequeño", } ) plt.show()
La figura de arriba ilustra las especies detectadas y qué tan abundante era su ADN en la muestra. El tamaño de la ilustración de cada especie es proporcional al número de lecturas de esa especie en la muestra. El azul se utiliza para las bacterias y el naranja para los hongos. Las especies más comunes detectadas son Pseudolactococcus raffinolactis (que se encuentra en la leche cruda y se utiliza en la producción de alimentos), Cutibacterium acnes (que se encuentra en la piel humana y está relacionado con el acné), Ralstonia pickettii (que es una bacteria ambiental que ha causado algunos brotes hospitalarios al contaminar equipos médicos) y, lo más interesante, Leuconostoc mesenteroides.
L. mesenteroides se utiliza en la fermentación, así que quería intentar descubrir si habían estado fermentando. Utilicé seqkit para extraer las lecturas identificadas para esta especie y megahit para ensamblarlas. El montaje no fue excelente, pero fue lo suficientemente bueno como para EXPLORAR los contigs y obtener más detalles sobre la cepa de L. mesenteroides.
# Extraer lecturas para Leuconostoc mesenteroides txid 1245 seqkit grep -r -n -p "kraken:taxid|1245" –threads 4 data/kraken2/${accession}_kraken2_classified_1.fastq > data/kraken2/${accession}_1245_1.fastq # Ensamblar lecturas extraídas megahit -1 datos/kraken2/${accession}_1245_1.fastq -2 datos/kraken2/${accession}_1245_2.fastq -o datos/megahit/1245
¡Varios contigs, incluido el más largo, se asignan perfectamente a la cepa MSL129 que fue aislada del kimchi! ¡Y sabemos que se comía kimchi en la ISS porque en 2008 el primer astronauta de Corea fue enviado con kimchi especialmente desarrollado para el espacio por el Instituto de Investigación de Energía Atómica de Corea! Antes de enviar el kimchi al espacio, todas las bacterias eran eliminadas mediante altas dosis de radiación, como se describe en este artículo. Sin embargo, el ADN que hemos detectado aquí proviene de células intactas y presumiblemente viables porque la muestra fue tratada con PMA. Entonces, de alguna manera, esta bacteria kimchi ha llegado al espacio y ahora que está allí, ¡es una de las especies más abundantes en la mesa de la ISS!
Esta es una descripción técnica de cómo kraken2 asigna rápidamente taxonomía a secuencias. Kraken2 toma su secuencia de consulta y la divide en kk-mers, mantiene solo un subconjunto de esos kk-mers, convierte los kk-mers restantes en un número llamado hash y luego busca el hash en una base de datos para ver de qué especie proviene. Se utilizan algunos trucos muy inteligentes para hacer esto muy rápido, tanto en cómo se usan los kk-mers como en cómo se construye la base de datos.
Los kk-mers superpuestos tienen mucha redundancia, los kk-mers adyacentes tienen prácticamente la misma secuencia. Los "minimizadores" son una técnica para evitar tratar con múltiples kk-mers casi idénticos. Al tomar el minimizador de un conjunto de kk-meros similares, puede obtener una única subsecuencia para representar varios kk-meros. Para obtener el minimizador, cada kk-mero se divide en kk-meros más pequeños (usamos ll para esta longitud más pequeña y los llamamos ll-meros para evitar confusiones). Solo se conserva el ll-mer que está primero alfabéticamente, que es el minimizador del kk-mer. Kk-mer similares le darán el mismo minimizador para que no tenga que guardar cada kk-mer.
Ilustremos esto con un ejemplo usando k=16k=16 y l=10l=10. Nuestra secuencia tiene 25 bases de largo y produce 10 kk-meros diferentes. Pero esos kk-mers colapsan en solo 3 minimizadores diferentes.
# Secuencia CCTGAGTGTGGAGACCCAAGTGAGA # kmers, k = 16 CCTGAGTGTGGAGACC CTGAGTGTGGAGACCC TGAGTGTGGAGACCCA GAGTGTGGAGACCCAA AGTGTGGAGACCCAAG GTGTGGAGACCCAAGT TGTGGAGACCCAAGTG GTGGAGACCCAAGTGA TGGAGACCCAAGTGAG GGAGACCCAAGTGAGA Minimizador k-mer CCTGAGTGTGGAGACC AGTGTGGAGA 1 CTGAGTGTGGAGACCC AGTGTGGAGA TGAGTGTGGAGACCCA AGTGTGGAGA GAGTGTGGAGACCCAA AGTGTGGAGA AGTGTGGAGACCCAAG AGTGTGGAGA GTGTGGAGACCCAAGT AGACCCAAGT 2 TGTGGAGACCCAAGTG AGACCCAAGT GTGGAGACCCAAGTGA ACCCAAGTGA 3 TGGAGACCCAAGTGAG ACCCAAGTGA GGAGACCCAAGTGAGA ACCCAAGTGA
kraken2 en realidad ignora algunas posiciones en la secuencia minimizadora; Contrariamente a la intuición, esto mejora la asignación de lectura. Se ignoran las posiciones alternas de s al final del minimizador, por lo que si s = 3 AGTGTGGAGA es efectivamente AGTG-GAA. Ignorar estas bases significa que las diferencias en esas 3 posiciones no rompen el partido. Por lo tanto, kraken2 aún puede identificar especies a pesar de mutaciones y errores de secuenciación.
El siguiente paso es "hash" estos minimizadores. Un hash es efectivamente un número aleatorio, pero la misma secuencia siempre dará el mismo número. Al crear la base de datos, este hash se almacena en una fila con la especie de la que proviene. Kraken2 utiliza un enfoque inteligente llamado código hash compacto para hacer que la base de datos sea más pequeña y más rápida de buscar. Kraken2 divide el hash en dos partes (por ejemplo, 123456 se convierte en 123 y 456) y solo guarda la primera parte en la base de datos. Lo que suena a locura, pero la segunda parte está codificada como la posición en la base de datos. Entonces, en este ejemplo, 123 se guardaría en la fila 456 de la base de datos. Sin embargo, no es exactamente 456, busca una fila vacía para colocar el registro comenzando en 456, por lo que estrictamente 123 se guardaría en la fila 456 o más. Este código hash compacto hace que la base de datos sea más pequeña porque no guardamos todo el hash y hace que la búsqueda sea más rápida porque sabemos dónde empezar a buscar.
Una vez que tenga las asignaciones taxonómicas para cada k-mer en su lectura, ¿cómo las combina para asignar un taxón a toda la lectura? Después de todo, cada lectura tiene múltiples k-mers que pueden no estar de acuerdo entre sí. La lectura se asigna a cualquier taxón que tenga más coincidencias de k-mer para sí mismo o para sus ancestros. Y así es como kraken2 puede asignar taxonomía a una secuencia con velocidad interestelar 🚀.
El problema central que hemos resuelto aquí es tomar una secuencia de ADN de origen desconocido y compararla rápidamente con una gran cantidad de otras secuencias marcadas que son coincidencias imperfectas. Este es casi exactamente el mismo problema que buscar páginas web casi idénticas o detectar plagio. Por lo tanto, no sorprende ver técnicas como minhashing y hash sensible a la localidad apareciendo en estas herramientas bioinformáticas como kraken2 y sourmash.
Las herramientas tradicionales para la comparación de secuencias biológicas como BLAST estaban más arraigadas en la teoría de la evolución, pero a medida que la cantidad de datos de secuencias disponibles sigue aumentando, los bioinformáticos han tenido que recurrir a métodos más rápidos que ponen menos énfasis en los orígenes biológicos de la secuencia.
Al reducir su problema a su pregunta central, puede ver dónde se superpone con problemas en diferentes campos y explorar sus soluciones.