
TL;DR: reproduje 27 tareas reales de mi propio agente de IA contra dos modelos locales, con una actualización de hardware aparte, puntuando ambas contra la misma línea de base congelada de Claude. En un solo RTX 3090 limitado a un contexto de 16K, un modelo 30B obtuvo una puntuación de 22,8/100 frente a 89,4 de Claude, y filtró una sintaxis de llamadas de herramientas mal formada en una cuarta parte de sus respuestas: rota, no simplemente peor. En tres 3090 con un contexto de 256K, un modelo 122B obtuvo una puntuación de 80,0, eliminó por completo las llamadas con formato incorrecto (0 de 27) y costó 0,000969 dólares por tarea frente a los 0,763 dólares de Claude, aproximadamente 787 veces más barato. Mi agente ahora utiliza el modelo local; Cancelé Claude Max y me quedé con Pro. La advertencia honesta: el tamaño del modelo y el presupuesto de contexto cambiaron juntos y no ejecuté ningún control, por lo que esto mide una actualización del sistema, no un efecto aislado del modelo.
agente: un agente de reacción de LangGraph conectado a aproximadamente 90 herramientas: correo electrónico, calendario, notas, archivos, Office, WhatsApp, Discord, generación de imágenes e incluso generando subagentes para trabajos más largos. Funcionó con Claude desde el día que lo construí, porque Claude era el modelo en el que confiaba.
Hace un mes intenté reemplazar ese cerebro con un modelo que se ejecuta en mi propio hardware. Todo salió mal y escribí exactamente qué tan mal.
Luego cambié el hardware, intenté nuevamente y obtuve una respuesta diferente. Ambos intentos están a continuación, medidos de la misma manera, porque la distancia entre ellos es el hallazgo real.
La última vez, en un escenario más pequeño.
La pieza anterior, Agentes LLM locales en un RTX 3090, probó 5 modelos locales en 2 marcos de agentes en 17 tareas: 12 de codificación, 5 de agente general. qwen3-coder:30b encabezó esa clasificación limpiamente. Fue una prueba justa y decía la verdad sobre ese alcance.
Jarvis tiene un alcance completamente diferente. No son 17 tareas en un arnés limpio: ~90 herramientas reales, un sistema de contexto personal y años de solicitudes reales y desordenadas registradas en Langfuse, el rastreo autohospedado de Jarvis. Si la ganancia en el benchmark iba a generalizarse en algún lugar, debería generalizarse aquí.
La configuración: una repetición, no una repetición
Saqué 28 indicaciones de tareas históricas reales directamente de los rastros Langfuse del propio Jarvis (ventana de 90 días), estratificadas en 7 categorías (calendario, código, correo electrónico, archivos, general, mensajería, notas), 4 cada una.
El lado de la comparación de Claude es su respuesta de producción histórica real, ya registrada en Langfuse. No lo volví a ejecutar. Volver a ejecutar Claude a través de un arnés de espacio aislado significaría alimentarlo con datos de herramientas falsas que en realidad nunca vio, lo que lo perjudica sin una buena razón: la línea de base honesta es la respuesta que realmente dio, con los datos reales que realmente tenía. Esa línea de base está congelada: es idéntica en las dos rondas siguientes. Sólo se vuelve a ejecutar el modelo local.
El lado local es una nueva ejecución a través de un arnés de reproducción en espacio aislado: el código real del agente Jarvis LangGraph, en proceso, con todas las herramientas con capacidad de escritura (enviar correo electrónico, escribir en el calendario, publicar en Discord/WhatsApp, escribir archivos) interceptadas para que no suceda nada real. Las herramientas de solo lectura que tocan sistemas externos reales (Outlook COM para correo electrónico y calendario) también son interceptadas, pero la simulación sirve la salida real registrada del seguimiento Langfuse original de esa tarea cuando existe, no un código auxiliar genérico. El modelo local razona sobre el mismo contenido real de la bandeja de entrada y del calendario que vio Claude, no sobre un texto de marcador de posición inventado.
El contenedor es de denegación predeterminada: cualquier herramienta que no esté en una lista corta y explícita de permitidos es objeto de burla. Ese detalle se ganó su apoyo: entre las dos rondas, Jarvis desarrolló nuevas herramientas, y la denegación predeterminada significó que fueron interceptadas automáticamente en lugar de ejecutarse silenciosamente en mis cuentas reales.
La calidad la califica de forma independiente (no por pares, para evitar sesgos de posición) un juez de LLM (claude-opus-4-8) en una escala de 1 a 5 asignada de 0 a 100, que se aplica de manera idéntica a cada respuesta en ambas rondas.
Vale la pena señalarlo claramente: el juez es un modelo de Claude, y califica las respuestas del propio Claude junto con las locales. Eso es un sesgo de preferencia personal, un efecto documentado en configuraciones de LLM como juez, donde un modelo tiende a calificar los resultados de su propia familia de manera más favorable. No puedo descartarlo claramente y probablemente halague a Claude. Es una limitación real de esta metodología, no una nota a pie de página para enterrar, y es más importante en la ronda 2, donde el modelo local está lo suficientemente cerca como para que un pulgar en la escala cambie la forma en que se lee el resultado.
El costo es la otra mitad de la comparación y necesita un instrumento. El lado de Claude es fácil: Langfuse ya registró la facturación API real para cada llamada histórica. El lado local es la electricidad, que no te factura nada por tarea. Cada ejecución local se registra como un experimento con precio en HomeLab Monitor, la pila de monitoreo de código abierto que mantengo: atribuye la energía medida de la GPU a la ventana que ocupaba cada ejecución y la convierte a mi tarifa dual real. Ninguno de los lados de la comparación de costos es una estimación.
Tres pases antes de que el número fuera confiable
Vale la pena un párrafo, porque solo vale la pena publicar los números a continuación si el proceso que los produjo se mantiene.
El primer pase de puntuación tuvo un error silencioso: el modelo de juez envuelve su respuesta en una lista de bloques de contenido, no en una simple cadena, y el analizador JSON del anotador se atragantó con ~40 de 54 llamadas de los jueces: captó, registró y reemplazó silenciosamente con una puntuación alternativa neutral en lugar de cometer errores en voz alta. Esa carrera dijo Claude 71,6 vs qwen 43,5. Principalmente ruido.
Corregido y vuelto a ejecutar, la brecha se volvió más extrema: Claude 89.2, qwen alcanzó exactamente 15 o 45 en casi todas las tareas. La investigación encontró el verdadero problema: 16 de las 28 tareas son calendario, correo electrónico, notas o mensajería, categorías en las que el contenedor de seguridad se burla correctamente de las llamadas COM de Outlook subyacentes, pero la simulación devolvía una cadena enlatada genérica en lugar de datos reales. qwen estaba razonando sobre un texto de marcador de posición mientras la respuesta histórica de Claude se escribía en una bandeja de entrada real. No se trataba de medir la capacidad del modelo, sino de medir quién obtuvo datos reales y quién no. Se solucionó al entregar la salida de la herramienta grabada real del rastreo original dondequiera que la herramienta simulada coincidiera con la que realmente llamó el modelo.
Vuelva a ejecutar limpiamente, luego un tercer error: un límite sostenido de tasa de API de Claude durante la puntuación silenciosamente obtuvo una puntuación neutral en otro lote de llamadas de jueces. Se agregó un bucle de retroceso real y se volvió a ejecutar.
Ese retroceso neutral merece una frase más, porque me volvió a picar en la ronda 2, no como un error, sino como algo que tenía que descartar. El juez devuelve exactamente 70,0 cuando detecta un error de infraestructura. En la ronda 2, ocho de 27 tareas obtuvieron exactamente 70,0. Antes de creer nada de eso, verifiqué cada cadena de razonamiento: los ocho eran juicios genuinos "3/5" con razonamiento sustantivo, cero respaldos de infraestructura, cero respuestas no analizadas. Vale la pena verificar un número que coincida con su centinela del fracaso en lugar de celebrarlo.
Ronda 1: un 3090 y un modelo que no podía ocupar el espacio
El primer intento ejecutó qwen3-coder:30b en un único RTX 3090 compartido con todo lo demás en el laboratorio doméstico. Ese intercambio estableció un límite estricto: con ~18 GB de pesos residentes, la ventana de contexto tuvo que reducirse a 16,384 tokens. Los esquemas de herramientas de Jarvis y el indicador del sistema por sí solos casi llenan eso.
Claude promedió 89,4/100. qwen3-coder:30b promedió 22,8/100.
qwen nunca ganó una sola categoría. Calendario y general (las tareas que se basan más en el razonamiento sobre un contexto dado que en encadenar herramientas correctamente) fueron sus mejores resultados, e incluso aquellas obtuvieron un tercio de la puntuación de Claude.
donde se rompió
El nivel de calidad es el resumen; No es el modo de falla interesante.
qwen filtró una etiqueta de llamada de herramienta con formato incorrecto en 7 de 27 respuestas finales (25,9%); en lugar de emitir una llamada de herramienta LangGraph adecuada, emitió texto sin formato como… directamente en la respuesta que un usuario habría leído.
El recuerdo de superposición de herramientas promedió 14,8%, medido solo en 18 de 27 tareas en las que el rastro histórico real realmente utilizó al menos una herramienta. La mayoría de las veces, qwen llamó a herramientas diferentes a las que históricamente resolvieron la tarea, o ninguna.
Y en 2 de 27 tareas, una genuina falla de orquestación: piloto-17 (correo electrónico, 24 llamadas a herramientas) y piloto-27 (mensajes, 27 llamadas a herramientas) se quedaron atascados llamando a la misma herramienta ya respondida una y otra vez en lugar de sintetizar una respuesta y detenerse. Revisé los registros sin procesar específicamente para descartar el error anterior de datos simulados: ambas tareas recibieron correctamente datos reproducidos reales. Un fallo en la condición de parada, no una inanición.
Dos formas de mentir sobre un simulacro
Una tarea hizo que ambos modelos llamaran a send_email(…) dentro del arnés: interceptado correctamente, no se envió nada, en cualquier caso. Luego, Claude le dijo al usuario que se había enviado el correo electrónico. No fue así; eso es una invención. qwen informó correctamente que el envío no se realizó.
Es tentador leer eso como "qwen es más honesto". No es tan limpio: qwen también es el modelo que filtra la sintaxis de llamada de función sin procesar en el texto de cara al usuario una cuarta parte del tiempo y realiza un bucle dos veces. Ambos modelos manejaron mal el entorno burlado, en direcciones opuestas: uno afirmó demasiado el éxito, el otro no cumplió con la finalización de las tareas básicas. Vale la pena saberlo, no una moraleja.
Mismo modelo, habitación mucho más dura.
Esto es lo que hizo que la ronda 1 fuera un hallazgo real en lugar de una volcada barata: qwen3-coder:30b es exactamente el mismo modelo, los mismos pesos, la misma GPU, que obtuvo un 100% de éxito en la tarea en mi punto de referencia controlado anterior: 17 tareas, una superficie de herramienta mucho más pequeña, un arnés diseñado específicamente.
Al caer en el entorno real de Jarvis, su confiabilidad colapsó. No porque el modelo empeorara. Porque la sala se volvió mucho más difícil, y un modelo que es excelente en un punto de referencia con alcance no es automáticamente un lugar seguro para una superficie grande y real de agente de producción.
Esa fue la conclusión honesta, y la versión original de este artículo terminaba ahí: Jarvis se queda con Claude.
Luego cambié de habitación.
Ronda 2: tres 3090 y un modelo que encaja
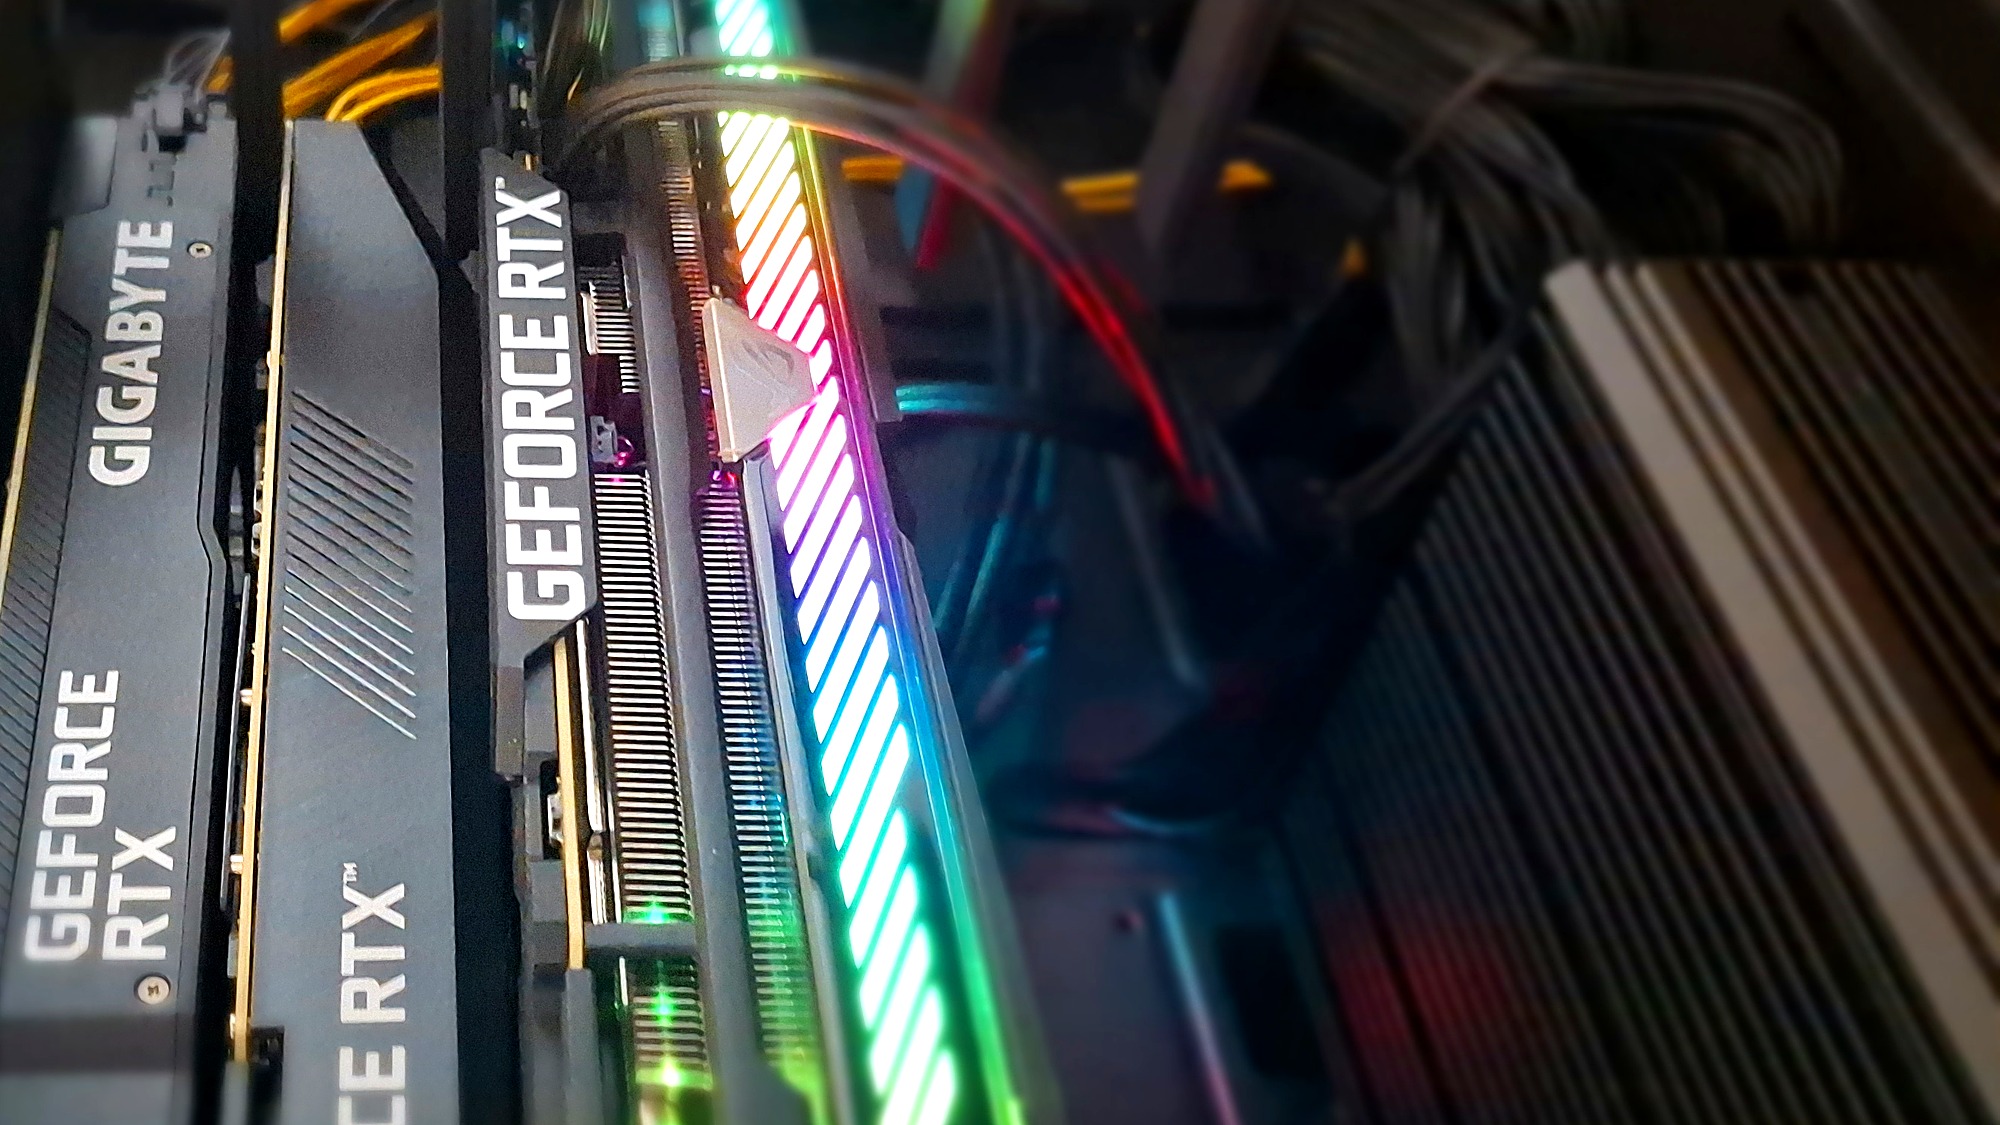
La nueva caja tiene tres RTX 3090: 72 GB de VRAM. Ese presupuesto compra una clase diferente de modelo: una combinación de expertos de 122 mil millones de parámetros en Q3_K_M, alrededor de 53 GB de peso, servido completamente en GPU sin derrame de CPU. Y compra lo que resultó más importante: una ventana de contexto de 256.000 tokens, un aumento de 16 veces con respecto a los 16.384 de la ronda 1.
Mismas 27 tareas. La misma línea de base congelada de Claude. Mismo juez, misma rúbrica, mismo arnés.
80,0/100.
Eso es el 89,4% de la puntuación de Claude, frente al 25% en la ronda 1. En 14 de las 27 tareas, el modelo local obtuvo una puntuación igual o superior a Claude.
Por categorías, la forma del cambio es más interesante que la media:

general es la única categoría en la que el modelo local supera claramente a Claude: 90 a 85. Las notas y los correos electrónicos llegan a unos pocos puntos. archivos es donde todavía está claramente por detrás con 64, y esa es la categoría que más depende de encadenar varias llamadas a herramientas correctamente en lugar de razonar sobre el contenido que se entregó.
La confiabilidad es donde el cambio es más marcado
La filtración de llamadas de herramientas con formato incorrecto pasó de 7 de 27 a cero. No reducido, desaparecido. En la ronda 1, una cuarta parte de las respuestas tenían sintaxis cruda en el texto de cara al usuario; en la ronda 2, ninguno lo hizo.
La recuperación de superposición de herramientas pasó del 14,8% al 38,0%: 2,6 veces mejor y sigue siendo la brecha restante más clara. El modelo ahora produce de manera confiable llamadas a herramientas bien formadas; todavía a menudo elige herramientas diferentes a las que históricamente resolvieron la tarea.
La tarea que aún no encaja
Una tarea nunca se ejecutó en ninguna de las rondas. pilot-12 es un volcado de código: 336.906 caracteres. La ronda 1 lo excluyó sin ceremonia frente a una ventana de 16.384 tokens.
La ronda 2 tenía 256.000 tokens para trabajar, y todavía no encaja. Ollama lo rechazó precisamente:
la solicitud (281190 tokens) excede el tamaño de contexto disponible (256000 tokens)
El techo se movió 16 veces y, de todos modos, la tarea lo desbordó en aproximadamente 25.000 fichas. Un recordatorio útil de que el "contexto más amplio" es un objetivo en movimiento, el trabajo real sigue superándose, y la razón por la que ambas rondas informan 27 tareas en lugar de 28.
Lo que esta medición no puede decirte
Quiero ser directo acerca de los límites aquí, porque el titular es tentador de leer demasiado.
Dos variables cambiaron a la vez. La segunda ronda no es una actualización de modelo aislada. Es un modelo más grande y una ventana contextual 16 veces más grande y tres GPU en lugar de una tarjeta compartida. No ejecuté el control que los separaría: qwen3-coder:30b en el nuevo cuadro en un contexto de 256K. Sin él, puedo decirles que el sistema mejoró dramáticamente; No puedo decirle cuánto pertenece a los parámetros adicionales versus simplemente ya no truncar los esquemas de herramientas y el contexto personal de Jarvis en 16K.
Mi conjetura honesta es que el contexto hace más trabajo que el recuento de parámetros, porque las fallas más características de la ronda 1 (llamadas a herramientas mal formadas, selección de herramientas incorrecta, bucles) son exactamente lo que se esperaría de un modelo cuyas definiciones de herramientas se cortan a mitad del esquema. El hecho de que la tasa de llamadas mal formadas llegara exactamente a cero apunta de la misma manera: se parece más a "los esquemas encajan ahora" que a "el modelo se volvió más inteligente". Pero ésta es una hipótesis que no he probado y prefiero etiquetarla como tal que disfrazarla de conclusión.
El juez sigue siendo un modelo de Claude, con la misma advertencia de autopreferencia que en la ronda 1, ahora aplicada a una comparación en la que el modelo local es competitivo, que es exactamente donde ese sesgo importa más.
El costo local casi sale mal y la razón se generaliza a cualquier configuración distribuida. La energía se atribuye al anfitrión que se está observando. En la ronda 1, la máquina que impulsaba el punto de referencia y la máquina que ejecutaba el modelo eran la misma caja, así que eso fue correcto sin que tuviera que pensar en ello. En la ronda 2 no lo son: el arnés se ejecuta en mi escritorio, el modelo se ejecuta en la caja de la GPU y la primera pasada atribuyó debidamente el trabajo a la tarjeta inactiva del escritorio. El resultado fue de 0,0 kWh.
No hubo ningún error. Lo capté sólo porque el cero era demasiado claro para ser verdad y lo volví a medir desde cero: probando las tres tarjetas a 1 Hz, integrando la energía en la ventana exacta de cada tarea y corrigiendo un desfase de reloj de 4 segundos entre las dos máquinas. Si toma un hábito de este artículo, tome ese: un instrumento que concuerda con sus esperanzas merece más escrutinio, no menos, y “sospechosamente redondo” es una lectura que vale la pena perseguir en lugar de celebrar.
Lo que realmente cuesta
Con el precio de la tarifa eléctrica de mi casa, las 27 tareas consumieron 0,1573 kWh en las tres tarjetas.
Dos cosas que vale la pena leer en esa tabla. El modelo local sigue siendo aproximadamente tres órdenes de magnitud más barato que la API. Y la actualización no fue gratuita: el 122B cuesta 6,6 veces más por tarea que el 30B. Pasar de “inutilizable y casi gratuita” a “utilizable y casi gratuita” cuesta electricidad real; es sólo que aquí “electricidad real” significa fracciones de centavo.
Una advertencia sobre ese número: es asqueroso, incluido el sorteo inactivo. Esas tres tarjetas consumen alrededor de 107 W simplemente manteniendo el modelo residente, porque lo mantengo cargado permanentemente para la latencia. Si solo pusiera en marcha un modelo según la demanda, su costo por tarea sería diferente: menor costo marginal, mayor latencia.
Lo que realmente cambió en Jarvis
Jarvis ahora funciona con el modelo 122B local. Tiene aproximadamente una semana.
Cancelé la suscripción a Claude Max y me quedé con Pro. Ese es el marcador honesto: no "ganaron los modelos locales", sino "los modelos locales se volvieron lo suficientemente buenos como para que el nivel superior de mi gasto en API dejara de ganarse la vida". Claude sigue siendo el mejor modelo en este punto de referencia (89,4 a 80,0) y sigue siendo lo que busco cuando quiero que la respuesta sea correcta la primera vez.
Lo que cambió es que la brecha dejó de ser categórica. En la ronda 1, el modelo local no era una peor opción, estaba rota: una cuarta parte de sus respuestas tenían sintaxis de llamada de herramientas en el texto. No puedes poner eso frente a una bandeja de entrada real a cualquier precio. En la segunda ronda es un intercambio genuino: algunos puntos de calidad, en tareas que puedo identificar de antemano, para aproximadamente una reducción de costos del 99,9% y mis datos nunca salen de casa.
La brecha restante también es específica y no difusa, lo que la hace manejable. Los archivos con un 64% y un 38% de recuperación de herramientas dicen lo mismo: este modelo es bueno para razonar sobre lo que le entregas y sigue siendo mediocre a la hora de decidir qué herramientas utilizar. Entonces, las tareas que aún le enviaría a Claude son las de varios pasos, y eso es una regla de enrutamiento, no una suscripción.
Si estás realizando el mismo experimento: lo que movió la aguja no fue elegir un modelo más inteligente. Le estaba dando a un modelo adecuado suficiente contexto para ver toda la superficie de la herramienta a la vez. Lo probaría antes de gastar dinero en parámetros.
¿Dónde está tu línea? ¿Cuántos puntos de calidad vale una tarea antes de dejar de enviarla fuera del edificio?
Todas las imágenes de este artículo (gráficos y fotografías) fueron creadas por el autor.
Cada cifra de energía y costo aquí se midió con HomeLab Monitor, una pila de contenedor único con licencia del MIT que mantengo para fijar el precio de los experimentos locales. La reseña más breve y técnica de este arnés se encuentra en dev.to.