
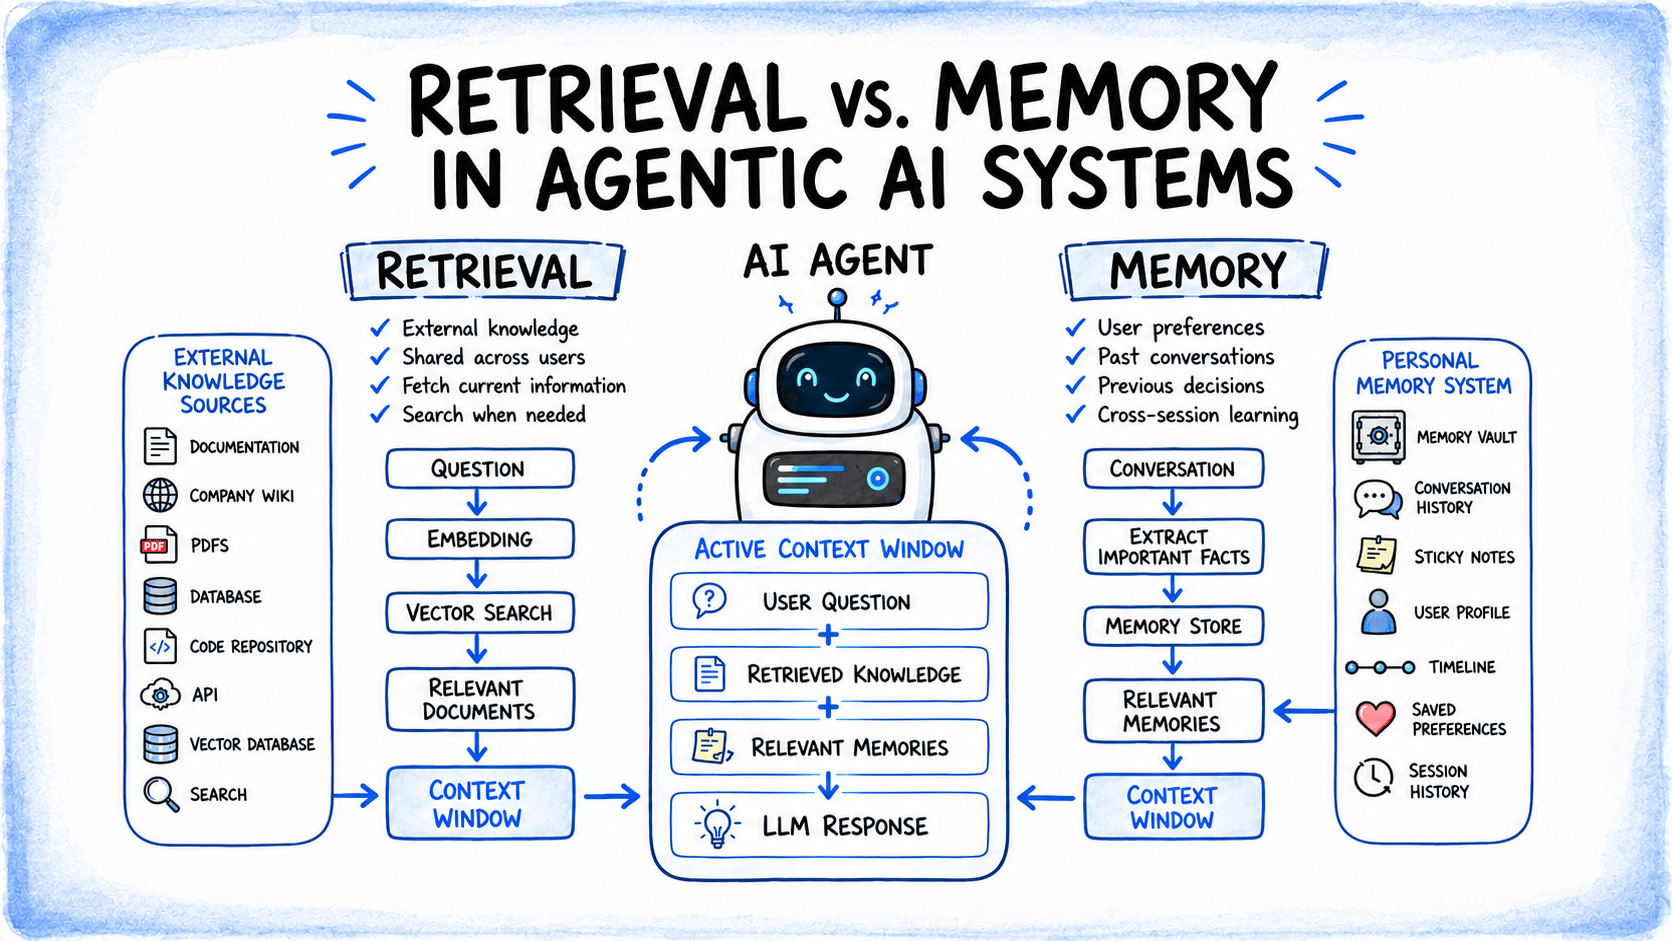
En este artículo, aprenderá las diferencias conceptuales y prácticas entre la recuperación y la memoria en los sistemas de inteligencia artificial agentes, y cómo combinar ambas de manera efectiva.
Los temas que cubriremos incluyen:
Qué separa la recuperación de la memoria y por qué la distinción es importante para los agentes de larga duración. Cómo se construyen los canales de recuperación y los sistemas de memoria, ilustrado con un ejemplo concreto. Cómo combinar recuperación y memoria en una arquitectura de agente única y eficaz.
Introducción
Un agente de IA que no puede recordar sus interacciones anteriores no es de mucha ayuda. Cada modelo de lenguaje grande tiene una ventana de contexto fija, y una vez que una conversación, un conjunto de resultados de herramientas o una pila de documentos recuperados supera ese límite, es necesario descartar, resumir o recuperar algo nuevo. Los desarrolladores que crean agentes de larga duración se topan con esto constantemente. El agente vuelve a hacer preguntas que ya respondió, contradice decisiones que tomó anteriormente o no reconoce que existe un documento que necesita.
La recuperación y la memoria son los dos mecanismos que abordan esto y resuelven diferentes mitades del problema. La recuperación extrae conocimiento externo con el que el modelo nunca fue entrenado y que no debería tener que llevar de forma predeterminada, como documentación, código y registros de bases de datos. La memoria persiste en lo que el propio agente ha aprendido o hecho, a lo largo de una sesión o de muchas, por lo que no comienza siempre desde cero. Confundir los dos, o construir solo uno, es donde muchas arquitecturas de agentes fallan. Este artículo cubre:
Qué separa la recuperación de la memoria a nivel conceptual Cómo se construyen cada uno de ellos un proceso de recuperación y un sistema de memoria, con un ejemplo práctico Una comparación lado a lado de los dos Cómo combinar ambos en un sistema agente único y eficaz
Empezaremos explicando por qué existe la división en primer lugar.
Comprender por qué el contexto fuerza una división
Una ventana de contexto es el conjunto total de tokens que el modelo puede ver a la vez: aviso del sistema, historial de conversaciones, resultados de herramientas, cualquier cosa insertada con anticipación. Es finito, y cada ficha que contiene se atiende en cada pase hacia adelante, por lo que simplemente hacer que la ventana sea más grande no se escala como debería. La ingeniería de contexto ha surgido como la disciplina de curar y gestionar ese recurso limitado, tratándolo como el estado completo disponible para el modelo en un momento dado, no solo como un lugar para rellenar instrucciones.
Dada esa restricción, un agente tiene dos tipos de información que necesita pero que no puede mantener permanentemente en contexto:
Información que existe fuera del modelo y fuera de la conversación actual, como una base de conocimientos, una base de código o un conjunto de documentos de políticas. Esto es lo que maneja la recuperación. Información que el agente generó o aprendió por sí mismo y que debe sobrevivir a la ventana de contexto actual, como una decisión tomada hace diez turnos o un hecho sobre un usuario específico. Esto es lo que maneja la memoria.
Ambos se implementan con herramientas similares: incrustaciones, búsqueda de vectores, tiendas estructuradas. La diferencia clave es qué almacenan y de dónde proviene la información. La recuperación busca un corpus fuera del agente, mientras que la memoria almacena información de las propias interacciones y acciones pasadas del agente.
Definición de recuperación en sistemas agentes
La recuperación es la forma en que un agente responde “¿qué sabe el mundo sobre esto que yo no tenga en mis pesas o en mi contexto actual?”. La implementación más común es la generación de recuperación aumentada o RAG:
Los documentos originales se dividen en pasajes lo suficientemente pequeños como para resultar útiles. Cada fragmento se convierte en una incrustación y se almacena en un índice vectorial. En el momento de la consulta, la pregunta entrante se incrusta de la misma manera y el índice devuelve las coincidencias más cercanas. Esas coincidencias se insertan en el mensaje junto con la pregunta del usuario.
Este patrón generalmente se ejecuta en almacenes de datos administrados con una capa de orquestación que vincula el paso de recuperación con el resto del razonamiento del agente: el enfoque detrás de la mayoría de las arquitecturas de generación de recuperación aumentada en producción hoy en día. El corpus en sí se comparte (cada usuario que pregunta sobre la misma documentación del producto accede al mismo índice) y se actualiza según su propio cronograma, independientemente de cualquier conversación individual.
Definición de memoria en sistemas agentes
La memoria es la forma en que un agente responde “lo que ya he aprendido o hecho y que necesito seguir adelante”. Se divide en dos capas que se comportan de manera diferente:
La memoria a corto plazo es el estado de la sesión en ejecución: la conversación hasta el momento, más todo lo que el agente haya escrito en un bloc de notas durante la tarea actual. Es barato y desaparece cuando termina la sesión. La memoria a largo plazo persiste a lo largo de las sesiones. Tiene que responder a una pregunta más difícil que la recuperación: no sólo “qué es relevante”, sino “qué vale la pena conservar en primer lugar”.
Algunos sistemas de memoria de agentes extraen automáticamente hechos, preferencias y contexto útiles de las conversaciones y los almacenan para su uso posterior. Al comienzo de una nueva sesión, el agente puede consultar esa memoria de manera muy similar a como consultaría un índice de recuperación, pero los resultados son específicos de un usuario, tarea o agente en lugar de un corpus de documentos compartido. Al diseñar esta capa, los equipos pueden explorar diferentes estrategias de memoria de agentes y marcos de memoria de agentes según lo que necesiten almacenar y recuperar.
Un ejemplo rápido elaborado hace que la división sea concreta. Un cliente envía un mensaje a un agente de soporte sobre un pedido retrasado.
Para un pedido retrasado, el agente primero verifica en su memoria el historial anterior del cliente. Encuentra una nota de hace tres semanas que dice que prefieren el seguimiento por correo electrónico y que un problema de envío similar se resolvió con un reembolso parcial. Eso es memoria, porque proviene del registro del agente de este cliente específico.

Luego, el agente necesita la política de envío actual, que cambió el mes pasado, por lo que busca en la documentación de la empresa y recupera la sección correspondiente. Eso es recuperación, porque la información proviene de una fuente externa y se aplica a todos los clientes. Ambos resultados se agregan al mismo mensaje, pero responden a preguntas diferentes.
Comparación de recuperación y memoria
Dispuestas una al lado de la otra, las diferencias entre recuperación y memoria son más fáciles de ver de un vistazo:
Dimensión Recuperación Memoria Fuente de información Corpus externo que el agente no creó Las propias interacciones o razonamientos pasados del agente Alcance Compartido entre todos los usuarios y sesiones Específico de un usuario, tarea o sesión Qué responde “¿Qué sabe el mundo sobre esto?” “¿Qué he aprendido o hecho ya?” Mecanismo de actualización Volver a indexar el corpus según una programación o en escritura Consolidar, actualizar o caducar los datos almacenados Modo de error típico Documentos obsoletos o faltantes en el índice Datos contradictorios u obsoletos sobre un usuario Patrón de costos Lectura intensa; una búsqueda por consulta Lectura y escritura; la extracción se ejecuta después de cada interacción
Los modos de falla enumerados en la tabla anterior explican por qué un agente creado con solo uno de los dos tiende a fallar de manera predecible y por qué la mayoría de los sistemas en funcionamiento terminan necesitando ambos.
Combinando recuperación y memoria en un sistema eficaz
Un agente con recuperación pero sin memoria vuelve a sacar las mismas conclusiones en cada sesión y no puede personalizar nada. Un agente con memoria pero sin recuperación conoce su propia historia pero no tiene forma de fundamentarse en nada fuera de esa historia; no puede responder preguntas sobre una política que cambió después de que finalizaron sus datos de entrenamiento. Hacer la combinación correcta se reduce a algunas cosas:
El filtrado importa más que el tamaño de la ventana. Agregar más documentos recuperados o entradas de memoria no necesariamente mejora las respuestas. Más allá de cierto punto, el contexto adicional puede empeorar las respuestas porque el modelo tiene que procesar y sopesar cada token adicional. Las búsquedas pequeñas y específicas suelen ser más efectivas que una búsqueda amplia y pueden mantener la eficiencia de los tokens de recuperación. El estancamiento funciona de manera diferente para la recuperación y la memoria. Un índice de recuperación queda obsoleto cuando los documentos subyacentes cambian sin volver a indexarse. La memoria se vuelve obsoleta cuando la información sobre un usuario cambia, como una preferencia o un plan, pero el dato almacenado no se actualiza ni se elimina. La memoria agrega un costo de escritura. La recuperación generalmente implica buscar información cuando el agente la necesita. La memoria también requiere decidir qué información vale la pena guardar después de una interacción, lo que puede agregar llamadas al modelo y tiempo de procesamiento. Esta extracción a menudo se maneja de forma asincrónica para no ralentizar la respuesta del agente. Es necesario fusionar cuidadosamente las dos fuentes. La recuperación y la memoria pueden devolver información que se superpone o entra en conflicto. El agente necesita reglas claras para decidir cuánto peso darle a cada fuente y cómo utilizar ambas en el mismo contexto.
El trabajo de diseño para la recuperación y la memoria se reduce a decidir qué pertenece a cada uno, con qué agresividad podar ambos y cómo se unen en un solo mensaje sin entregar los tokens modelo que no necesita.
Resumen
La recuperación y la memoria resuelven diferentes problemas en sistemas de agentes de larga duración. La recuperación aporta información externa que el agente necesita en ese momento, como documentación, políticas, código o registros de bases de datos. La memoria transmite información de interacciones anteriores, como decisiones, preferencias y contexto específico del usuario. La distinción es importante porque los dos sistemas tienen alcances, preocupaciones de frescura y modos de falla diferentes. La recuperación depende de mantener actualizadas las fuentes externas, mientras que la memoria depende de decidir qué vale la pena almacenar y cuándo la información almacenada ya no es válida.
Las arquitecturas de agentes más eficaces utilizan ambos. Filtran lo que entra en el contexto, mantienen la información razonablemente actualizada y fusionan el conocimiento recuperado con la memoria relevante en lugar de tratarlos como un registro completo de todo lo que el agente necesita saber.
El objetivo, por tanto, es darle al agente el contexto que necesita, cuando lo necesita, sin llevar información innecesaria.