
sabes que son apátrate. Si no lo ha hecho, piense que no tienen memoria a corto plazo.
Un ejemplo de esto es la película Recuerdodonde el protagonista debe recordar constantemente lo que ha sucedido, utilizando notas adhesivas con hechos para reconstruir lo que debe hacer a continuación.
Para conversar con LLM, necesitamos recordarles constantemente la conversación cada vez que interactuamos.
Implementar lo que llamamos “memoria o estado a corto plazo” es fácil. Simplemente tomamos algunos pares de preguntas y respuestas anteriores e incluimos en cada llamada.
La memoria a largo plazo, por otro lado, es una bestia completamente diferente.
Para asegurarse de que el LLM pueda extraer los hechos correctos, comprender las conversaciones anteriores y conectar la información, necesitamos construir algunos sistemas bastante complejos.
Este artículo recorrerá el problema, explorará lo que se necesita para construir un sistema eficiente, pasar por las diferentes opciones arquitectónicas y mirar los proveedores de código abierto y en la nube que pueden ayudarnos.
Pensando en una solución
Primero caminemos por el proceso de pensamiento de construir memoria para LLMS y lo que necesitaremos para que sea eficiente.
Lo primero que necesitamos es que el LLM pueda sacar mensajes viejos para decirnos lo que se ha dicho. Entonces podemos preguntarle: “¿Cómo se llamaba ese restaurante al que me dijiste que fuera en Estocolmo?” Esto sería Extracción de información básica.
Si es completamente nuevo en los sistemas Building LLM, su primer pensamiento puede ser simplemente volcar cada memoria en la ventana de contexto y dejar que la LLM tenga sentido.
Sin embargo, esta estrategia dificulta que el LLM descubra qué es importante y qué no, lo que puede llevarlo a alucinar respuestas.
Su segundo pensamiento puede ser almacenar cada mensaje, junto con resúmenes, y utilizar la búsqueda híbrida para obtener información cuando entra una consulta.

Esto sería similar a la forma en que construye sistemas de recuperación estándar.
El problema con esto es que una vez que comience a escalar, se encontrará con hinchazón de memoria, hechos desactualizados o contradictorios, y una base de datos de vectores creciente que necesita poda constantemente.
Es posible que también deba entender cuándo suceden las cosas, para que pueda preguntar: “¿Cuándo me contó sobre este restaurante?” Esto significa que necesitarías algún nivel de razonamiento temporal.
Esto puede llevarlo a implementar mejores metadatos con marcas de tiempo, y posiblemente un Sistema de autoedición que actualiza y resume las entradas.
Aunque es más complejo, un sistema de autoedición podría actualizar hechos e invalidarlos cuando sea necesario.
Si sigue pensando en el problema, también puede querer que la LLM conecte diferentes hechos (realizar razonamiento de múltiples saltos) y reconozca los patrones.
Entonces, puede hacer preguntas como, “¿A cuántos conciertos he estado este año?” o “¿Cuál crees que es mi gusto musical?” lo que puede llevarlo a experimentar con gráficos de conocimiento.
Organización de la solución
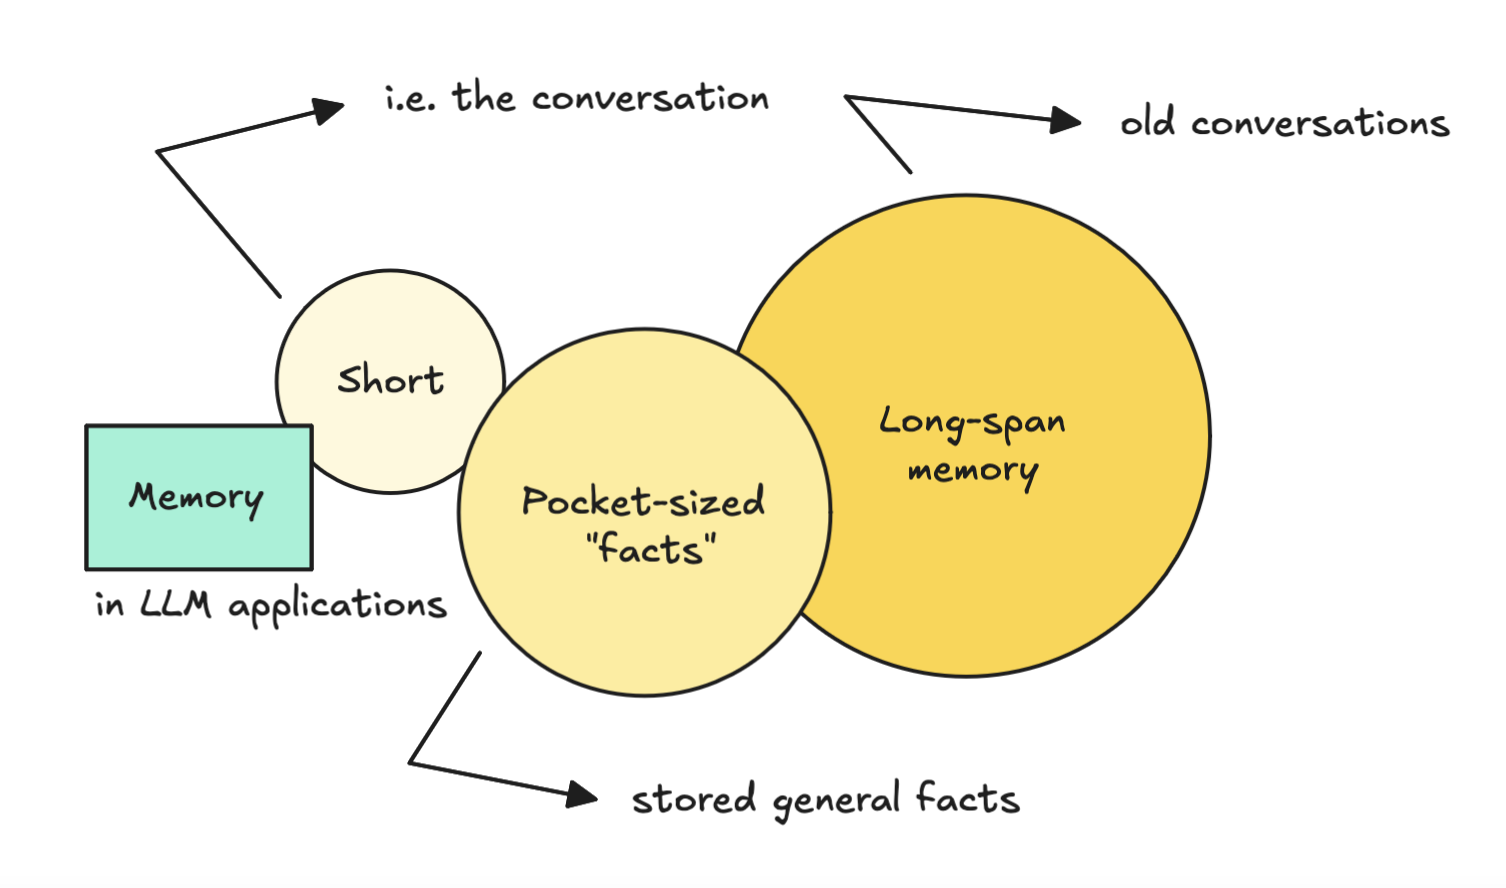
El hecho de que esto se haya convertido en un problema tan grande es empujar a las personas a organizarlo mejor. Pienso en la memoria a largo plazo como dos partes: Hechos de bolsillo y memoria a largo plazo de conversaciones anteriores.
Para la primera parte, hechos de bolsillo, podemos ver el sistema de memoria de ChatGPT como ejemplo.
Para construir este tipo de memoria, es probable que usen un clasificador para decidir si un mensaje contiene un hecho que debe almacenarse.
Luego clasifican el hecho en un cubo predefinido (como perfil, preferencias o proyectos) y actualizan una memoria existente si es similar o crean uno nuevo si no lo es.
La otra parte, la memoria de larga distancia, significa almacenar todos los mensajes y resumir conversaciones completas para que puedan referirse más adelante. Esto también existe en ChatGPT, pero al igual que con la memoria de bolsillo, debe habilitarlo.
Aquí, si construye esto por su cuenta, debe decidir cuánto detalle mantener, mientras tiene en cuenta la hinchazón de la memoria y la creciente base de datos de la que hablamos anteriormente.
Soluciones arquitectónicas estándar
Hay dos opciones de arquitectura principales que puede buscar aquí si observamos lo que otros están haciendo: vectores y gráficos de conocimiento.
Al principio caminé a través de un enfoque basado en la recuperación. Por lo general, es lo que la gente salta cuando comienza. La recuperación utiliza una tienda vectorial (y a menudo una búsqueda escasa), lo que solo significa que admite búsquedas semánticas y de palabras clave.
La recuperación es fácil de comenzar: incrusta sus documentos y obtienes en función de la pregunta del usuario.
Pero hacerlo de esta manera, como hablamos anteriormente, significa que cada entrada es inmutable. Esto significa que los textos seguirán allí incluso si los hechos han cambiado.
Los problemas que pueden venir aquí incluyen obtener múltiples hechos conflictivos, que pueden confundir al agente. En el peor de los casos, los hechos relevantes podrían enterrarse en algún lugar de las pilas de textos recuperados.
El agente tampoco sabrá cuándo se dijo algo o si se refería al pasado o al futuro.
Como hablamos anteriormente, hay formas de evitar esto.
Puede buscar recuerdos antiguos y actualizarlos, agregar marcas de tiempo a los metadatos y resumir periódicamente las conversaciones para ayudar a la LLM a comprender el contexto en torno a los detalles recuperados.
Pero con los vectores, también enfrenta el problema de una base de datos en crecimiento. Eventualmente, deberá podar los datos antiguos o comprimirlos, lo que puede obligarlo a eliminar detalles útiles.
Si observamos los gráficos de conocimiento (KG), representan la información como una red de entidades (nodos) y las relaciones entre ellos (bordes), en lugar de texto no estructurado como se obtiene con los vectores.
En lugar de sobrescribir datos, KGS puede asignar un invalid_at Fecha a un hecho antiguo, para que aún puedas rastrear su historia. Utilizan los recorridos gráficos para obtener información, lo que le permite seguir las relaciones en múltiples lúpulos.
Debido a que los KG pueden saltar entre nodos conectados y mantener los hechos actualizados de una manera más estructurada, tienden a ser mejores en el razonamiento temporal y de múltiples saltos.
Sin embargo, los KG vienen con sus propios desafíos. A medida que crecen, la infraestructura se vuelve más compleja, y puede comenzar a notar una latencia más alta durante los recorridos profundos cuando el sistema tiene que mirar lejos para encontrar la información correcta.
Ya sea que la solución esté basada en vectores o KG, las personas generalmente actualizan recuerdos en lugar de seguir agregando otras nuevas, agregue la capacidad de establecer cubos específicos que vimos para los hechos “de bolsillo” y con frecuencia usan LLM para resumir y extraer información de los mensajes antes de ingerirlos.
Si volvemos a la meta original, con recuerdos de bolsillo y memoria de larga distancia, puede mezclar enfoques de trapo y KG para obtener lo que desea.
Soluciones de proveedor actuales (Play de Plug’n)
Pasaré por algunas soluciones independientes diferentes que lo ayudan a configurar la memoria, observando cómo funcionan, qué arquitectura usan y cuán maduros son sus marcos.
Building Advanced LLM Aplications sigue siendo muy nuevo, por lo que la mayoría de estas soluciones solo se han lanzado en el último año o dos. Cuando está comenzando, puede ser útil ver cómo se crean estos marcos para tener una idea de lo que podría necesitar.
Como se mencionó anteriormente, la mayoría de ellos caen en categorías KG-First o Vector-First.
Si primero observamos ZEP (o Graphiti), una solución basada en KG, usan LLM para extraer, agregar, invalidar y actualizar nodos (entidades) y bordes (relaciones con marcas de tiempo).
Cuando hace una pregunta, realiza una búsqueda semántica y de palabras clave para encontrar nodos relevantes, luego atraviesa los nodos conectados para obtener hechos relacionados.
Si se produce un nuevo mensaje con hechos contradictorios, actualiza el nodo mientras mantiene el viejo hecho en su lugar.
Esto difiere de MEM0, una solución basada en vectores, que agrega hechos extraídos uno encima del otro y utiliza un sistema de autoedición para identificar y sobrescribir los hechos no válidos por completo.
Letta funciona de manera similar, pero también incluye características adicionales como Core Memory, donde almacena resúmenes de conversación junto con bloques (o categorías) que definen lo que debe poblarse.
Todas las soluciones tienen la capacidad de establecer categorías, donde definimos lo que debe capturarse con el sistema. Por ejemplo, si está creando una aplicación de atención plena, una categoría puede ser el “estado de ánimo actual” del usuario. Estos son los mismos cubos de bolsillo que vimos anteriormente en el sistema de ChatGPT.
Una cosa, de la que hablé antes, es cómo los enfoques vectoriales tienen problemas con el razonamiento temporal y de múltiples saltos.
Por ejemplo, si digo que me mudaré a Berlín en dos meses, pero anteriormente mencionó vivir en Estocolmo y California, ¿entenderá el sistema que ahora vivo en Berlín si lo pregunto meses después?
¿Puede reconocer los patrones? Con los gráficos de conocimiento, la información ya está estructurada, lo que facilita que el LLM utilice todo el contexto disponible.
Con los vectores, a medida que crece la información, el ruido puede ser demasiado fuerte para que el sistema conecte los puntos.
Con Letta y Mem0, aunque más maduros en general, estos dos problemas aún pueden ocurrir.
Para los gráficos de conocimiento, la preocupación es sobre la complejidad de la infraestructura a medida que se escala y cómo gestionan cantidades crecientes de información.
Aunque no las he probado a todos a fondo y todavía faltan piezas (como números de latencia), quiero mencionar cómo manejan la seguridad empresarial en caso de que esté buscando usarlas internamente con su empresa.
La única opción de nube que encontré que es certificada SOC 2 Tipo 2 es ZEP. Sin embargo, muchos de estos pueden ser autohospedados, en cuyo caso la seguridad depende de su propia infra.
Estas soluciones siguen siendo muy nuevas. Puede terminar construyendo la suya más tarde, pero le recomendaría probarlos para ver cómo manejan los casos de borde.
Economía del uso de proveedores
Es genial poder agregar funciones a sus aplicaciones LLM, pero debe tener en cuenta que esto también agrega costos.
Siempre incluyo una sección sobre la economía de implementar una tecnología, y esta vez no es diferente. Es lo primero que verifico al agregar algo. Necesito entender cómo afectará a la economía unitaria de la aplicación en el futuro.
La mayoría de las soluciones de proveedores le permitirán comenzar de forma gratuita. Pero una vez que vaya más allá de unos pocos miles de mensajes, los costos pueden sumar rápidamente.
Recuerde que si tiene unos cientos de conversaciones por día en su organización, el precio comenzará a sumar cuando envíe cada mensaje a través de estas soluciones en la nube.
Comenzar con una solución de nube puede ser ideal, y luego cambiar a autohospedaje a medida que crece.
También puede probar un enfoque híbrido.
Por ejemplo, implemente su propio clasificador para decidir qué mensajes vale la pena almacenar como hechos para mantener bajos los costos, mientras empuja todo lo demás a su propia tienda vectorial para que se comprime y resuman periódicamente.
Dicho esto, el uso de hechos del tamaño de bytes en la ventana de contexto debería superar el pegado en una parte de la historia de 5,000 token. Dar los hechos relevantes de la LLM por adelantado también ayuda a reducir las alucinaciones y, en general, reduce los costos de generación de LLM.
Notas
Es importante tener en cuenta que incluso con los sistemas de memoria en su lugar, no debe esperar la perfección. Estos sistemas aún alucinan o pierden las respuestas a veces.
Es mejor entrar en las imperfecciones que perseguir al 100 % de precisión, se ahorrará la frustración.
Ningún sistema actual alcanza la precisión perfecta, al menos aún no. La investigación muestra que las alucinaciones son una parte inherente de LLM. Incluso agregar capas de memoria no elimina este problema por completo.
Espero que este ejercicio lo ayude a ver cómo implementar la memoria en los sistemas LLM si es nuevo en él.
Todavía faltan piezas, como cómo escalan estos sistemas, cómo los evalúa, la seguridad y cómo se comporta la latencia en los entornos del mundo real.
Tendrás que probar esto por tu cuenta.
Si quieres seguir mi escritura, puedes conectarte conmigo en LinkedIno guarde un cheque para mi trabajo aquí, Medio o por el mío sitio web.
Espero sacar algunos artículos más sobre Evals y solicitar este verano y me encantaría el apoyo.
❤️