
Las GPU sirven como motores computacionales fundamentales para la IA. Sin embargo, en entornos de entrenamiento a gran escala, el rendimiento general no está limitado por la velocidad de procesamiento, sino por la velocidad de la comunicación de la red entre ellos.
Los modelos de idiomas grandes están capacitados en miles de GPU, lo que crea una gran cantidad de tráfico cruzado de GPU. En estos sistemas, incluso el compuesto de retrasos más pequeños. Un retraso de microsegundos cuando las GPU comparten datos pueden causar una reacción en cadena que agrega horas al trabajo de capacitación. Por lo tanto, estos sistemas requieren una red especializada diseñada para transferir grandes cantidades de datos con un retraso mínimo.
El enfoque tradicional de enrutar datos de GPU a través de la CPU creó un cuello de botella severo a escala. Para arreglar este cuello de botella, se inventaron tecnologías como RDMA y GPUDIRECT para construir esencialmente un bypass alrededor de la CPU. Esto crea un camino directo para que las GPU se hablen.
Este método de comunicación directa necesita una red que pueda manejar la velocidad. Las dos opciones principales disponibles hoy para proporcionar esto son Infiniband y Rocev2.
Entonces, ¿cómo eliges entre Infiniband y Rocev2? Es un gran problema, lo que lo obliga a equilibrar la velocidad bruta contra el presupuesto y cuánta afinación práctica está dispuesta a hacer.
Echemos un vistazo más de cerca a cada tecnología para ver sus fortalezas y debilidades.
Conceptos básicos
Antes de comparar Infiniband y Rocev2, primero comprendamos cómo funciona la comunicación tradicional e introducimos algunos conceptos básicos como RDMA y GPU directamente.
Comunicación tradicional
En los sistemas tradicionales, la CPU maneja la mayor parte del movimiento de datos entre máquinas. Cuando una GPU termina su cálculo y necesita enviar datos a un nodo remoto, sigue los siguientes pasos –
- La GPU escribe los datos en la memoria del sistema (host)
- La CPU copia esos datos en un búfer utilizado por la tarjeta de red
- La NIC (tarjeta de interfaz de red) envía los datos a través de la red
- En el nodo receptor, la NIC entrega los datos a la CPU
- La CPU lo escribe en la memoria del sistema
- La GPU lo lee desde la memoria del sistema
Este enfoque funciona bien para sistemas pequeños, pero no escala para las cargas de trabajo de IA. A medida que se copian más datos, los retrasos comienzan a sumar y la red lucha por mantenerse al día.
RDMA
El acceso remoto a la memoria directa (RDMA) permite que una máquina local acceda a la memoria de una máquina remota directamente sin involucrar la CPU en el proceso de transferencia de datos. En esta arquitectura, la tarjeta de interfaz de red maneja todas las operaciones de memoria de forma independiente, lo que le permite leer o escribir en ubicaciones de memoria remota sin crear copias intermedias de los datos. Esta capacidad de acceso de memoria directa elimina los cuellos de botella tradicionales asociados con las transferencias de datos mediadas por CPU y reduce la latencia general del sistema.
RDMA resulta particularmente valioso en entornos de capacitación de IA donde miles de GPU deben compartir información de gradiente de manera eficiente. Al evitar los gastos generales del sistema operativo y los retrasos en la red, RDMA permite la comunicación de alto rendimiento y baja latencia esencial para las operaciones de aprendizaje automático distribuido.
Gpudirect rdma
GPUDIRECT es la forma de NVIDIA de dejar que las GPU hablen directamente con otro hardware a través de conexiones PCIe. Normalmente, cuando una GPU necesita transferir datos a otro dispositivo, tiene que tomar el largo camino. Los datos pasan de la memoria GPU a la memoria del sistema primero, luego el dispositivo receptor lo toma desde allí. Gpudirect omite la CPU por completo. Los datos se mueven directamente de una GPU a otra.
GPUDIRECT RDMA extiende esto a las transferencias de red permitiendo que la NIC acceda a la memoria GPU directamente usando PCIE.

Ahora que entendemos conceptos como RDMA y GPUDIRECT, veamos las tecnologías de infraestructura Infiniband y ROCEV2 que admiten GPUDIRECT RDMA.
Infiniband
Infiniband es una tecnología de red de alto rendimiento diseñada específicamente para centros de datos y entornos de supercomputación. Si bien Ethernet fue construido para manejar el tráfico general, Infiniband está diseñado para cumplir con la alta velocidad y la baja latencia para las cargas de trabajo de IA.
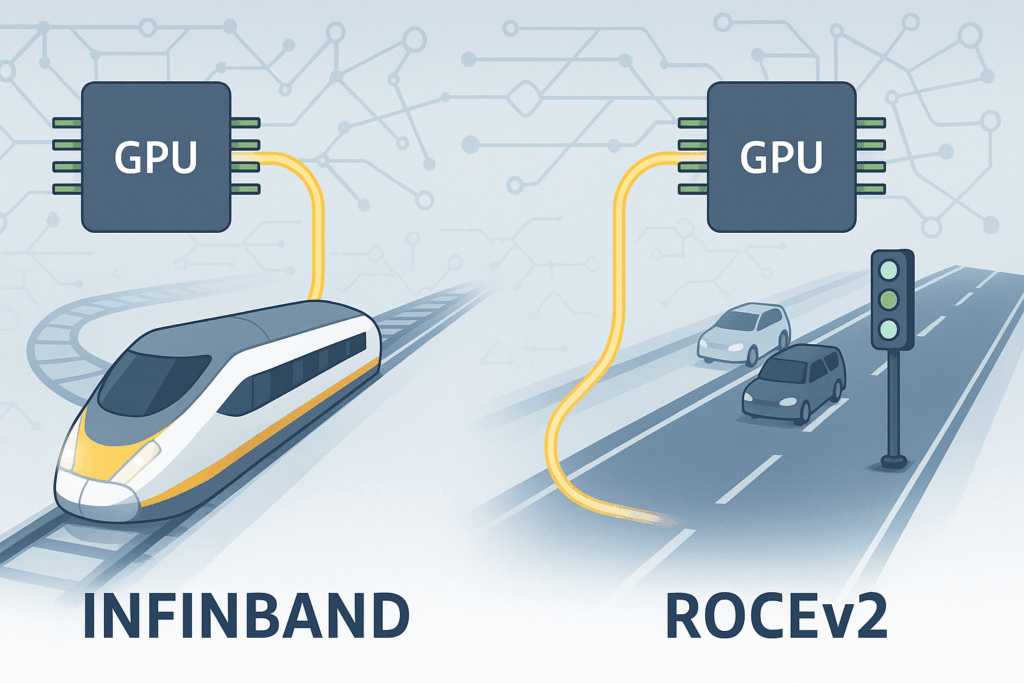
Es como un tren de bala de alta velocidad donde tanto el tren como las vías están diseñadas para mantener la velocidad. Infiniband sigue el mismo concepto, todo, incluidos los cables, las tarjetas de red y los interruptores, están diseñados para mover datos rápidamente y evitar retrasos.
¿Cómo funciona?
Infiniband funciona de manera completamente diferente al Ethernet normal. No utiliza el protocolo TCP/IP regular. En cambio, se basa en sus propias capas de transporte livianas diseñadas para la velocidad y la baja latencia.
En el núcleo de Infiniband está RDMA, que permite que un servidor acceda directamente a la memoria de otro sin involucrar la CPU. Infiniband admite RDMA en hardware, por lo que la tarjeta de red, llamada adaptador de canal de host o HCA, maneja las transferencias de datos directamente sin interrumpir el sistema operativo o crear copias adicionales de datos.
Infiniband también utiliza un modelo de comunicación sin pérdidas. Evita soltar paquetes incluso bajo tráfico pesado mediante el uso de control de flujo basado en crédito. El remitente transmite datos solo cuando el receptor tiene suficiente espacio de búfer disponible.
En grandes grupos de GPU, los conmutadores infiniband mueven datos entre nodos con latencia extremadamente baja, a menudo bajo un microsegundo. Y debido a que todo el sistema está construido para este propósito, todo, desde el hardware hasta el software, trabaja en conjunto para ofrecer una comunicación consistente y de alto rendimiento.
Comprendamos una comunicación simple de GPU a GPU utilizando el siguiente diagrama-
- GPU 1 entrega de datos a su HCA, saltando la CPU
- El HCA inicia una escritura RDMA en la GPU remota
- Los datos se transfieren a través del interruptor infiniband
- El HCA receptor escribe los datos directamente a la memoria de GPU 2
Fortaleza
- Rápido y predecible -Infiniband ofrece latencia ultra baja y alto ancho de banda, manteniendo grandes grupos de GPU funcionando de manera eficiente sin problemas.
- Construido para RDMA -Maneja RDMA en el hardware y utiliza el control de flujo basado en el crédito para evitar gotas de paquetes, incluso bajo una carga pesada.
- Escalable – Dado que todas las partes del sistema están diseñadas para funcionar juntas, el rendimiento no se ve afectado si se agregan nodos adicionales al clúster.
Debilidades
- Caro – El hardware es costoso y principalmente vinculado a Nvidia, lo que limita la flexibilidad.
- Más difícil de manejar – La configuración y el ajuste requieren habilidades especializadas. No es tan sencillo como Ethernet.
- Interoperabilidad limitada – No juega bien con las redes IP estándar, lo que lo hace menos flexible para los entornos de uso general.
Rocev2
ROCEV2 (RDMA Over Converged Ethernet versión 2) trae los beneficios de RDMA a las redes Ethernet estándar. ROCEV2 adopta un enfoque diferente a InfiniBand. En lugar de necesitar hardware de red personalizado, solo utiliza su red IP normal con UDP para el transporte.
Piense en ello como actualizar una carretera regular con un carril expreso solo para datos críticos. No tienes que reconstruir todo el sistema de carreteras. Solo necesita reservar el carril rápido y ajustar las señales de tráfico. ROCEV2 utiliza el mismo concepto, ofrece comunicación de alta velocidad y baja latencia utilizando el sistema Ethernet existente.
¿Cómo funciona?
ROCEV2 lleva RDMA al Ethernet estándar ejecutando UDP e IP. Funciona a través de redes regulares de capa 3 sin necesidad de una tela dedicada. Utiliza interruptores y enrutadores de productos básicos, lo que lo hace más accesible y rentable.
Al igual que Infiniband, ROCEV2 permite el acceso directo a la memoria entre máquinas. La diferencia clave es que, si bien Infiniband maneja el control del flujo y la congestión en un entorno cerrado y bien controlado, ROCEV2 se basa en mejoras a Ethernet, como – como –
Control de flujo prioritario (PFC) – Evita la pérdida de paquetes deteniendo el tráfico en la capa Ethernet en función de la prioridad.
Notificación de congestión explícita (ECN)– Marque los paquetes en lugar de dejarlos caer cuando se detecta la congestión.
Notificación de congestión cuantificada del centro de datos (DCQCN)– Un protocolo de control de congestión que reacciona a las señales ECN para administrar el tráfico de manera más suave.
Para que ROCEV2 funcione bien, la red Ethernet subyacente debe ser sin pérdidas o cerca de ella. De lo contrario, el rendimiento de RDMA cae. Esto requiere una configuración cuidadosa de interruptores, colas y mecanismos de control de flujo en todo el centro de datos.
Entendamos una comunicación simple de GPU a GPU utilizando el siguiente diagrama con ROCEV2-
- GPU 1 entrega los datos a su NIC, saltando la CPU.
- La NIC envuelve la escritura RDMA en UDP/IP y la envía a través de Ethernet.
- Los datos fluyen a través de conmutadores Ethernet estándar configurados con PFC y ECN.
- La NIC receptor escribe los datos directamente a la memoria de GPU 2.
Fortaleza
Rentable-ROCEV2 se ejecuta en hardware Ethernet estándar, por lo que no necesita un tejido de red especializado o componentes de proveedores bloqueados.
Más fácil de implementar-Dado que utiliza redes familiares basadas en IP, es más fácil que los equipos que ya administran los centros de datos Ethernet adoptan.
Integración flexible– ROCEV2 funciona bien en entornos mixtos y se integra fácilmente con las redes de capa 3 existentes.
Debilidades
Requiere ajuste– Para evitar la pérdida de paquetes, ROCEV2 depende de la configuración cuidadosa de PFC, ECN y control de congestión. La mala sintonización puede dañar el rendimiento.
Menos determinista-A diferencia del entorno estrictamente controlado de Infiniband, las redes basadas en Ethernet pueden introducir la variabilidad en la latencia y la fluctuación de fase.
Complejo a escala– A medida que crecen los grupos, mantener una tela Ethernet sin pérdidas con un comportamiento consistente se vuelve cada vez más difícil.
Conclusión
En un clúster de GPU a gran escala, la alimentación de cómputo no tiene valor si la red no puede manejar la carga. El rendimiento de la red se vuelve tan vital como las GPU porque mantiene todo el sistema unido. Las tecnologías como RDMA y GPUDIRECT RDMA ayudan a eliminar las desaceleraciones habituales al deshacerse de las interrupciones innecesarias y la copia de la CPU, permitiendo que las GPU hablen directamente entre sí.
Tanto Infiniband como Rocev2 aceleran la comunicación de GPU a GPU, pero adoptan diferentes enfoques. Infiniband construye su propia configuración de red dedicada. Proporciona una excelente velocidad y baja latencia, pero a un costo muy alto. ROCEV2 proporciona más flexibilidad al usar la configuración de Ethernet existente. Es más fácil para el presupuesto, pero necesita un ajuste adecuado de PFC y ECN para que funcione.
Al final del día, es una compensación clásica. Vaya con Infiniband si su máxima prioridad es obtener el mejor rendimiento absoluto posible, y el presupuesto es menos preocupante. Pero si desea una solución más flexible que funcione con su equipo de red existente y cuesta menos por adelantado, ROCEV2 es el camino a seguir.