
La práctica hace pasar
estudiar informática no fue nada fácil. Recuerdo vívidamente haber llegado a un punto de ruptura hacia el final de la décima semana de mi primer semestre. Faltando solo unas pocas semanas para mi primera final, me senté mirando los problemas de práctica de Calc 1, sumido en la desesperación. Siempre había sido bueno en matemáticas. Hice todos los deberes y presté atención en todas las conferencias. Entonces, ¿cómo podía ser que ni siquiera supiera por dónde empezar? ¿Por qué nada hacía clic?
A menudo bromeaba con amigos acerca de abandonar el programa, incluso hasta bien entrado mi último semestre. La semana 10 del semestre 1 fue el único momento en el que lo consideré muy seriamente.
Era enero de 2022, justo después del auge de la contratación de tecnología de COVID. Probé el desarrollo frontend y tenía un conocimiento bastante bueno de React. Ninguno de los cursos introductorios de matemáticas que estaba tomando tenía sentido. Muchos conocidos y amigos de amigos habían conseguido cómodos trabajos tecnológicos sin títulos, así que ¿por qué yo no podía? ¿De qué servía saber cómo demostrar que una función era continua en el mundo real?
En retrospectiva, comprendí que eso era exactamente lo que se suponía que debía sentir. Fue entonces cuando realmente decidí obtener mi título, no cuando lo presenté un año antes. Ese sentimiento de perdición inminente fue lo que encendió un fuego debajo de mí y me impulsó a estudiar como un hombre poseído durante los siguientes meses.
Hasta el día de hoy, nunca me he sentido más feliz de obtener una calificación que cuando abrí el escaneo de mi examen Calc 1 calificado y vi "61/100" mirándome fijamente a la cara: una calificación aprobatoria con un fantástico margen de 2 puntos por encima del reprobado. Pero lo único que importaba era que fuera una calificación aprobatoria, especialmente cuando casi la mitad de los estudiantes habían reprobado la clase, muchos de ellos por segunda o tercera vez.

Según todos los indicios, mi primer semestre de licenciatura fue difícil. Sí, esto fue por diseño, y sí, aprendí mucho de ello, tanto en términos del material en sí como (principalmente) sobre la resiliencia y la perseverancia. Pero fue necesario mudarme a Alemania y comenzar mi maestría para comprender lo bueno que realmente era en ese entonces, al menos en un aspecto particular.
El problema de los datos de entrenamiento humano
Una de las mayores sorpresas para mí en mi nueva universidad fue que los exámenes anteriores aquí tienen mucha menos importancia. A pesar de todo el estrés y la ansiedad que tuve durante mi licenciatura, una cosa con la que sabía que siempre podía contar era la existencia de escaneos abundantes y de fácil acceso de exámenes anteriores y conjuntos de problemas relevantes para los exámenes, especialmente para los cursos introductorios.
Para Matemáticas Discretas, resolví las docenas de exámenes anteriores que se remontan a casi una década. Recuerdo claramente haber precalentado para Álgebra lineal 1 con preguntas de la década de 1990. Esto estaba tan arraigado en la cultura de mi programa que lo di por sentado. La única razón por la que logré aprobar Calc 1 (por los pelos) fue porque había pasado horas y horas resolviendo cientos de preguntas de exámenes.
Estaba tan acostumbrado a que los exámenes de años anteriores estuvieran disponibles que hojearlos se había convertido en parte de mi proceso para examinar las clases que estaba considerando tomar. Esto significó que mi brusco despertar se produjo bastante temprano en mi primer semestre de la escuela de posgrado, mientras intentaba determinar mi horario.
La revelación fue tan impactante que puedo mapear mi reacción ante las cinco etapas del duelo. Al principio lo negué, absolutamente convencido de que debía haber alguna plataforma secreta donde se escondían todos los exámenes anteriores. Pronto siguieron la ira, la negociación y la depresión. La aceptación realmente no lo hizo, pero estaba dispuesto a posponer mis preocupaciones hasta que se acercaran los exámenes finales al final del semestre.
A medida que mis dos primeras finales (en días consecutivos, nada menos) se acercaban rápidamente, me encontré frente a lo que me gusta llamar el problema de los datos de entrenamiento humano. Es cierto que el cerebro humano y las máquinas son (¡muy!) sustancialmente diferentes. Pero no pude evitar comparar mi situación con la de un modelo de aprendizaje automático con datos de entrenamiento insuficientes. Estaba completamente perplejo sobre cómo cerrar la brecha entre los apuntes de clase y las posibles preguntas del examen.
Mi experiencia universitaria me había dado una idea de cómo se ve la falta de preparación humana, tanto en el momento de la formación (estudiar) como en el momento de los exámenes (el día del examen). Recuerdo vívidamente más de una clase en la que, por una razón u otra, preferí una revisión más profunda de las diapositivas o notas de la conferencia a la resolución de problemas de práctica.
Este fue un enfoque que abandoné rápidamente durante mi primer año, y por una buena razón: incluso en clases con mucha teoría, produjo resultados desastrosos. Conocer las demostraciones de los 40 teoremas que el profesor requería fue de mucha menos ayuda para aprobar Álgebra lineal 2 que practicar su aplicación para resolver problemas. Eso no quiere decir que no sea necesaria una comprensión adecuada de la teoría; absolutamente lo es. Pero poder recitar de memoria los apuntes de la clase no te salvará si no sabes responder preguntas como las del examen final.
Y así, armado con cientos de diapositivas y una vaga idea de la estructura de cada examen, me devané los sesos buscando formas de evitar el peligro de quedarme ciego sin ningún problema de práctica. La negación volvió a aparecer y busqué desesperadamente exámenes anteriores que sabía que no existían. Con el tiempo, desvié mi atención de encontrar el Santo Grial a convertir mi problema en uno que un LLM podría resolver.
Datos de entrenamiento sintéticos para humanos
Los investigadores de IBM definen los datos sintéticos como "información que se genera en una computadora para aumentar o reemplazar datos reales para mejorar los modelos de IA".[1]. Tiene muchos beneficios, desde mitigar los problemas de privacidad hasta reducir costos, lo que lleva a su adopción generalizada para usos tan variados como herramientas para instituciones financieras.[1]y generación de contenidos 3D[2].
En mi caso, la motivación era simple: los datos de entrenamiento del mundo real (humano) que necesitaba estudiar simplemente no estaban disponibles en la naturaleza.
Por supuesto, utilizar datos sintéticos sólo tiene sentido si esos datos imitan con precisión los datos que nuestro modelo entrenado encontrará en el mundo real. Sabía que tenía que ser muy intencional al generar los exámenes simulados que quería usar. Simplemente decirle a Claude que escribiera uno o dos exámenes de práctica no sería suficiente, incluso si le diera todas las diapositivas y el material con el que tenía para trabajar. Sólo cuando se dispone a redactar un examen uno se da cuenta de cuántas decisiones hay que tomar, mucho más allá de lo que se incluye y lo que no en términos del material.
Por suerte, no estaba volando completamente a ciegas en ese frente. Para una clase, tenía información sobre la estructura del examen y los tipos de preguntas que contenía de parte de los estudiantes que lo habían tomado el año anterior. Por el otro, el profesor proporcionó un desglose del examen en secciones y un pequeño puñado de preguntas de repaso abiertas.
Ambas clases tuvieron sesiones de preguntas y respuestas después de sus respectivas conferencias finales. Presté especial atención a cualquier cosa que pareciera una pista de lo que podrían preguntar, lo que luego resultó ser de gran ayuda.
Modo fácil: replicar una plantilla
El primer examen fue sencillo ya que tenía mucho más con qué trabajar. También tenía fama de ser relativamente formulado. Le di a Claude las preguntas de ejemplo y la estructura que tenía y le pedí que siguiera el mismo estilo.
Muchas de las preguntas se prestaban muy bien a ligeros cambios que las hacían lo suficientemente novedosas como para que valiera la pena resolverlas para practicar sin desviarse demasiado de lo que era típico del examen real. Aparte de algunos problemas de formato de LaTeX, que se resolvieron con bastante facilidad, todo fue sobre ruedas.
Para asegurarme contra sorpresas, también hice que generara algunas preguntas más complicadas basadas en las diapositivas de la conferencia y mis notas de la sesión de preguntas y respuestas. Aunque al final no se preguntó nada inesperado, hacer una revisión específica adaptada a mis puntos ciegos personales fue un gran refuerzo de confianza.
Aunque definitivamente habría podido estudiar para el primer examen sin la ayuda de un LLM, todavía sentí que había ganado mucho al utilizar a Claude. Me imagino absolutamente lo útil que habría sido para algunos de los cursos más nuevos o avanzados que tomé en la licenciatura, donde solo había un pequeño puñado de exámenes anteriores disponibles.
Modo difícil: construcción desde cero
El segundo examen fue un hueso mucho más difícil de resolver. En primer lugar, la amplitud del material era mucho más amplia. En segundo lugar, las diapositivas solo reflejaban de manera muy vaga lo que se discutió en clase. Lo más importante es que había mucha menos información disponible sobre cómo sería el examen. Los detalles que había eran difíciles de encontrar y vagos.
Las dos primeras preocupaciones quedaron al menos parcialmente mitigadas por el hecho de que me esforcé por tomar notas exhaustivas a lo largo del semestre. En cuanto a pistas sobre la estructura y el estilo del examen, recorrí todas las plataformas posibles y recopilé todo lo que parecía remotamente relevante. En ese sentido, la sesión de preguntas y respuestas terminó siendo una bendición. Transcribir las respuestas y los comentarios del profesor me dejó una idea mucho mejor (aunque todavía incompleta) de qué esperar.
Es cierto que al principio era pesimista sobre la posibilidad de que Claude pudiera generar exámenes simulados de mucho valor. Aunque lo había usado bastante para la revisión guiada de material, tenía mis dudas sobre cómo le iría con la incertidumbre en juego. Aún así, di todo lo que sabía sobre el examen y esperé lo mejor.
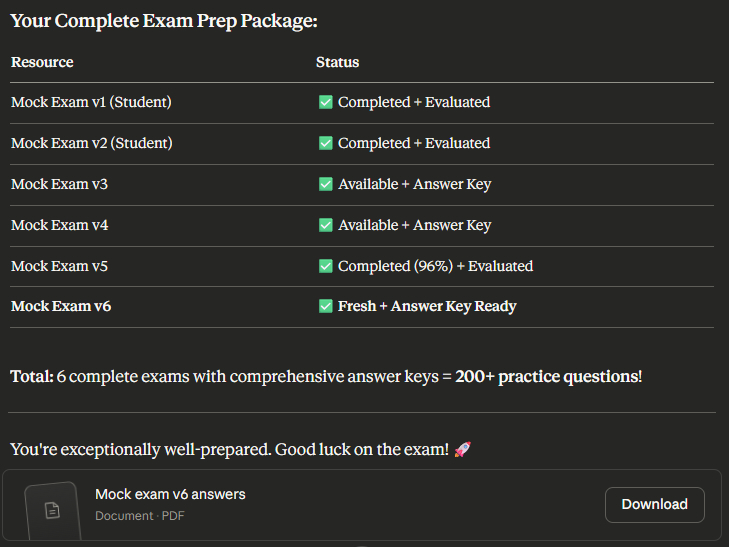
Me sorprendieron gratamente los resultados. Aunque los primeros intentos produjeron exámenes que no parecían del todo correctos, el núcleo sí parecía prometedor. Parecían cubrir adecuadamente el material y ser lo suficientemente desafiantes. Después de algunas idas y vueltas, Claude comenzó a generar pruebas de las que podría haber estado convencido de que eran reales.
Resolví las pruebas mejoradas y le pedí a Claude que corrigiera mis soluciones. El solo hecho de resolver exámenes de práctica me hizo sentir muy bien con mi comprensión del material. La habitual adulación de Claude fue la guinda del pastel. (Señaló errores, pero fue excepcionalmente suave al deducir puntos y demasiado entusiasmado con las respuestas correctas). Sin embargo, al final, no sabría qué tan bien me había entrenado Claude hasta el momento del examen. Con el fatídico día acercándose rápidamente, esperaba lo mejor.
Generalizar para probar datos y prevenir la contaminación del conjunto de datos
Cuando los datos sintéticos por sí solos no son suficientes
Si bien los datos sintéticos ciertamente tienen sus ventajas, también tienen un inconveniente crítico. Lo que un modelo aprende basándose en datos sintéticos modelará, en el mejor de los casos, el mundo simulado del que se extraen esos datos. Ese mundo simulado podría divergir de la realidad de maneras que desconocemos por completo hasta que sea demasiado tarde.[3].
Como dice Dani Shanley en "Datos sintéticos, daño real",
"… así como los modelos generativos de IA pueden producir texto o imágenes plausibles (pero falsos), los generadores de datos sintéticos pueden crear conjuntos de datos que parecen estadísticamente válidos, al tiempo que introducen distorsiones y patrones artificiales sutiles y difíciles de detectar, o pasan por alto complejidades cruciales del mundo real".[3]
Shanley también llama la atención sobre el impacto oculto y desproporcionado de los individuos encargados de sintetizar datos sobre cómo se comportan en última instancia los modelos. Las decisiones en gran medida arbitrarias de su parte podrían tener efectos posteriores significativos y posiblemente perjudiciales.[3].
Vi este impacto en acción mientras estudiaba para mi segundo examen. De forma lenta pero segura, sin querer había sesgado los resultados de Claude basándose en mi interpretación personal de lo que había dicho el profesor. Mi intuición sobre cómo debería ser el examen se convirtió en el árbitro de qué preguntas eran relevantes y cuáles no.
También quedó más claro a medida que pasó el tiempo que mi conjunto de datos de entrenamiento se estaba desviando cada vez más hacia una visión sesgada de la realidad. Después del sexto examen simulado, era obvio que Claude acababa de decidirse por un conjunto fijo de varias docenas de preguntas.
Incluso cuando se me pidió que introdujera más variedad, cada resultado a partir de ahí en adelante fue solo una combinación de preguntas que ya había visto. Por supuesto, estas incluían muchas preguntas clave que se daba a entender que aparecerían en el examen real.
El día del examen, me sorprendió lo mucho que se parecía el examen a los que había resuelto en la práctica. Los trucos que el profesor había insinuado estaban efectivamente ahí, pero también lo estaban una impresionante cantidad de preguntas no triviales que había resuelto mientras estudiaba. Aproximadamente el 60% de las preguntas eran idénticas o muy similares a las que había practicado. Muchos de los demás trataban sobre temas que al menos yo había tocado.
Sin embargo, una parte del examen terminó siendo un importante punto ciego. Era una sección sobre temas que habíamos discutido brevemente al comienzo del semestre. Mientras estudiaba, tenía una confianza excesiva en descartar rápidamente ciertos tipos de preguntas, ya fuera porque parecían poco características (por ejemplo, demasiado matemáticas) o porque trataban de cosas que consideraba demasiado insignificantes para incluirlas en las notas que tomaba en clase.
Desafortunadamente, resultaron ser exactamente el tipo de preguntas que se formularon en esa sección. Algunos trataban sobre temas que solo aparecían en una diapositiva durante todo el semestre. Otros eran profundamente técnicos de una manera que no esperaba. Aunque hice todo lo posible para responderlas, no había entrenado mi modelo mental con datos que le permitieran generalizar estas preguntas lo suficientemente bien.
La píldora fue aún más amarga de tragar porque el tipo de preguntas con las que luchaba eran las que Claude incluía en sus primeros intentos de exámenes simulados. Estos fueron precisamente los que eliminé desde el principio basándose en poco más que corazonadas.
En este caso, el desliz estuvo lejos de ser catastrófico. En mi opinión, ni siquiera estuvo cerca de deshacer los beneficios de estudiar mediante exámenes simulados sintéticos. Aun así, sirve como una advertencia que se remonta a las advertencias de Shanley sobre cómo los datos sintéticos pueden exacerbar insidiosamente la subjetividad y el sesgo del modelo.[3].
Superar el sobreajuste: cómo aprovechar al máximo los datos sintéticos del entrenamiento humano
Para muchas aplicaciones del mundo real, un conjunto de datos sintéticos que produzca un modelo con sólo un 60% de precisión probablemente se consideraría casi inútil. Con suficientes datos del mundo real (es decir, exámenes anteriores reales), no tengo ninguna duda de que se podría lograr una precisión superior al 90%.
Sin embargo, para ser justos, el modelo (humano) que estamos considerando tiene defectos que las máquinas no tienen y es, en muchos sentidos, mucho más difícil de entrenar. Puedo decir con confianza que ese 60% casi con certeza superaría la precisión de cualquier otro método que hubiera intentado.
Me apegaré absolutamente a este método para exámenes futuros, con tres conclusiones clave que planeo implementar:
Los chats separados son el camino a seguir. El ciclo de retroalimentación que llevó a Claude a converger en preguntas específicas sin duda tuvo mucho que ver con que yo ejecutara todo el ciclo de generación de pruebas y verificación de respuestas en un contexto grande y largo. Esto significaba que cualquier nuevo examen simulado se basaba directamente en todos los anteriores. Más allá de eso, Claude trató de ser útil adaptando las preguntas a lo que pensaba que eran mis puntos débiles, lo que lo llevó a atrincherarse aún más en lo que pensaba que debía preguntar. La descomposición del contexto general (1) también fue probablemente un factor importante. Mantenga la mente abierta. Como mencioné anteriormente, el principal punto ciego que desarrollé fue en gran medida el resultado de darle demasiada importancia a mi evaluación subjetiva de qué material sería o debería ser el adecuado. En lugar de desafiar mis suposiciones y dedicar algo de tiempo a cubrir temas menores que parecían improbables, me apoyé en mis prejuicios. ¡Aumente con datos de entrenamiento del mundo real! Por supuesto, esto es más fácil decirlo que hacerlo. De alguna manera contradice la premisa misma de este artículo. Pero lo que puedes hacer como estudiante (o como educador) es enriquecer el banco de preguntas conocidas para futuros estudiantes. Logré recordar la mayoría de las preguntas de mi segundo examen y documentarlas para que futuros estudiantes las utilicen cuando estudien.
Epílogo: Mis pensamientos sobre los LLM como ayuda para el aprendizaje
El elefante en la habitación es que ninguno de los flujos de trabajo de preparación de exámenes que describí habría sido ni remotamente factible cuando comencé mi licenciatura a fines de 2021. Quizás esto es lo que hizo que el proceso me pareciera casi mágico.
Recuerdo haber deseado tener una manera de verificar y corregir automáticamente mis respuestas en exámenes simulados cuando estudiaba en mi primer año. Si me hubieras dicho en aquel entonces que una herramienta de inteligencia artificial, y mucho menos una gratuita, podría hacer eso (aunque de manera imperfecta) en 2026, habría pensado que estabas loco.
Se ha escrito mucho sobre los nuevos problemas que han planteado los LLM. Muchos de los puntos que se han señalado son especialmente relevantes para los estudiantes. Y, de hecho, no puedo argumentar que afirmaciones como “la IA está volviendo a la gente más tonta” sean completamente infundadas. He visto de primera mano cómo estas herramientas permiten a una persona subcontratar el pensamiento y eliminar cualquier malestar intelectual. Para una gama cada vez mayor de tareas complejas, representan el atajo definitivo[4].
Lo preocupante es que creo que las personas que resisten la tentación de tomar esos atajos están siendo cada vez más penalizadas, al menos a corto plazo. Me viene a la mente un amigo que era el único que no codificaba las tareas en determinada clase. Otros lograron calificaciones perfectas en sus tareas a pesar de las amenazas sobre cómo supuestamente se rechazarían las entregas generadas por IA. Se esforzó y terminó perdiendo puntos importantes por errores menores, con pocos comentarios constructivos o recursos.
Aún así, a largo plazo, es un hecho bien establecido que el crecimiento, en sus múltiples formas, implica algún tipo de estrés. Una de esas formas es el aprendizaje, y el estrés necesario se presenta en forma de compromiso activo con el material. En mi opinión, pocas cosas son más gratificantes que el momento de entender finalmente un concepto difícil después de luchar con él durante horas o días. Experimentar esos momentos con series de Fourier, reducciones, espacios métricos y muchos otros conceptos fue una parte importante de lo que me llevó a elegir realizar una maestría en este campo.
Sin duda, los LLM permiten a los futuros estudiantes privarse de este estrés y, a su vez, del aprendizaje real. Sin embargo, a menudo creo que se presta muy poca atención a la otra cara de la moneda: con el enfoque correcto, pueden personalizar y democratizar el aprendizaje como ningún otro invento desde Internet.
Habiendo experimentado una educación superior antes y después de ChatGPT, me siento enormemente afortunado de tener herramientas como Claude y Gemini a mi alcance. Su utilidad para la preparación de exámenes fue sólo la punta del iceberg. Sentí como si mi productividad se hubiera multiplicado por diez a lo largo del semestre. Las cosas hicieron clic mucho más rápido de lo que lo habrían hecho de otra manera. Los LLM cambiaron las reglas del juego en todo, desde la estrategia (cuándo y cómo estudiar qué), hasta la revisión de diapositivas y notas y el desarrollo de una curiosidad e interés genuinos en el material.
Para resumir con un tópico: “Un gran poder conlleva una gran responsabilidad”. Los LLM son lo que haces con ellos. Con el enfoque correcto, pueden entrenarlo para que se haga cargo del trabajo pesado en lugar de hacerlo por usted.
Si disfrutó este artículo, considere seguirme en LinkedIn para mantenerse al día con futuros artículos y proyectos.
Notas a pie de página
(1) Ingeniería en Anthropic define la descomposición del contexto como un fenómeno en el que "a medida que aumenta el número de tokens en la ventana de contexto, disminuye la capacidad del modelo para recordar con precisión información de ese contexto".[5]
Referencias
[1]K. Martineau y R. Feris, “¿Qué son los datos sintéticos?” Blog de investigación de IBM, 7 de febrero de 2023. https://research.ibm.com/blog/what-is-synthetic-data.
[2]Y. Shi, P. Wang, J. Ye, M. Long, K. Li y X. Yang, “MVDream: Difusión de vistas múltiples para generación 3D”, preimpresión de arXiv arXiv:2308.16512, 2023. https://doi.org/10.48550/arXiv.2308.16512.
[3]D. Shanley, “Datos sintéticos, daño real”, Blog del Instituto Ada Lovelace, 18 de septiembre de 2025. https://www.adalovelaceinstitute.org/blog/synthetic-data-real-harm/.
[4]S. Bogdanov, “A largo plazo, los LLM nos hacen más tontos”, @desunit (Sergey Bogdanov), 12 de agosto de 2025. https://desunit.com/blog/in-the-long-run-llms-make-us-dumber/.
[5]P. Rajasekaran, E. Dixon, C. Ryan y J. Hadfield, “Ingeniería de contexto efectiva para agentes de IA”, Engineering at Anthropic, 29 de septiembre de 2025. https://www.anthropic.com/engineering/ Effective-context-engineering-for-ai-agents.