
una empresa de gran tamaño, un clúster de Kubernetes para realizar inferencias en tiempo real sobre su producto LLM de cara al cliente. Comenzamos con 64 GPU H100 SXM en 8 nodos, todas ejecutando vLLM en modo monolítico. Los resultados no estuvieron donde necesitamos que estén. Durante las ráfagas de precarga, los núcleos tensoriales alcanzaron una utilización del 92%. Diez milisegundos después, durante la decodificación, las mismas GPU cayeron al 28%. Estábamos pagando por 64 H100 y obteniendo un trabajo significativo de quizás 20 de ellos durante el 90% de la vida útil de cada solicitud. El equipo de finanzas quería saber por qué el proyecto de ley de GPU parecía que estábamos entrenando un modelo básico cuando solo estábamos sirviendo uno.
Un modelo Llama 70B que ejecuta inferencia en una GPU H100 alcanza una utilización informática del 92 % durante el precarga. Treinta milisegundos después, durante la decodificación, esa misma GPU cae al 30%. El hardware no ha cambiado. Los pesos del modelo son idénticos. La intensidad aritmética de la carga de trabajo se redujo cinco veces entre una fase y la siguiente.
Esa falta de coincidencia se encuentra debajo de cada problema de costo de inferencia, y la mayoría de las arquitecturas de servicio fingen que no existe.
Cada vez que un modelo de lenguaje grande procesa una solicitud, hace dos cosas diferentes. Primero, lee todo el mensaje en paralelo, llenando un caché de valores-clave con el estado de atención de cada token de entrada. Esa es la fase previa al llenado. Luego genera tokens de salida uno a la vez, leyendo de ese caché en cada paso. Eso es decodificar. El prellenado es un problema de multiplicación de matrices. La decodificación es un problema de ancho de banda de la memoria. Tienen requisitos de hardware opuestos y la práctica estándar es ejecutar ambos en el mismo grupo de GPU.
Esa práctica estándar es costosa. La GPU que tiene el tamaño perfecto para su ráfaga de precarga está enormemente sobreaprovisionada para la decodificación. La GPU que es rentable para la decodificación no puede seguir el ritmo del precarga. Pagas por el peor de los casos en ambas direcciones.
La inferencia desagregada divide estas dos fases en grupos de hardware separados, cada uno dimensionado para lo que realmente hace. La idea surgió en un artículo de OSDI de 2024 llamado DistServe, del Hao AI Lab de UC San Diego. Dieciocho meses después, Perplexity lo pone en producción. Meta, LinkedIn y Mistral sirven tráfico a través de él. NVIDIA construyó un marco completo (Dynamo) a su alrededor. vLLM, SGLang y TensorRT-LLM lo admiten de forma nativa.
Así es como funciona, dónde están las compensaciones y cuándo no deberías molestarte.
Las dos fases de la inferencia no suponen la misma carga de trabajo.
Si ha realizado inferencias en cualquier modelo de transformador, ya ha encontrado ambas fases. Pero la mayoría de los paneles de control los reducen a una única métrica de “inferencia”, lo que oculta el problema.
Prefill procesa todos los tokens de entrada simultáneamente. Para un mensaje de 4096 tokens, el cálculo de la atención implica grandes multiplicaciones de matrices en toda la longitud de la secuencia. Este es un trabajo vinculado a la computación. Los núcleos tensoriales de la GPU son el cuello de botella. En un H100 SXM, el prellenado logra entre 200 y 400 operaciones aritméticas por byte de memoria al que se accede. La utilización se sitúa entre el 90% y el 95%. El ancho de banda de la memoria, de 3,35 TB/s, apenas se ve afectado.
Decode genera un token a la vez. Cada paso lee todo el caché KV de HBM para calcular una única salida de atención. Los núcleos tensoriales terminan en microsegundos y luego esperan la siguiente lectura de memoria. La intensidad aritmética cae a 60-80 operaciones/byte. La utilización de la GPU cae al 20-40%. Los núcleos tensoriales permanecen inactivos mientras el bus de memoria se satura.
Estas no son estimaciones aproximadas. El análisis técnico de InfoQ de septiembre de 2025 midió el precarga con una utilización del 90 % al 95 % y la decodificación entre el 20 % y el 40 %, con una eficiencia energética entre 3 y 4 veces mayor por operación durante el precarga. El artículo SPAD de UT Austin simuló un H100 y descubrió que reducir el ancho de banda de la memoria en un 40 % solo aumentaba la latencia de precarga en un 17 %, porque la precarga no usa el ancho de banda. Reducir la capacidad de procesamiento en un 50 % solo aumentó la latencia de decodificación en un 22 %, porque la decodificación no utiliza el procesamiento.
Dos cargas de trabajo. Cuellos de botella opuestos. Misma GPU.
[Fuente: Autor (SVG creado con Inkscape)]
Lo que realmente le cuesta el servicio monolítico
En una implementación estándar de vLLM o TensorRT-LLM, un único grupo de GPU maneja ambas fases. El programador intercala solicitudes de precarga y decodificación dentro del mismo lote.
El problema inmediato es la interferencia. Cuando una nueva solicitud de precarga ingresa al lote, las solicitudes de decodificación activas tienen que esperar. El precompletar requiere muchos cálculos y lleva más tiempo por paso. Esas solicitudes de decodificación, que deberían devolver tokens a una cadencia constante, experimentan un pico de latencia. Esta es la fluctuación de la latencia entre tokens (ITL) con la que obsesionan los sistemas de producción. Un usuario que observa una respuesta en streaming ve que el texto se detiene a mitad de la frase mientras la GPU procesa el mensaje de otra persona.
El problema que se quema más lentamente son los residuos de utilización. La GPU está aprovisionada para manejar los picos de precarga, por lo que está sobreaprovisionada para la fase de decodificación que domina el ciclo de vida de la solicitud. Una generación típica produce entre 200 y 500 tokens de salida. Cada paso de decodificación tarda entre 10 y 30 ms. Una respuesta de 300 tokens tarda aproximadamente entre 3 y 9 segundos en decodificarse y tal vez 200 ms en precompletar. La GPU ejecuta la decodificación durante más del 90 % del tiempo del reloj de pared y, durante ese 90 %, utiliza el 30 % de su capacidad informática. Está pagando por un H100 y obteniendo una utilización del nivel H100 durante una décima parte de la duración de la solicitud.

[Fuente: Autor (SVG creado con Inkscape)]
La comunidad vLLM abordó parte de esto con un precarga fragmentado, que divide un precarga largo en partes más pequeñas y las intercala con pasos de decodificación. Esto suaviza los peores picos de ITL, pero no resuelve el desajuste de utilización. La GPU todavía realiza ambas tareas.
Dividiendo el camino de inferencia en dos
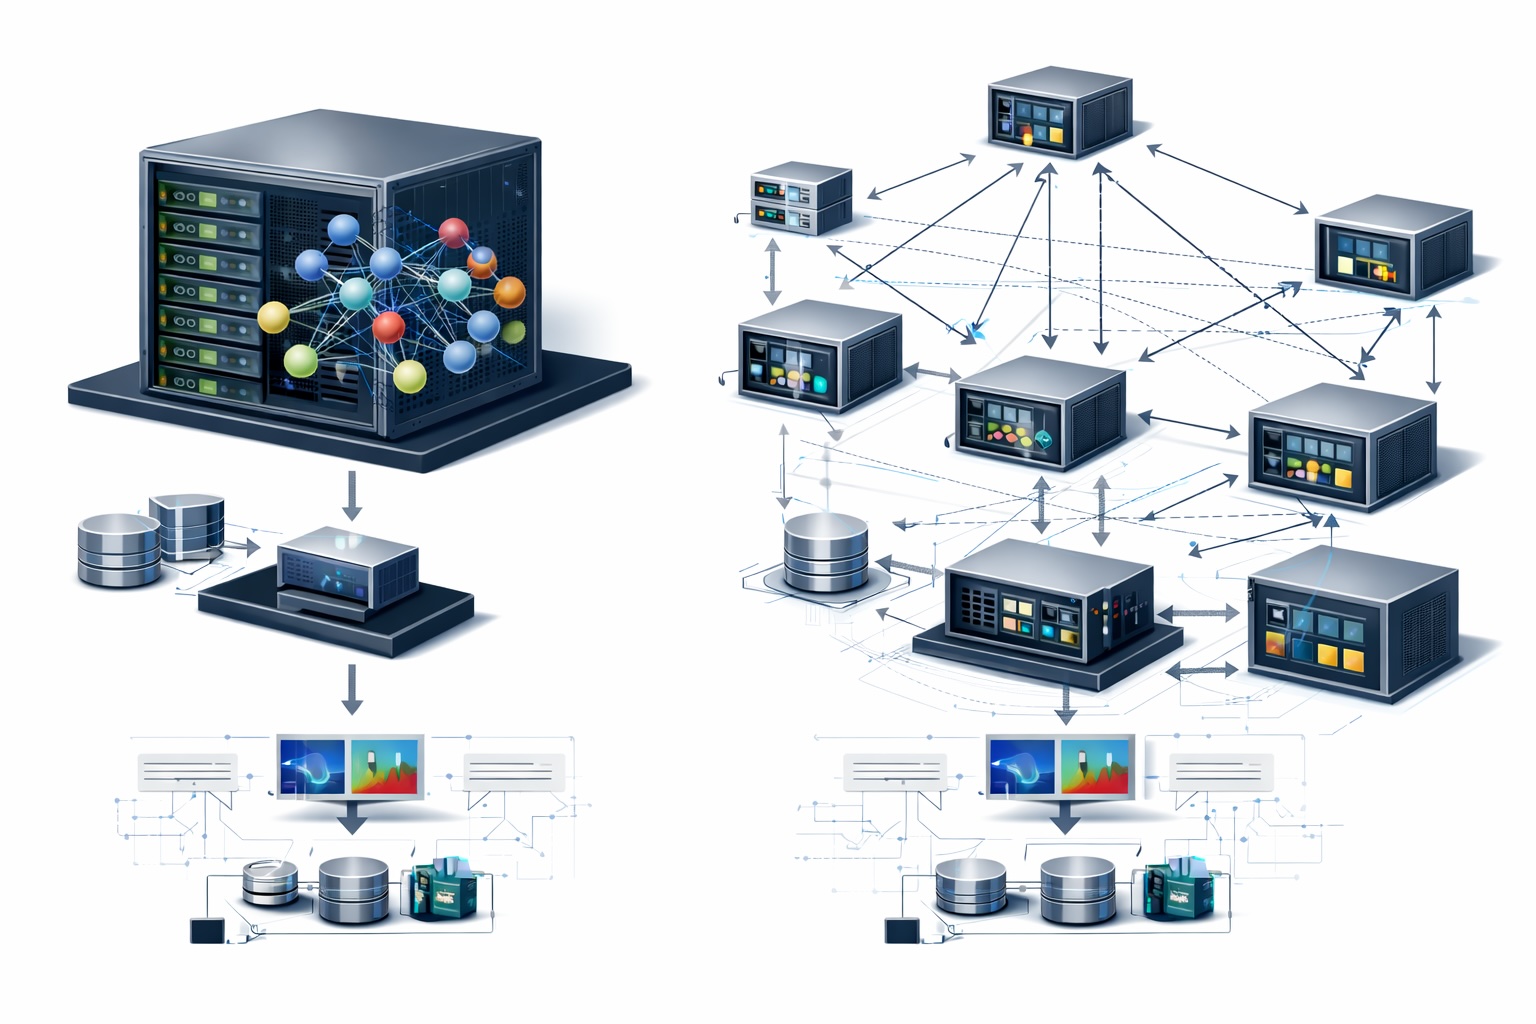
La inferencia desagregada ejecuta el precompletado y la decodificación en grupos de GPU separados conectados por una red rápida. Llega una solicitud, se enruta a un trabajador de prellenado, que procesa el mensaje completo y genera el caché KV. Luego, ese caché se transfiere a través de la red a un trabajador de decodificación, que maneja la generación del token autorregresivo.
Tres piezas lo hacen funcionar.
1. Un enrutador compatible con KV se encuentra frente a ambos grupos. Asigna solicitudes entrantes a los trabajadores de precarga disponibles y, una vez que se completa el precarga, enruta el caché KV a un trabajador de decodificación con capacidad disponible. El enrutador rastrea qué trabajadores decodificadores contienen qué cachés KV, lo que permite funciones como el almacenamiento en caché de prefijos en solicitudes que comparten prefijos de mensajes comunes (mensajes del sistema, ejemplos de pocas tomas, descripciones de herramientas).
2. Un grupo de precarga contiene GPU optimizadas para la multiplicación de matrices de alto rendimiento. Estos trabajadores procesan indicaciones, crean cachés KV y las entregan. No generan tokens de salida. Debido a que el precarga está vinculado a la computación, estas GPU pueden utilizar menos ancho de banda de HBM sin penalización.
3. Un grupo de decodificación contiene GPU optimizadas para el ancho de banda de la memoria. Estos trabajadores reciben cachés KV y generan tokens de forma autorregresiva. Debido a que la decodificación depende de la memoria, estas GPU pueden utilizar menos procesamiento sin penalizaciones. Con lotes de gran tamaño (cientos de solicitudes de decodificación simultáneas), la utilización de la decodificación aumenta porque las lecturas de memoria se amortizan a través de más trabajo.
[Fuente: Autor (SVG creado con Inkscape)]
Los dos grupos escalan de forma independiente. Si su carga de trabajo tiene muchas solicitudes (solicitudes largas del sistema, flujos de trabajo agentes con descripciones de herramientas), agregue trabajadores de precompletar. Si atiende a muchos usuarios simultáneos que generan respuestas largas, agregue trabajadores decodificadores. Este desacoplamiento es el principal beneficio económico: deja de pagar por la capacidad informática durante la decodificación y deja de pagar por el ancho de banda de la memoria durante el llenado previo.
El impuesto que usted paga: mover el caché KV
La desagregación no es gratuita. El caché KV producido durante el prellenado tiene que pasar de la GPU precargada a la GPU de decodificación a través de la red, y estos cachés no son pequeños.
Para un modelo de parámetros de 70B que utiliza atención de consultas agrupadas con 80 capas, 8 cabezales KV por capa, 128 dimensiones por cabezal, almacenados en FP16: el estado KV de cada token es 327,680 bytes. Un mensaje de 4.096 tokens produce 1,34 GB de caché KV. Todo ese bloque tiene que transferirse antes de que el trabajador de decodificación pueda comenzar a generar.
Este es el cálculo que puede ejecutar para cualquier modelo:
# Cálculo del tamaño de caché KV para cualquier modelo de transformador def kv_cache_bytes(n_layers, n_kv_heads, head_dim, seq_len, dtype_bytes=2): """Devuelve el tamaño de caché KV en bytes para una sola solicitud.""" per_token = n_layers * n_kv_heads * head_dim * 2 * dtype_bytes # 2 para K y V return per_token * seq_len # Llama 70B con caché GQA = kv_cache_bytes(n_layers=80, n_kv_heads=8, head_dim=128, seq_len=4096) print(f"Por token: {80 * 8 * 128 * 2 * 2:,} bytes") print(f"Caché completo: {cache / 1e9:.2f} GB") # 1,34 GB # Llama 8B (modelo más pequeño, mismo ejercicio) cache_8b = kv_cache_bytes(n_layers=32, n_kv_heads=8, head_dim=128, seq_len=4096) print(f"Llama 8B cache: {cache_8b / 1e9:.2f} GB") # 0,54GB
[Fuente: Autor (SVG creado con Inkscape)]
A 100 Gbps (un enlace RDMA estándar con NIC EFA o ConnectX), 1,34 GB tarda aproximadamente 107 milisegundos. A 400 Gbps, se necesitan 27 ms. Estos números son importantes porque establecen el tiempo mínimo para el primer token: el trabajador de decodificación no puede comenzar hasta que llegue el caché.
El equipo de ingeniería de Perplexity construyó su pila de servicios desagregados sobre libfabric y RDMA, utilizando cuMem para compartir memoria de GPU entre procesos. Sus coordenadas de mensajero KV se transfieren capa por capa, por lo que el trabajador de decodificación puede comenzar a procesar las primeras capas mientras las capas posteriores todavía están en tránsito. Esta canalización reduce la latencia de transferencia efectiva por debajo del cálculo del ancho de banda sin procesar.
La pregunta es si estos gastos generales de transferencia valen la pena. En un sistema monolítico, no hay transferencia KV, pero sí hay retrasos en la cola. Cuando llega una nueva ráfaga de precarga, las solicitudes de decodificación activa se detienen. Las mediciones del artículo de DistServe muestran mejoras de latencia de P99 de 2 veces o más con desagregación, porque al eliminar la interferencia de decodificación previa al llenado se eliminan los picos de latencia de cola que causan las colas. El costo de transferencia de 27 ms reemplaza entre 200 y 500 ms de demora en la cola.
Sin embargo, hay un punto de cruce. Para mensajes breves con altas tasas de aciertos de caché de prefijo, el llenado previo local en el trabajador de decodificación puede ser más rápido que transferir el caché a través de la red. El manual de inferencia de BentoML informa una degradación del rendimiento del 20 al 30 % cuando se aplica la desagregación a cargas de trabajo que en realidad no la necesitan. Esta no es una arquitectura que se aplica a ciegas.
Cómo se ve la pila de producción hoy
Dieciocho meses después de DistServe, la inferencia desagregada pasó de ser un prototipo de investigación a la arquitectura de servicio predeterminada en múltiples empresas que ejecutan LLM a escala.
[Fuente: Autor (SVG creado con Inkscape)]
Dynamo de NVIDIA, anunciado en GTC 2025, es una capa de orquestación a escala de centro de datos que trata a los trabajadores de precarga y decodificación como entidades de primera clase. Admite vLLM, SGLang y TensorRT-LLM como backends de inferencia e incluye un enrutador compatible con KV que maneja la ubicación de la caché y la programación de solicitudes entre grupos.
En el lado nativo de Kubernetes, llm-d (un proyecto de código abierto de Red Hat e IBM Research) implementa servicios desagregados como un conjunto de recursos personalizados de Kubernetes. Los grupos de precarga y decodificación son implementaciones independientes que se escalan automáticamente de forma independiente según la profundidad de la cola y la utilización de la GPU. El enrutamiento de caché KV se maneja a través de una puerta de enlace que rastrea las ubicaciones de caché. Para los equipos que ya ejecutan inferencia en EKS, GKE u OpenShift, esto se asigna claramente a los flujos de trabajo de administración de clústeres existentes.
Si usa vLLM directamente, una configuración mínima desagregada se ve así:
# Inicie la instancia de precarga python -m vllm.entrypoints.openai.api_server –model meta-llama/Llama-3.1-70B-Instruct –tensor-parallel-size 4 –kv-transfer-config '{ "kv_connector": "PyNcclConnector", "kv_role": "kv_producer", "kv_parallel_size": 2 }' # Iniciar la instancia de decodificación (nodo separado o conjunto de GPU) python -m vllm.entrypoints.openai.api_server –model meta-llama/Llama-3.1-70B-Instruct –tensor-parallel-size 4 –kv-transfer-config '{ "kv_connector": "PyNcclConnector", "kv_role": "kv_consumer", "kv_parallel_size": 2 }'
El kv_connector especifica el protocolo de transferencia (NCCL en este caso, RDMA a través de MooncakeConnector para un mayor rendimiento). kv_role le dice a cada instancia si produce o consume cachés KV. vLLM maneja el enrutamiento y la transferencia de caché entre los dos.
SGLang probó DeepSeek-R1 con servicio desagregado en 96 GPU H100: 3 nodos (24 GPU) para precarga, 9 nodos (72 GPU) para decodificación. Midieron 52.300 tokens de entrada/segundo y 22.300 tokens de salida/segundo por nodo. Un seguimiento del GB200 NVL72 mostró ganancias de rendimiento de precarga de 3,8 veces y decodificación de 4,8 veces en comparación con la misma carga de trabajo en H100.
La implementación de vLLM (llm-d 0.3, octubre de 2025) alcanzó 2200 tokens/segundo por GPU H200 con paralelismo experto de 32 vías. El sistema de producción de Perplexity utiliza transferencia KV basada en RDMA con transmisión canalizada por capas, lo que admite decodificación especulativa y generación de salida estructurada a través del límite de decodificación previa al llenado.
Cuando la desagregación empeora las cosas
No todas las cargas de trabajo se benefician. El manual de inferencia de BentoML informa una degradación del rendimiento del 20 al 30 % cuando se aplica la desagregación a cargas de trabajo que no la necesitan, y ese es un número real medido en hardware real.
Las indicaciones breves son las que más duelen. Si su solicitud mediana es inferior a 512 tokens y la duración de la generación se mantiene por debajo de 100 tokens, la sobrecarga de transferencia KV consume cualquier ahorro de latencia que obtendría de la separación de fases. El precompletado local en el trabajador de decodificación tarda unos milisegundos en recibir un mensaje breve. Enviar el caché a través de RDMA lleva más tiempo que simplemente volver a calcularlo. Para los chatbots que manejan preguntas y respuestas rápidas, la publicación monolítica es más simple y rápida.
La reutilización de la caché de prefijos también cambia la ecuación. Las conversaciones de varios turnos y los flujos de trabajo agentes tienden a compartir grandes mensajes del sistema entre solicitudes. Si más del 80% del caché KV ya reside en el trabajador de decodificación de un turno anterior, el prellenado incremental es pequeño. Enviar un caché nuevo desde un trabajador de precarga separado desperdicia ancho de banda de la red en datos que ya son locales.
La escala importa. Un solo nodo con 2 a 4 GPU no genera suficientes solicitudes simultáneas para mantener ocupados dos grupos separados. Los gastos generales de programación por sí solos pueden acumular un rendimiento de ese tamaño. La desagregación comienza a dar sus frutos cuando tienes docenas de GPU y suficiente tráfico para mantener ambos grupos saturados.
Y luego está la red. Sin RDMA o enlaces de al menos 100 Gbps, la transferencia KV se convierte en el nuevo cuello de botella. TCP funciona pero agrega latencia. Perplexity construyó toda su pila en RDMA con libfabric por una razón.
El Hao AI Lab lo expresó sin rodeos en su retrospectiva de noviembre de 2025: "el precarga desagregado no mejora el rendimiento". Las ganancias son el control de la latencia y la rentabilidad a través de una mejor utilización. Si cumple con los objetivos de latencia con servicio monolítico, agregar un salto de transferencia KV entre fases solo le brinda más partes móviles para depurar a las 2 a.m.
La aritmética de costos
El argumento económico a favor de la desagregación se basa en una observación: se puede utilizar hardware más barato para cada fase cuando están separadas.
Los trabajadores de precarga necesitan FLOPS altos, pero no necesitan una capacidad masiva de HBM. Un H100 SXM con 80 GB HBM es muy adecuado. Un H200 con 141 GB HBM es excesivo para precarga; estás pagando por el ancho de banda de la memoria que no usarás.
Los trabajadores de decodificación necesitan un gran ancho de banda de memoria y un gran HBM para almacenar cachés KV para muchas solicitudes simultáneas, pero no necesitan FLOPS máximos. Un H200, con su mayor capacidad HBM3e y mayor ancho de banda, es en realidad más adecuado para decodificar que un H100. La memoria adicional le permite agrupar más solicitudes de decodificación, amortizando las lecturas de memoria y aumentando la utilización.
El artículo de SPAD lleva esta lógica al extremo: proponen diseños de GPU de “dimensión adecuada” en chips de precarga y decodificación separados. Su simulación muestra que un chip precargado con un 40% menos de ancho de banda de memoria que un H100 solo pierde el 17% del rendimiento precargado. Un chip decodificador con un 50 % menos de cálculo solo pierde un 22 % de rendimiento de decodificación. Los ahorros de costes derivados de la eliminación del silicio no utilizado en cada chip son sustanciales.
A nivel de clúster, el análisis de InfoQ informa una reducción total de los costos de infraestructura de entre el 15% y el 40% a partir de la desagregación. Los ahorros provienen de no aprovisionar demasiado el hardware, de eliminar los núcleos tensoriales inactivos durante la decodificación y de poder agregar trabajadores de decodificación sin comprar capacidad de precarga que no necesita.
Meta, LinkedIn, Mistral y HuggingFace ejecutan vLLM con servicio desagregado en producción. Las ganancias de rendimiento reportadas varían de 2x a 6,4x dependiendo de la carga de trabajo y el hardware. La implementación de DeepSeek-R1 de SGLang en GB200 midió una mejora del rendimiento de decodificación de 4,8 veces respecto al servicio monolítico H100.
¿Deberías desagregar? Un marco de decisión
Antes de refactorizar su pila de servicios, realice estas cinco comprobaciones. Tardan diez minutos y le evitarán diseñar demasiado una implementación simple o invertir poco en una que está sangrando dinero.
1. Mida su relación de tiempo de precarga y decodificación. Ejecute /status o una supervisión equivalente en su implementación actual y registre qué porcentaje del tiempo de la GPU del reloj de pared se emplea en cada fase. Si la decodificación representa menos del 70 % de la duración de la solicitud, su carga de trabajo requiere un prellenado pesado y la desagregación tiene una rentabilidad de utilización menor. Si la decodificación dura más del 85% del tiempo de la pared, estará pagando por núcleos tensoriales inactivos la mayor parte del día.
2. Calcule el tamaño de su transferencia de caché KV usando la fórmula anterior. Si supera los 500 MB por solicitud y su red tiene menos de 100 Gbps, la latencia de transferencia afectará su presupuesto TTFT. Ejecute los números para su modelo real y la duración media del mensaje, no para el peor de los casos teóricos.
3. Verifique la tasa de aciertos de la caché de su prefijo. Si está ejecutando cargas de trabajo agentes o de varios turnos con indicaciones compartidas del sistema, mida con qué frecuencia el trabajador de decodificación ya tiene un caché KV utilizable de un turno anterior. Las tasas de acierto superiores al 80% reducen el valor de un grupo de prellenado separado porque la mayor parte del trabajo de prellenado ya se omite.
4. Cuente sus GPU. Por debajo de ~16 GPU, la sobrecarga de programación de mantener dos grupos normalmente excede la ganancia de utilización. Por encima de 32 GPU con tráfico sostenido, los ahorros de costos derivados del hardware del tamaño adecuado comienzan a aumentar.
5. Audite su red. Compruebe si sus nodos tienen NIC compatibles con RDMA (EFA en AWS, ConnectX en bare metal) y qué ancho de banda admiten. Si está limitado a TCP, la desagregación aún puede funcionar para cargas de trabajo de contexto prolongado, pero la latencia de transferencia será mayor de lo que suponen las cifras de este artículo.
Si las comprobaciones 1, 4 y 5 resultan favorables, es casi seguro que la desagregación reducirá el costo de publicación por token. Comience con el modo de llenado previo desagregado integrado de vLLM, mida el impacto en TTFT e ITL y escale desde allí.
¿Qué viene después?
La mayoría de las implementaciones desagregadas actuales todavía utilizan el mismo modelo de GPU para ambos grupos. La investigación SPAD de UT Austin y la propia hoja de ruta de NVIDIA sugieren que está por llegar el silicio de precarga y decodificación especialmente diseñado. Mientras tanto, la versión práctica utiliza diferentes tipos de instancias en la nube: optimizadas para computación para precarga y optimizadas para memoria para decodificación. La arquitectura Mooncake de Moonshot AI va más allá: utiliza CPU DRAM y SSD como niveles de desbordamiento para el almacenamiento de caché KV, manteniendo la GPU HBM libre para la decodificación activa.
El Hao AI Lab llamó a la desagregación “el principio definitorio de la pila de inferencia moderna” en su retrospectiva de noviembre de 2025. Dieciocho meses desde el trabajo de investigación hasta la producción predeterminada en Perplexity, Meta y NVIDIA son rápidos, incluso para los estándares de infraestructura de ML. Los equipos que lo planifiquen ahora, con un modelado de capacidad y un diseño de red adecuados, gastarán menos cuando el tráfico aumente que los que lo adopten de forma reactiva.