
La tecnología de asistente virtual tiene como objetivo crear interacciones fluidas e intuitivas entre dispositivos humanos. Sin embargo, la necesidad de una frase desencadenante específica o de presionar un botón para iniciar un comando interrumpe la fluidez del diálogo natural. Al reconocer este desafío, los investigadores de Apple se han embarcado en un estudio innovador para mejorar la intuición de estas interacciones. Su solución elimina la necesidad de frases desencadenantes, lo que permite a los usuarios interactuar con los dispositivos de forma más espontánea.
El meollo del desafío radica en identificar con precisión cuándo está destinado un comando hablado al dispositivo en medio de una corriente de ruido de fondo y voz. Este problema es notablemente más complejo que la simple detección de palabras de activación porque implica discernir la intención del usuario sin señales explícitas. Intentos anteriores de abordar este problema han utilizado señales acústicas e información lingüística. Sin embargo, estos métodos a menudo fallan en ambientes ruidosos o escenarios de habla ambigua, que podrían ser más claros, lo que resalta una brecha que esta nueva investigación pretende cerrar.
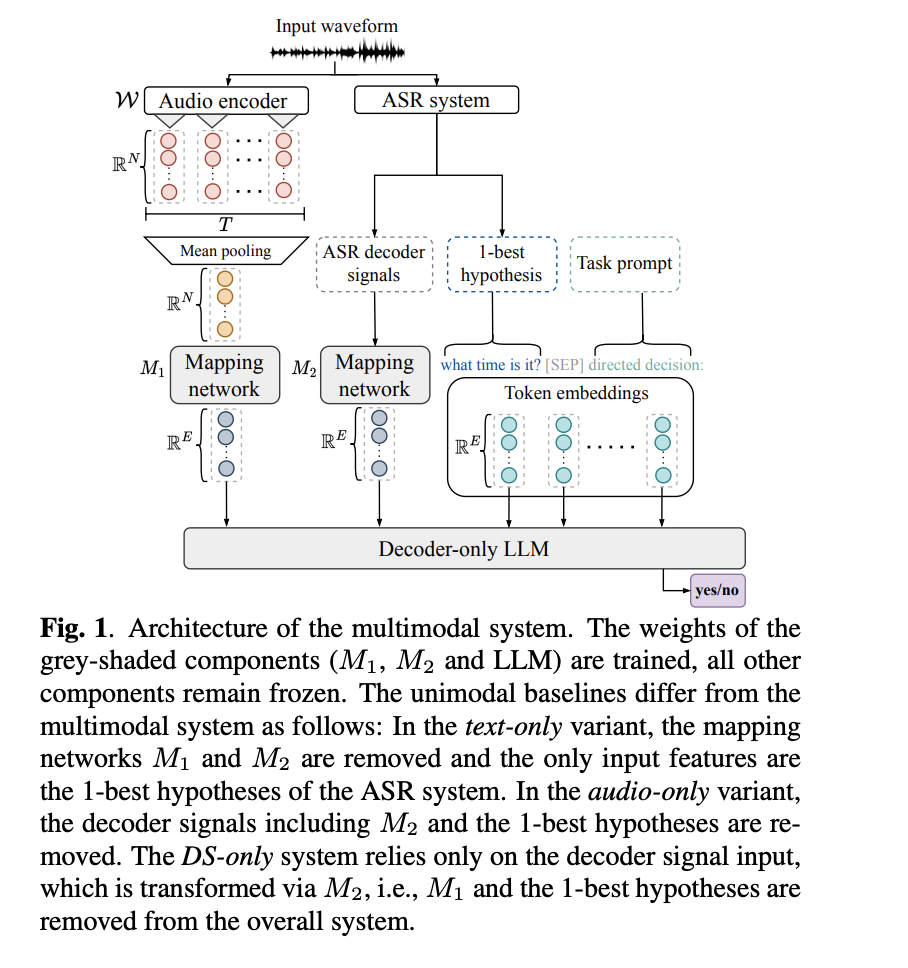
El equipo de investigación de Apple presenta un enfoque multimodal innovador que aprovecha la sinergia entre datos acústicos, señales lingüísticas y resultados de los sistemas de reconocimiento automático de voz (ASR). El núcleo de este método es utilizar un modelo de lenguaje grande (LLM) que, debido a sus capacidades de comprensión de texto de última generación, puede integrar diversos tipos de datos para mejorar la precisión de la detección del habla dirigida por dispositivos. Este enfoque utiliza las fortalezas individuales de cada tipo de entrada y explora cómo su combinación puede ofrecer una comprensión más matizada de la intención del usuario.
Desde un punto de vista técnico, la metodología de los investigadores implica entrenar clasificadores utilizando información puramente acústica extraída de formas de onda de audio. Las salidas del decodificador de un sistema ASR, incluidas hipótesis y características léxicas, se utilizan luego como entradas para el LLM. El paso final fusiona estas características acústicas y léxicas con las señales del decodificador ASR en un sistema multimodal que ingresa a un LLM, creando un marco sólido para comprender y categorizar el habla dirigida a un dispositivo.
La eficacia de este sistema multimodal se demuestra a través de sus métricas de rendimiento, que muestran mejoras significativas con respecto a los modelos tradicionales. Específicamente, el sistema logra reducciones en la tasa de error igual (EER) de hasta el 39 % y el 61 % en comparación con los modelos de solo texto y solo audio, respectivamente. Además, al aumentar el tamaño del LLM y aplicar técnicas de adaptación de bajo rango, el equipo de investigación impulsó estas reducciones de EER aún más, hasta un 18 % en su conjunto de datos.
La innovadora investigación de Apple allana el camino para interacciones más naturales con asistentes virtuales y establece un nuevo punto de referencia en este campo. Al lograr un EER del 7,95 % con el codificador de audio Whisper y del 7,45 % con la red troncal CLAP, la investigación muestra el potencial de combinar señales de texto, audio y decodificadores de un sistema ASR. Estos resultados significan un salto hacia la realización de asistentes virtuales que puedan comprender y responder a los comandos del usuario sin la necesidad de frases desencadenantes explícitas, acercándose a un futuro en el que la tecnología nos comprende tan bien como la conocemos.
La investigación de Apple ha dado como resultado mejoras significativas en la interacción entre humanos y dispositivos. Al combinar las capacidades de la información multimodal y el procesamiento avanzado impulsado por los LLM, el equipo de investigación ha allanado el camino para la próxima generación de asistentes virtuales. Esta tecnología tiene como objetivo hacer que nuestras interacciones con los dispositivos sean más intuitivas, similar a la comunicación de persona a persona. Tiene el potencial de cambiar fundamentalmente nuestra relación con la tecnología.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 39k+ ML

Muhammad Athar Ganaie, pasante de consultoría en MarktechPost, es un defensor del aprendizaje profundo eficiente, con especial atención en la capacitación dispersa. Cursando un M.Sc. en Ingeniería Eléctrica, con especialización en Ingeniería de Software, combina conocimientos técnicos avanzados con aplicaciones prácticas. Su esfuerzo actual es su tesis sobre “Mejora de la eficiencia en el aprendizaje por refuerzo profundo”, que muestra su compromiso de mejorar las capacidades de la IA. El trabajo de Athar se encuentra en la intersección “Capacitación escasa en DNN” y “Aprendizaje por refuerzo profundo”.