
Los modelos de lenguaje grande (LLM) han revolucionado el procesamiento del lenguaje natural (NLP) al lograr un rendimiento notable en tareas como la generación de texto, la traducción, el análisis de sentimientos y la respuesta a preguntas. Un ajuste eficiente es crucial para adaptar los LLM a diversas funciones posteriores. Permite a los profesionales utilizar el conocimiento previamente entrenado del modelo y al mismo tiempo requieren menos datos etiquetados y recursos computacionales que el entrenamiento desde cero. Sin embargo, implementar estos métodos en diferentes modelos requiere esfuerzos no triviales.
Ajustar muchos parámetros con recursos limitados se convierte en el principal desafío de adaptar LLM a tareas posteriores. Una solución popular es el ajuste eficiente, que reduce el costo de capacitación de los LLM al adaptarse a diversas tareas. Se han realizado varios otros intentos para desarrollar métodos para un ajuste eficiente del LLM. Aún así, necesitan un marco sistemático que adapte y unifique estos métodos a diferentes LLM y proporcione una interfaz amigable para la personalización del usuario.
Los investigadores de la Escuela de Ingeniería y Ciencias de la Computación de la Universidad de Beihang y la Escuela de Software y Microelectrónica de la Universidad de Pekín presentan LLAMAFACTORIA. Este marco democratiza el ajuste de los LLM. Unifica varios métodos de ajuste eficientes a través de módulos escalables, lo que permite ajustar cientos de LLM con recursos mínimos y un alto rendimiento. Además, optimiza los enfoques de capacitación comúnmente utilizados, incluido el preentrenamiento generativo, el ajuste fino supervisado (SFT), el aprendizaje reforzado a partir de la retroalimentación humana (RLHF) y la optimización de preferencias directas (DPO). Los usuarios pueden utilizar interfaces web o de línea de comandos para personalizar y ajustar sus LLM con un esfuerzo de codificación mínimo o nulo.
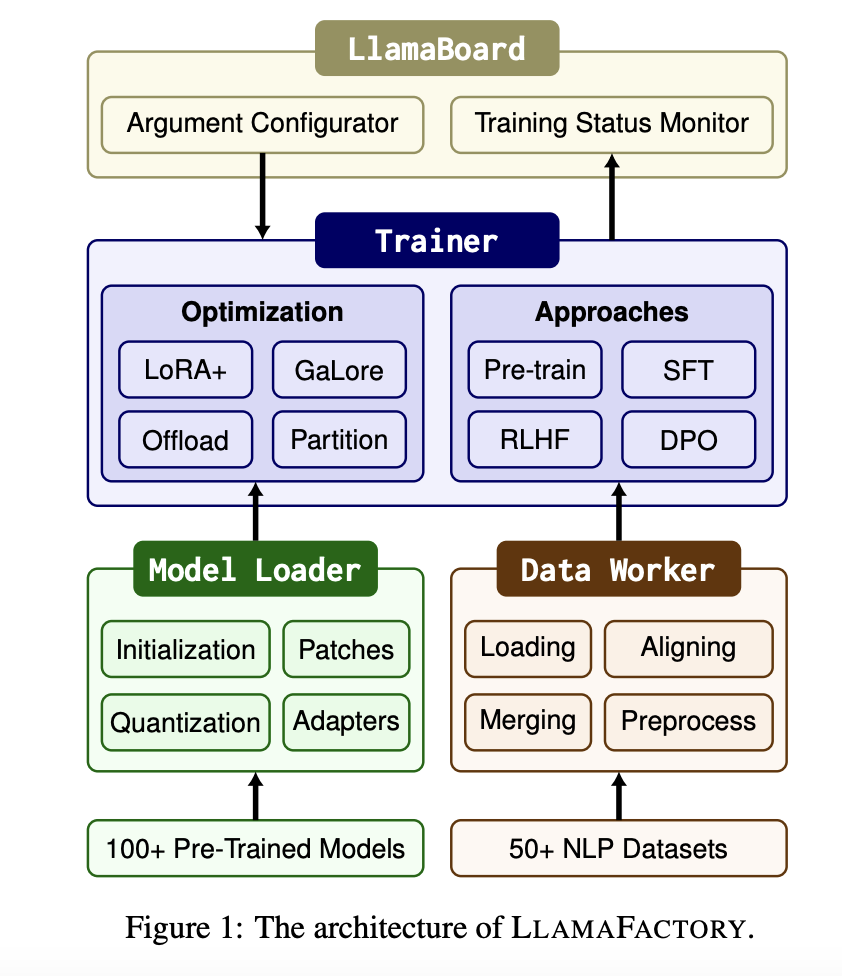
LLAMAFACTORY consta de tres módulos principales: Model Loader, Data Worker y Trainer. Utilizaron LLAMABOARD, que proporciona una interfaz visual amigable para los módulos anteriores. Esto permite a los usuarios configurar e iniciar procesos de ajuste de LLM individuales sin código y monitorear el estado de la capacitación sobre la marcha.
- Cargador de modelo: El cargador de modelos consta de cuatro componentes: inicialización del modelo, parcheo del modelo, cuantificación del modelo y conexión del adaptador. Prepara varias arquitecturas para realizar ajustes y admite más de 100 LLM.
- Trabajador de datos: El trabajador de datos procesa datos de diferentes tareas a través de un proceso bien diseñado que admite más de 50 conjuntos de datos.
- Entrenador: The Trainer unifica métodos eficientes de ajuste para adaptar estos modelos a diferentes tareas y conjuntos de datos, lo que ofrece cuatro enfoques de capacitación.
QLoRA constantemente tiene la menor huella de memoria en eficiencia de entrenamiento porque los pesos previamente entrenados están representados con menor precisión. LoRA exhibe un mayor rendimiento mediante la optimización en capas LoRA por parte de Unsloth. GaLore logra una PPL más baja en modelos grandes, mientras que LoRA tiene ventajas en los más pequeños. En los resultados de la evaluación de las tareas posteriores, se informaron las puntuaciones promedio de ROUGE-1, ROUGE-2 y ROUGE-L para cada LLM y cada conjunto de datos. LoRA y QLoRA funcionan mejor en la mayoría de los casos, excepto en los modelos Llama2-7B y ChatGLM3-6B en los conjuntos de datos CNN/DM y AdGen. Además, el modelo Mistral-7B funciona mejor en conjuntos de datos en inglés, mientras que el modelo Qwen1.5-7B logra puntuaciones más altas en el conjunto de datos chino.
En conclusión, los investigadores han propuesto LLAMAFACTORY, un marco unificado para el ajuste eficiente de los LLM. Un diseño modular minimiza las dependencias entre los modelos, conjuntos de datos y métodos de entrenamiento. Proporcionó un enfoque integrado para ajustar más de 100 LLM con una amplia gama de técnicas de ajuste eficientes. Además, se ofreció una interfaz de usuario web flexible, LLAMABOARD, que permite realizar ajustes y evaluaciones personalizados de los LLM sin esfuerzos de codificación. También validan empíricamente la eficiencia y eficacia de su marco en tareas de modelado de lenguaje y generación de texto.
Manifestación
Revisar la Papel y GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 39k+ ML

Asjad es consultor interno en Marktechpost. Está cursando B.Tech en ingeniería mecánica en el Instituto Indio de Tecnología, Kharagpur. Asjad es un entusiasta del aprendizaje automático y el aprendizaje profundo que siempre está investigando las aplicaciones del aprendizaje automático en la atención médica.