
El aprendizaje federado permite el entrenamiento de modelos colaborativos agregando gradientes de múltiples clientes, preservando así sus datos privados. Sin embargo, los ataques de inversión de gradientes pueden comprometer esta privacidad al reconstruir los datos originales a partir de los gradientes compartidos. Si bien son efectivos con datos de imágenes, estos ataques necesitan ayuda con el texto debido a su naturaleza discreta, lo que lleva a una recuperación sólo aproximada de pequeños lotes y secuencias cortas. Esto desafía a los LLM en campos sensibles como el derecho y la medicina, donde la privacidad es crucial. A pesar de la promesa del aprendizaje federado, sus garantías de privacidad se ven socavadas por estos ataques de inversión de gradiente.
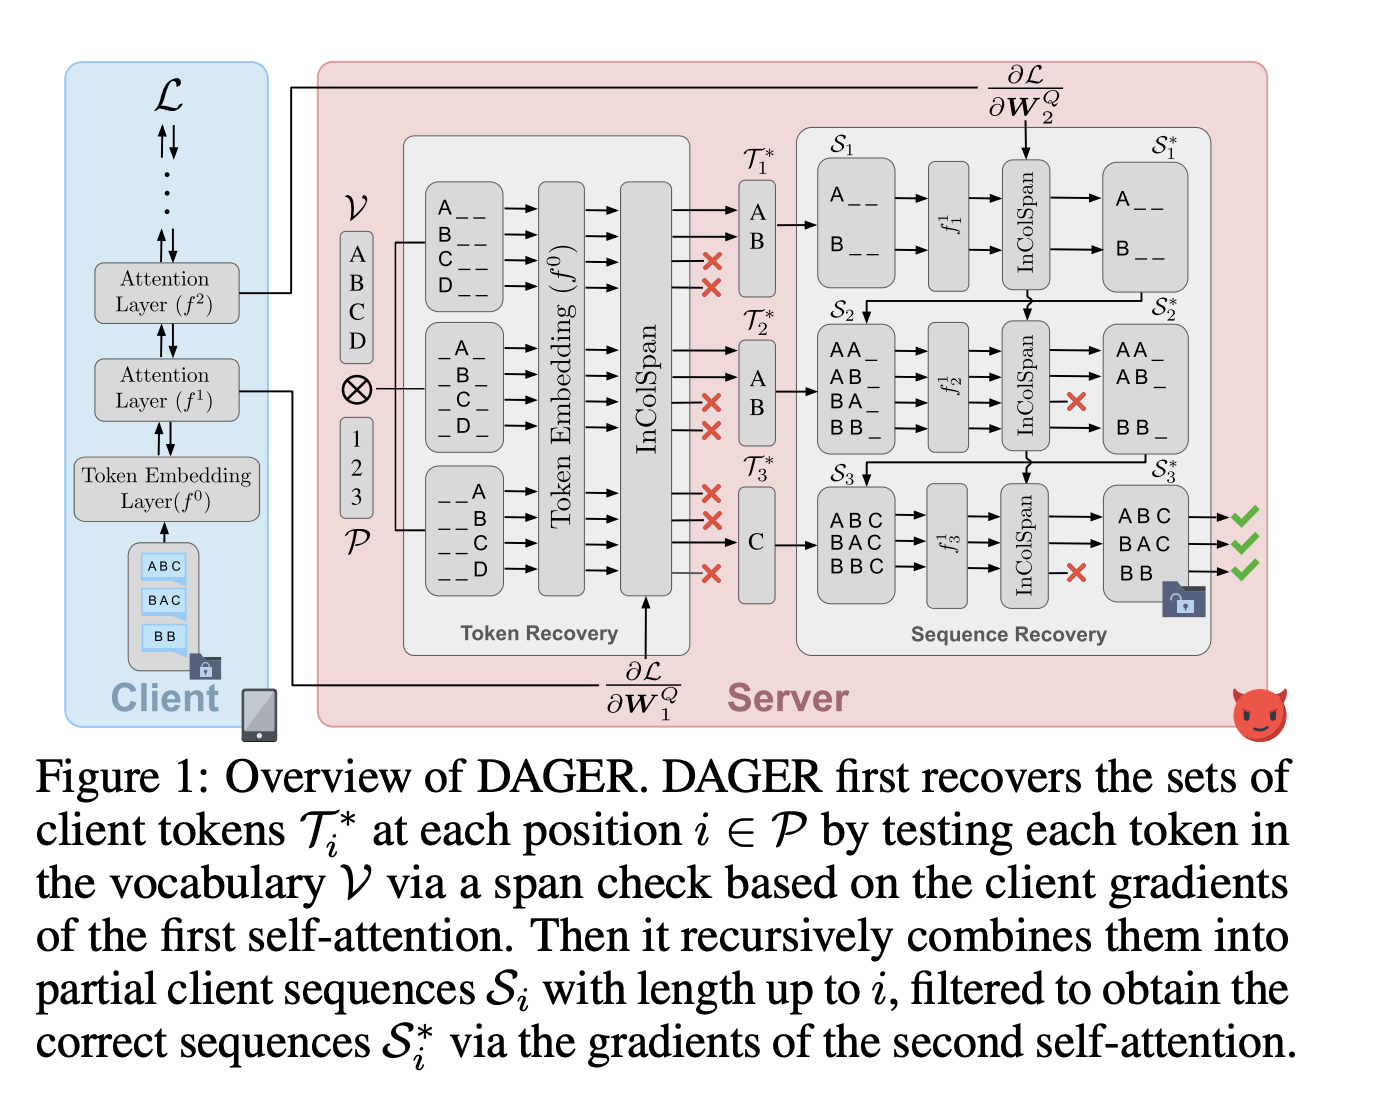
Investigadores de INSAIT, la Universidad de Sofía, ETH Zurich y LogicStar.ai han desarrollado DAGER, un algoritmo que recupera con precisión lotes enteros de texto de entrada. DAGER explota la estructura de bajo rango de los gradientes de la capa de autoatención y la naturaleza discreta de las incrustaciones de tokens para verificar secuencias de tokens en los datos del cliente, lo que permite una recuperación por lotes exacta sin conocimiento previo. Este método, eficaz para arquitecturas de codificador y decodificador, utiliza búsqueda heurística y enfoques codiciosos, respectivamente. DAGER supera los ataques anteriores en velocidad, escalabilidad y calidad de reconstrucción, recuperando lotes de hasta 128 tamaños en modelos de lenguajes grandes como GPT-2, LLaMa-2 y BERT.
Los ataques de fuga de gradiente se dividen en dos tipos principales: ataques honestos pero curiosos, en los que el atacante observa pasivamente las actualizaciones de aprendizaje federado, y ataques maliciosos a servidores, en los que el atacante puede modificar el modelo. Este artículo se centra en el entorno más desafiante, honesto pero curioso. La mayoría de las investigaciones en esta área se centran en datos de imágenes, y los ataques basados en texto generalmente requieren adversarios maliciosos o tienen limitaciones como secuencias cortas y lotes pequeños. DAGER supera estas limitaciones al admitir grandes lotes y secuencias para transformadores codificadores y decodificadores. También funciona para la predicción de tokens y el análisis de sentimientos sin datos previos sólidos, lo que demuestra una reconstrucción exacta para modelos de lenguaje basados en transformadores.
DAGER es un ataque que recupera secuencias de entrada del cliente a partir de gradientes compartidos en modelos de lenguaje basados en transformadores, centrándose en modelos solo decodificadores para simplificar. Aprovecha la deficiencia de rango de la matriz de gradiente de las capas de autoatención para reducir el espacio de búsqueda de posibles entradas. Inicialmente, DAGER identifica los tokens de cliente correctos en cada posición filtrando las incrustaciones incorrectas mediante comprobaciones de subespacio de gradiente. Luego, construye recursivamente secuencias parciales de clientes, verificando su corrección a través de capas posteriores de autoatención. Este proceso de dos etapas permite a DAGER reconstruir las secuencias de entrada completas de manera eficiente al extender progresivamente secuencias parciales con tokens verificados.
La evaluación experimental de DAGER demuestra su rendimiento superior en comparación con métodos anteriores en diversos entornos. Probado en modelos como BERT, GPT-2 y Llama2-7B, y conjuntos de datos como CoLA, SST-2, Rotten Tomatoes y ECHR, DAGER superó consistentemente a TAG y LAMP. DAGER logró reconstrucciones de secuencias casi perfectas, superando significativamente las líneas de base en modelos basados en decodificadores y codificadores. Su eficiencia se destacó por la reducción de los tiempos de cálculo. La evaluación también confirmó la solidez de DAGER ante secuencias largas y modelos más grandes, manteniendo altas puntuaciones de ROUGE incluso para lotes de mayor tamaño, lo que demuestra su escalabilidad y eficacia en diversos escenarios.
En conclusión, la dimensión de incrustación limita el rendimiento de DAGER en modelos basados en decodificadores y no se pueden lograr reconstrucciones exactas cuando el recuento de tokens excede esta dimensión. Investigaciones futuras podrían explorar la resistencia de DAGER contra mecanismos de defensa como DPSGD y su aplicación a protocolos FL más complejos. Para los modelos basados en codificadores, los lotes de gran tamaño plantean desafíos computacionales debido al crecimiento del espacio de búsqueda, lo que dificulta las reconstrucciones exactas. El trabajo futuro debería centrarse en la heurística para reducir el espacio de búsqueda. DAGER destaca la vulnerabilidad de los LLM basados en decodificadores a la fuga de datos, enfatizando la necesidad de medidas de privacidad sólidas en el aprendizaje colaborativo.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 43k+ ML

A Sana Hassan, pasante de consultoría en Marktechpost y estudiante de doble titulación en IIT Madras, le apasiona aplicar la tecnología y la inteligencia artificial para abordar los desafíos del mundo real. Con un gran interés en resolver problemas prácticos, aporta una nueva perspectiva a la intersección de la IA y las soluciones de la vida real.