
Los modelos de lenguaje (LM) están diseñados para reflejar una amplia gama de voces, lo que genera resultados que no coinciden perfectamente con ninguna perspectiva única. Para evitar respuestas genéricas, se pueden utilizar LLM mediante ajuste fino supervisado (SFT) o aprendizaje reforzado con retroalimentación humana (RLHF). Sin embargo, estos métodos necesitan enormes conjuntos de datos, lo que los hace poco prácticos para tareas nuevas y específicas. Además, a menudo existe una discrepancia entre el estilo universal formado en un LLM mediante instrucción y el ajuste de preferencias necesario para aplicaciones específicas. Esta falta de coincidencia da como resultado que los resultados del LLM parezcan genéricos y carezcan de una voz distintiva.
Se han desarrollado varios métodos para abordar estos desafíos. Uno de los enfoques implica LLM y Preference Finetuning, en los que los LLM se capacitan en enormes conjuntos de datos para desempeñarse bien con indicaciones cuidadosas. Sin embargo, diseñar indicaciones puede ser difícil y sensible a las variaciones, por lo que a menudo es necesario ajustar estos modelos en grandes conjuntos de datos y utilizar RLHF. Otra estrategia es la superación personal, donde se utiliza un muestreo iterativo para mejorar los LLM. Por ejemplo, métodos como STaR se supervisan verificando la exactitud de sus resultados. Por último, el aprendizaje por imitación en línea puede mejorar una política más allá del desempeño del demostrador. Sin embargo, estos enfoques necesitan aprender una función de recompensa y no son aplicables a los LLM.
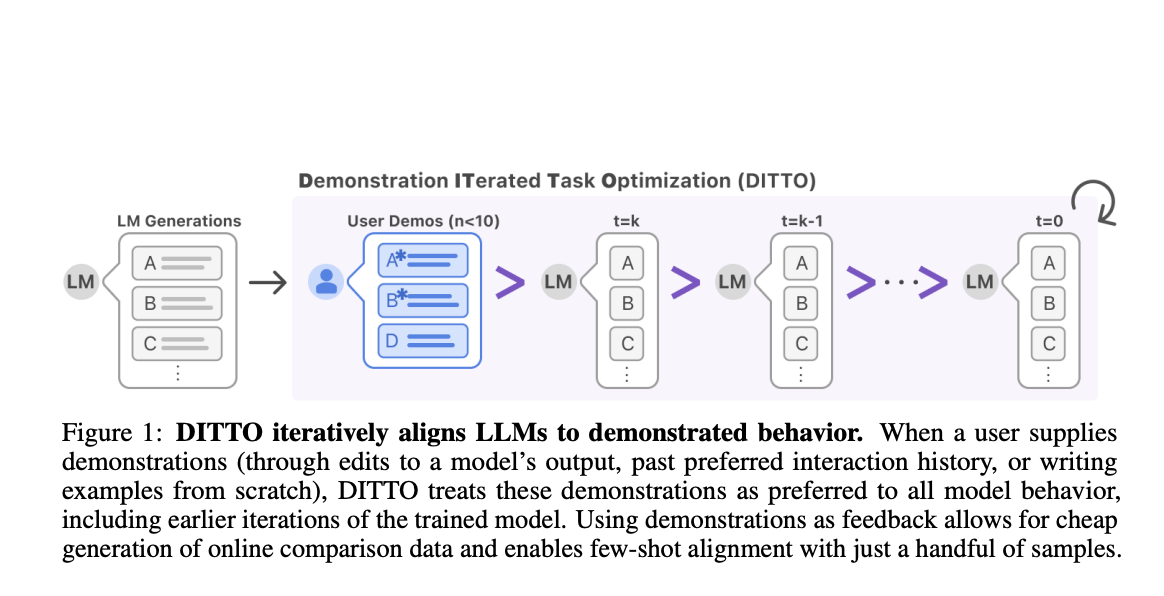
Investigadores de la Universidad de Standford han introducido la optimización de tareas iteradas de demostración (DITTO), un método que alinea los resultados del modelo de lenguaje directamente con los comportamientos demostrados del usuario. Se deriva de ideas del aprendizaje por imitación en línea y puede generar datos comparativos en línea a bajo costo. Para generar estos datos, DITTO prioriza las demostraciones de los usuarios sobre los resultados del LLM y sus puntos de control intermedios. Además, las tasas de ganancia de este método superan las indicaciones de pocos disparos, los ajustes supervisados y otros métodos de juego automático en un promedio de 19 % puntos. Además, proporciona una forma novedosa de personalizar eficazmente los LLM utilizando comentarios directos de las demostraciones.
DITTO es capaz de aprender estilos detallados y alineación de tareas en dominios como artículos de noticias, correos electrónicos y publicaciones de blogs. Es un proceso iterativo que contiene tres componentes: (a) en el conjunto de demostraciones de expertos, se ejecuta un ajuste supervisado para un número limitado de pasos de gradiente; (b) se construye un nuevo conjunto de datos durante el proceso de capacitación mediante el muestreo de las finalizaciones de cada demostración y su adición a la clasificación de las políticas, y (c) el RLHF se utiliza para actualizar la política, en particular utilizando lotes muestreados a través del proceso mencionado anteriormente.
Los resultados de DITTO se evalúan con GPT-4 eval y se promedian entre todos los autores, donde supera todas las líneas de base con una tasa de ganancia promedio del 77,09 % en CMCC (71,67 %) y CCAT50 (82,50 %). Proporciona un aumento promedio de la tasa de ganancia del 11,7% en comparación con SFT, que sirve como base sólida (56,78% en CMCC, 73,89% en CCAT). Además, en los resultados de los estudios de usuarios, DITTO supera a los métodos de referencia con DITTO (72,1% de tasa de éxito) > SFT (60,1%) > pocos disparos (48,1%) > autoindicación (44,2%) > cero disparos (25,0%) . Además, la autopromoción funciona un poco peor que dar ejemplos en unas pocas indicaciones y tiene un rendimiento inferior al de DITTO.
En conclusión, investigadores de la Universidad de Standford han introducido la optimización de tareas iteradas de demostración (DITTO), un método que alinea los resultados del modelo de lenguaje directamente con los comportamientos demostrados del usuario y genera datos de comparación en línea a partir de demostraciones. En este artículo, los investigadores destacaron la importancia de utilizar demostraciones como retroalimentación y demostraron que incluso una pequeña cantidad de comportamientos demostrados pueden proporcionar una señal fuerte de las preferencias específicas de un individuo. Sin embargo, los investigadores no prueban otros tamaños de modelos debido al costo computacional y se necesita un análisis adicional según los tipos de datos de preferencia necesarios. Por tanto, es necesario realizar trabajos futuros en este ámbito.
Revisar la Papel y GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 43k+ ML | Además, consulte nuestro Plataforma de eventos de IA

Sajjad Ansari es un estudiante de último año de IIT Kharagpur. Como entusiasta de la tecnología, profundiza en las aplicaciones prácticas de la IA centrándose en comprender el impacto de las tecnologías de IA y sus implicaciones en el mundo real. Su objetivo es articular conceptos complejos de IA de una manera clara y accesible.