
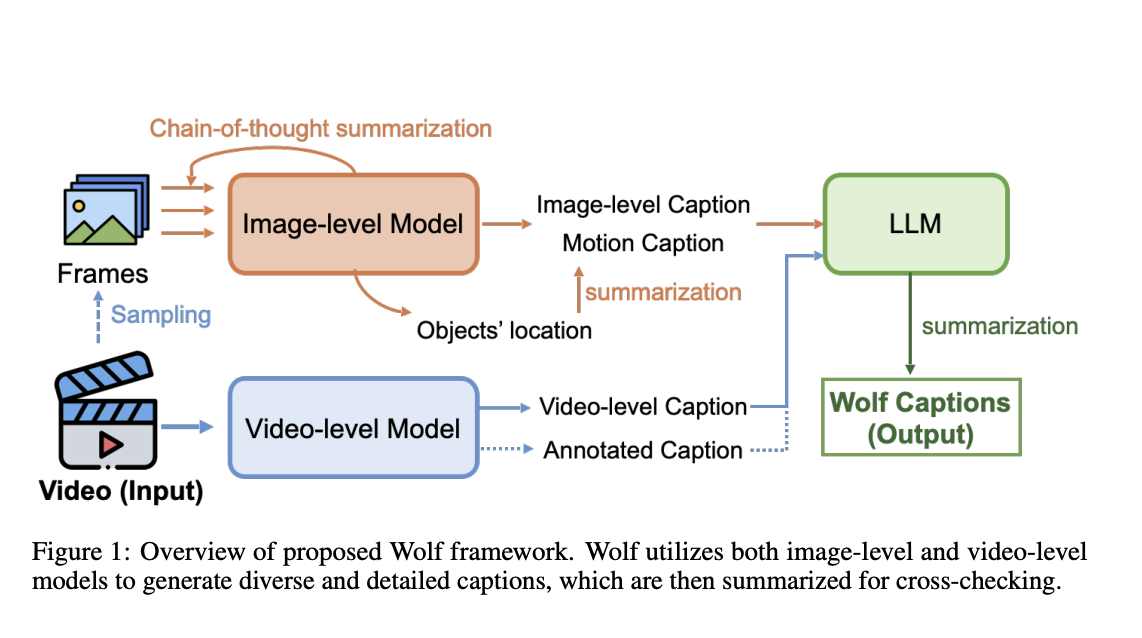
Los subtítulos de vídeo han adquirido una importancia cada vez mayor para la comprensión y recuperación de contenidos, y para el entrenamiento de modelos básicos para tareas relacionadas con el vídeo. A pesar de su importancia, generar subtítulos de vídeo precisos, detallados y descriptivos es un desafío en campos como la visión artificial y el procesamiento del lenguaje natural. Varios obstáculos clave impiden el progreso en esta área. Un ejemplo de ello es la escasez de datos de alta calidad, ya que los datos de Internet son inexactos y los grandes conjuntos de datos son muy costosos. Además, los subtítulos de vídeo son inherentemente más complejos que los de imágenes debido a las correlaciones temporales y al movimiento de la cámara. La falta de puntos de referencia establecidos y la necesidad crítica de precisión en aplicaciones críticas para la seguridad hacen que este desafío sea más complejo en este dominio.
Los recientes avances en los modelos de lenguaje visual han mejorado el subtitulado de imágenes; sin embargo, estos modelos enfrentan desafíos con el subtitulado de videos debido a las complejidades temporales. Los modelos específicos de video como PLLaVa, Video-llava y Video-LLama se han desarrollado para abordar este desafío. Sus técnicas incluyen agrupamiento sin parámetros, entrenamiento conjunto de imágenes y videos y procesamiento de entrada de audio. Los investigadores también han explorado el uso de modelos de lenguaje grandes (LLM) para tareas de resumen, como lo demuestra LLaDA y el método de re-subtitulado de OpenAI. A pesar de estos avances, este campo necesita un punto de referencia establecido y la necesidad crítica de precisión en aplicaciones sensibles a la seguridad.
Investigadores de NVIDIA, UC Berkeley, MIT, UT Austin, Universidad de Toronto y Universidad de Stanford han propuesto Loboun marco de resumen mundial para subtitular videos de manera precisa. Wolf utiliza un enfoque de combinación de expertos, utilizando modelos de lenguaje de visión (VLM) de imágenes y videos para capturar diferentes niveles de información y resumir de manera eficiente. El marco está desarrollado para mejorar la comprensión de videos, el etiquetado automático y los subtítulos. Los investigadores introdujeron CapScore, una métrica basada en LLM que evalúa la similitud y la calidad de los subtítulos generados en comparación con la realidad básica. Wolf supera los métodos y soluciones comerciales de vanguardia actuales, lo que aumenta significativamente CapScore en videos de conducción desafiantes.
La evaluación de Wolf utiliza cuatro conjuntos de datos: 500 videos interactivos de Nuscences, 4785 videos normales de Nuscences, 473 videos generales y 100 videos de robótica. La métrica CapScore propuesta evalúa la similitud de los subtítulos con la realidad básica. El método propuesto se compara con métodos de última generación, incluidos CogAgent, GPT-4V, VILA-1.5 y Gemini-Pro-1.5. Los métodos a nivel de imagen como CogAgent y GPT-4V procesan fotogramas secuenciales, mientras que los métodos basados en video como VILA-1.5 y Gemini-Pro-1.5 manejan entradas de video completas. Se utiliza un mensaje consistente en todos los modelos, centrándose en expandir los elementos visuales y narrativos, especialmente el comportamiento del movimiento.
Los resultados indican que Wolf supera a los métodos de última generación en subtitulado de videos. Si bien GPT-4V es mejor en el reconocimiento de escenas, tiene dificultades con la información temporal. Gemini-Pro-1.5 captura parte del contexto del video, pero carece de detalles en la descripción del movimiento. Por el contrario, Wolf captura de manera eficiente el contexto de la escena y los comportamientos de movimiento detallados, como vehículos que se mueven en diferentes direcciones y responden a las señales de tráfico. Cuantitativamente, Wolf supera a los métodos actuales, como VILA1.5, CogAgent, Gemini-Pro-1.5 y GPT-4V. En videos de conducción desafiantes, Wolf mejora CapScore en un 55,6 % en calidad y un 77,4 % en similitud en comparación con GPT-4V. Estos resultados subrayan la capacidad de Wolf para proporcionar subtítulos de video más completos y precisos.
En conclusión, los investigadores han presentado Wolf, un marco de resumen mundial para subtitular videos de forma precisa. Wolf representa un avance significativo en el subtitulado automático de videos, ya que combina modelos de subtitulado y técnicas de resumen para producir descripciones detalladas y correctas. Este enfoque permite una comprensión integral de los videos desde varias perspectivas, y se destaca especialmente en escenarios desafiantes como los videos de conducción con múltiples vistas. Los investigadores han establecido una tabla de clasificación para fomentar la competencia y la innovación en la tecnología de subtitulado de videos. También planean crear una biblioteca completa que incluya diversos tipos de videos con subtítulos de alta calidad, información regional como cuadros delimitadores 2D o 3D y datos de profundidad, y múltiples detalles de movimiento de objetos.
Revisar la Papel y Proyecto. Todo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!. Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Más de 47 000 suscriptores de ML en Reddit
Encuentra lo próximo Seminarios web sobre IA aquí

Sajjad Ansari es un estudiante de último año de la carrera de IIT Kharagpur. Como entusiasta de la tecnología, se adentra en las aplicaciones prácticas de la IA, centrándose en comprender el impacto de las tecnologías de IA y sus implicaciones en el mundo real. Su objetivo es articular conceptos complejos de IA de una manera clara y accesible.
