
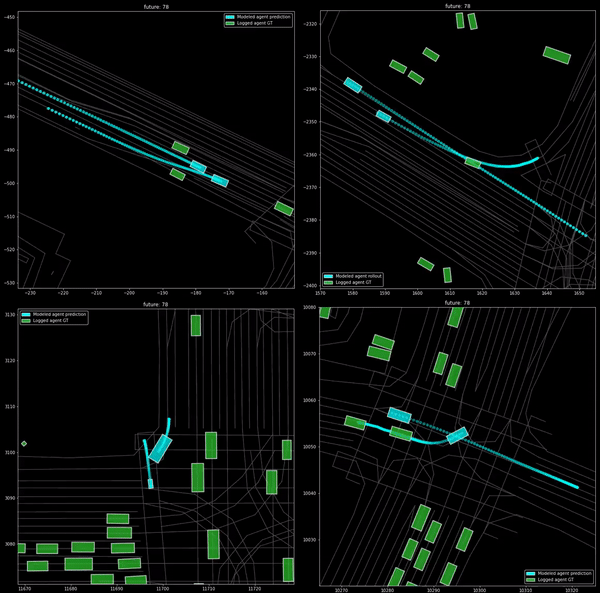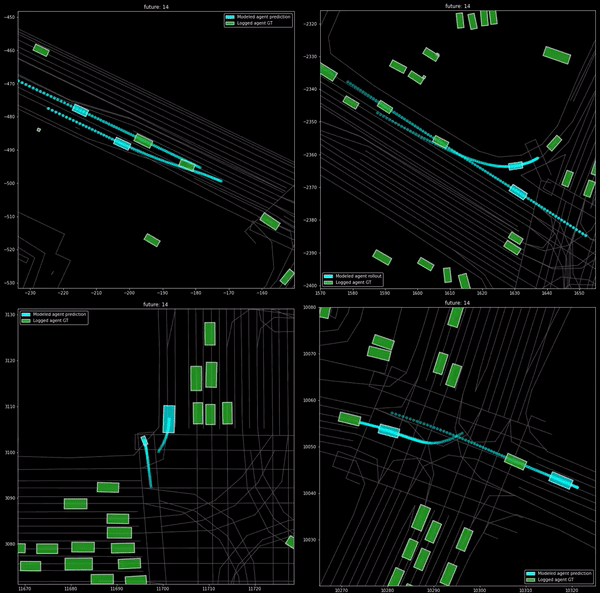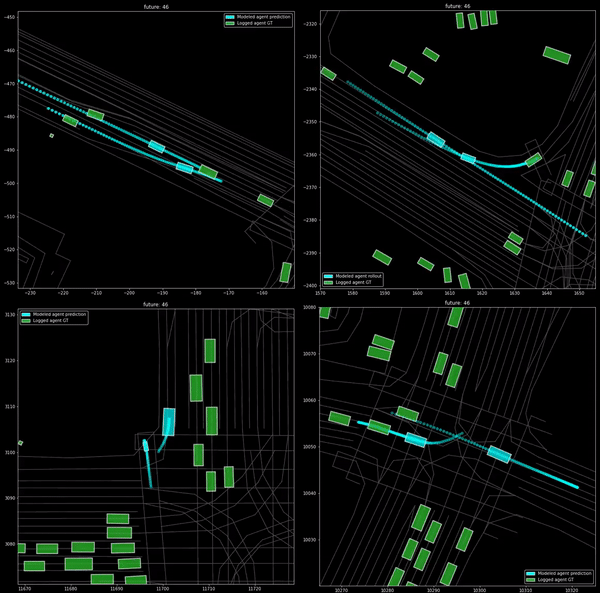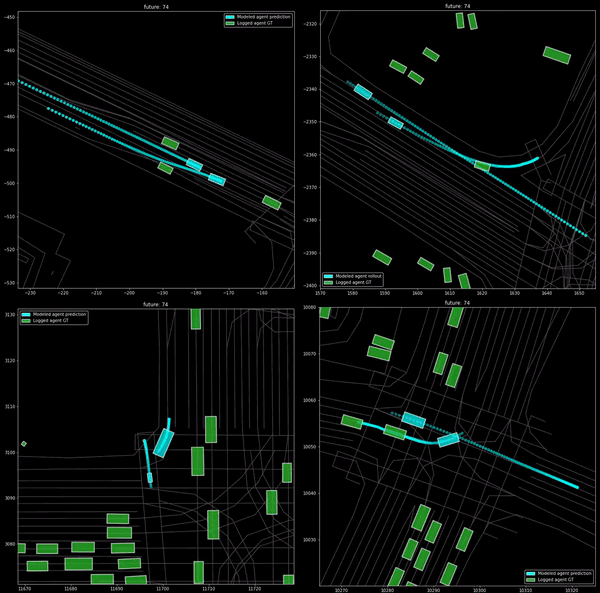
Los modelos de lenguaje autorregresivos se han destacado en la predicción de la subpalabra siguiente en una oración sin la necesidad de gramática predefinida o conceptos de análisis. Este método se ha ampliado para incluir dominios de datos continuos como la producción de audio e imágenes, donde los datos se representan como tokens discretos, muy parecidos a los vocabularios de los modelos de lenguaje. Debido a su versatilidad, los modelos de secuencia han atraído el interés por su uso en contextos cada vez más complicados y dinámicos, como el comportamiento.
Los usuarios de la vía se comparan con los participantes en una conversación continua mientras conducen, ya que intercambian acciones y respuestas. La cuestión es si se pueden utilizar modelos de secuencia similares para pronosticar el comportamiento de los agentes viales de la misma manera que los modelos lingüísticos capturan distribuciones lingüísticas complejas en las conversaciones. Descomponer la distribución combinada del comportamiento de los agentes en distribuciones marginales independientes por agente ha sido una estrategia popular para predecir el comportamiento de los agentes viales. Aunque ha habido avances en esta dirección, estos pronósticos marginales tienen limitaciones porque no toman en cuenta cómo las acciones futuras de varios agentes se verán influenciadas entre sí, lo que podría resultar en pronósticos impredecibles a nivel de escena.
Para abordar estos problemas, un equipo de investigadores de Waymo presentó MotionLM, un enfoque único para predecir el comportamiento futuro de los agentes de la carretera, que es un aspecto crucial de la planificación segura en vehículos autónomos. La idea principal detrás de MotionLM es abordar el desafío de la predicción del movimiento de agentes de múltiples vías como un trabajo de modelado de lenguaje. Enmarca la tarea de predicción como si estuviera creando frases en un idioma, siendo el idioma las acciones de los agentes de la carretera.
MotionLM logra esto sin utilizar anclajes ni complicados procedimientos de optimización de variables latentes, a diferencia de otros métodos existentes que dependen de ellos para capturar diversos comportamientos potenciales futuros. Este modelo emplea un objetivo de modelado de lenguaje simple con el objetivo de maximizar la probabilidad logarítmica promedio de anticipar correctamente la secuencia del token de movimiento. El modelo es más accesible y sencillo de entrenar debido a su sencillez.
Numerosos métodos actuales utilizan un procedimiento de dos pasos en el que primero se producen por separado las trayectorias de los agentes individuales y luego se evalúa la interacción entre los agentes. Por el contrario, MotionLM utiliza un único enfoque de decodificación autorregresiva para construir directamente distribuciones conjuntas sobre las acciones futuras de numerosos actores. Esta integración del modelado de interacción es más eficaz y fluida. También es posible implementar condicionales temporalmente causales gracias a la factorización secuencial de MotionLM. Las predicciones sobre el comportamiento futuro de los agentes se realizan considerando los vínculos causales entre eventos, aumentando su realismo y precisión.
Tras la evaluación, MotionLM tuvo un excelente rendimiento cuando se probó con el conjunto de datos Waymo Open Motion. Encabezó la clasificación del desafío interactivo, demostrando que funciona mejor que otros enfoques para pronosticar las acciones de los agentes viales en situaciones desafiantes. En conclusión, MotionLM es definitivamente un enfoque innovador para la predicción de movimiento multiagente para vehículos autónomos y es un avance realmente beneficioso en este campo.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 31k+ ML, Comunidad de Facebook de más de 40.000 personas, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
También estamos en WhatsApp. Únase a nuestro canal de IA en Whatsapp.
Tanya Malhotra es estudiante de último año de la Universidad de Estudios de Petróleo y Energía, Dehradun, y cursa BTech en Ingeniería Informática con especialización en Inteligencia Artificial y Aprendizaje Automático.
Es una entusiasta de la Ciencia de Datos con buen pensamiento analítico y crítico, junto con un ardiente interés en adquirir nuevas habilidades, liderar grupos y gestionar el trabajo de manera organizada.