

Hemos explicado formalmente más temprano el efecto del desequilibrio de clases y sus causas y también explicamos varias técnicas de sobremuestreo que solucionan este problema, como el sobremuestreo aleatorio, ROSE, RWO, SMOTE, BorderlineSMOTE1, SMOTE-NC y SMOTE-N. En esta historia, intentaremos hacer un recorrido similar sobre las técnicas de submuestreo, asumiendo que es obvio cómo el submuestreo ayudaría a resolver el problema del desequilibrio dada nuestra explicación anterior.
Las técnicas de submuestreo generalmente se dividen en dos categorías principales: controladas y no controladas. En técnicas controladas, el algoritmo recibe un número que indica cuántas muestras debe haber en el conjunto de datos final; mientras tanto, en técnicas no controladas el submuestreo suele realizarse simplemente eliminando puntos que cumplen alguna condición. Se desconoce a priori cuántos puntos cumplirán dicha condición y evidentemente no se puede controlar. En esta historia, cubriremos dos técnicas de submuestreo controlado (submuestreo aleatorio y de k-medias) y dos técnicas de submuestreo no controlado (Tomek Links y Edited Nearest Neighbors).
Submuestreo aleatorio ingenuo
En esta técnica, si se da que N_k los puntos deben ser eliminados de la clase kentonces N_k Los puntos se eligen aleatoriamente de esa clase para su eliminación.
A continuación se muestra un ejemplo de submuestreo de las dos clases mayoritarias en datos con tres clases 0, 1 y 2.
La siguiente es una animación que muestra la salida en diferentes grados de submuestreo.
Observe cómo se trata de un proceso completamente aleatorio; no se hace ninguna elección específica con respecto a qué puntos conservar. Debido a esto, la distribución de los datos puede verse gravemente alterada.
Submuestreo de K-medias
Podemos preservar la distribución de los datos siendo más cuidadosos sobre qué puntos eliminar (o conservar). En el submuestreo de K-medias, si se requiere tener N_k puntos para la clase k, entonces K-medias se realiza con K=N_k llevando a N_k centroides finales. K-significa submuestreo, dejemos que esos centros (o el vecino más cercano de cada uno de ellos; este es un hiperparámetro) sean el final N_k puntos para regresar. Debido a que los propios centros preservan la distribución de los datos, esto da como resultado un conjunto más pequeño de puntos que también los preservan.
A continuación se muestra un ejemplo de submuestreo de las dos clases mayoritarias en datos con tres clases 0, 1 y 2.
Observe cómo es más cuidadoso en términos de preservar la estructura de los datos que el submuestreo aleatorio, que sería aún más evidente con más submuestreo. Ilustremos esto con una animación:
Tenga en cuenta que los centros dependen de la inicialización que normalmente implica aleatoriedad.
Submuestreo de enlaces de Tomek
Esta es una técnica de submuestreo incontrolado en la que se puede eliminar un punto si es parte de un enlace Tomek. Dos puntos forman un enlace Tomek si:
- Pertenecen a diferentes clases.
- Cada uno de los dos puntos es el vecino más cercano del otro punto.
La razón aquí es que tales puntos no ayudan a mejorar el límite de decisión (por ejemplo, pueden facilitar el sobreajuste) y que tal vez generen ruido. El siguiente es un ejemplo para aplicar Tomek Links:
Observe cómo después del submuestreo es más fácil encontrar un límite de decisión más lineal, además de que esto también equilibra mejor los datos. En esto, omitimos el submuestreo de la clase minoritaria en verde y dejamos de submuestrear una clase una vez que tuvo aproximadamente la misma cantidad de puntos.
Para ver esto en acción más de cerca, donde todas las clases finalmente se submuestrean, considere la siguiente animación:
Submuestreo de vecinos más cercanos editado
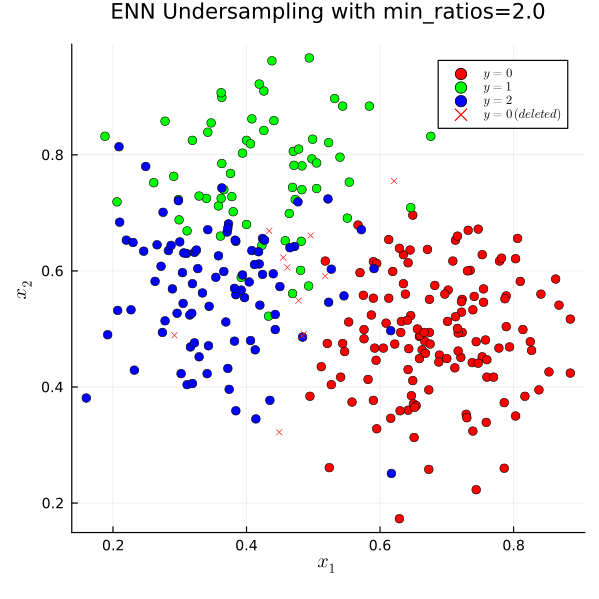
Aunque los enlaces de Tomek son en su mayoría puntos que no ayudan a formar un mejor límite de decisión o son ruido, no todos los puntos ruidosos formarán enlaces de Tomek. Si un punto ruidoso de clase. k_1 existe en una región densa en clase k_2 entonces puede ser normal que el vecino más cercano al punto ruidoso tenga un punto más cercano que no sea el punto ruidoso, lo que implica que permanecerá para no formar un enlace Tomek. En lugar de esta condición, el submuestreo de vecinos más cercanos editado de forma predeterminada mantiene un punto si la mayoría de sus vecinos son de la misma clase. También existe la opción de conservar solo si todos son de la misma clase o para un submuestreo mínimo para mantener cualquier punto si existe un vecino de la misma clase.
Esta animación muestra el algoritmo en acción:
Observe cómo limpia más puntos que no serían útiles para el límite de decisión o que son ruido. Se puede realizar una limpieza aún mayor si el número de vecinos k o la condición de mantenimiento se modifican de la manera correcta. Esta es otra animación que ilustra el efecto.
La diferencia entre las condiciones de “modo” y “solo modo” es que la primera mantiene un punto si su clase es una de las más comunes entre los vecinos; mientras tanto, este último mantiene un punto si su clase es la única clase más común.
Esto concluye nuestro recorrido por algunos algoritmos de submuestreo interesantes. Espero que esto le haya ayudado a aprender más sobre el submuestreo controlado y no controlado. Hasta la próxima, hasta la próxima.
Referencias:
[1] Wei-Chao, L., Chih-Fong, T., Ya-Han, H. y Jing-Shang, J. (2017). Submuestreo basado en agrupaciones en datos desequilibrados de clases. Ciencias de la información, 409–410, 17–26.
[2] Iván Tomek. Dos modificaciones de cnn. Traducción IEEE. Sistemas, hombre y cibernética, 6:769–772, 1976.
[3] Dennis L Wilson. Propiedades asintóticas de las reglas del vecino más cercano utilizando datos editados. Transacciones IEEE sobre sistemas, hombre y cibernética, páginas 408–421, 1972.