
Un objetivo importante en el estudio de la Inteligencia Artificial es el desarrollo de sistemas de IA que puedan proporcionar programas informáticos útiles para abordar problemas desafiantes. Se ha avanzado mucho en esta dirección en los últimos años, especialmente con los notables éxitos de los modelos de lenguajes grandes (LLM) masivos previamente entrenados. Estos modelos se crearon inicialmente para la comprensión del lenguaje natural, pero ahora se han ampliado para incluir la capacidad de generar y comprender código y texto. Como resultado de este desarrollo, se han logrado avances notables en la producción de código a partir de descripciones de problemas del lenguaje natural.
Los LLM ya han demostrado ser capaces de manejar tareas de programación sencillas, como lo demuestran sus logros en puntos de referencia como MBPP y HumanEval. Sin embargo, estos modelos encuentran importantes dificultades al intentar resolver tareas de programación más difíciles y competitivas. Su propensión a proporcionar soluciones de código como bloques monolíticos en lugar de descomponerlas en subtareas lógicas y submódulos reutilizables es una de las principales causas de sus dificultades. Por otro lado, cuando se enfrentan a problemas complejos, los programadores humanos capacitados escriben instintivamente código modular y abstracto. Al reutilizar módulos creados previamente, amplían de manera efectiva su experiencia actual.
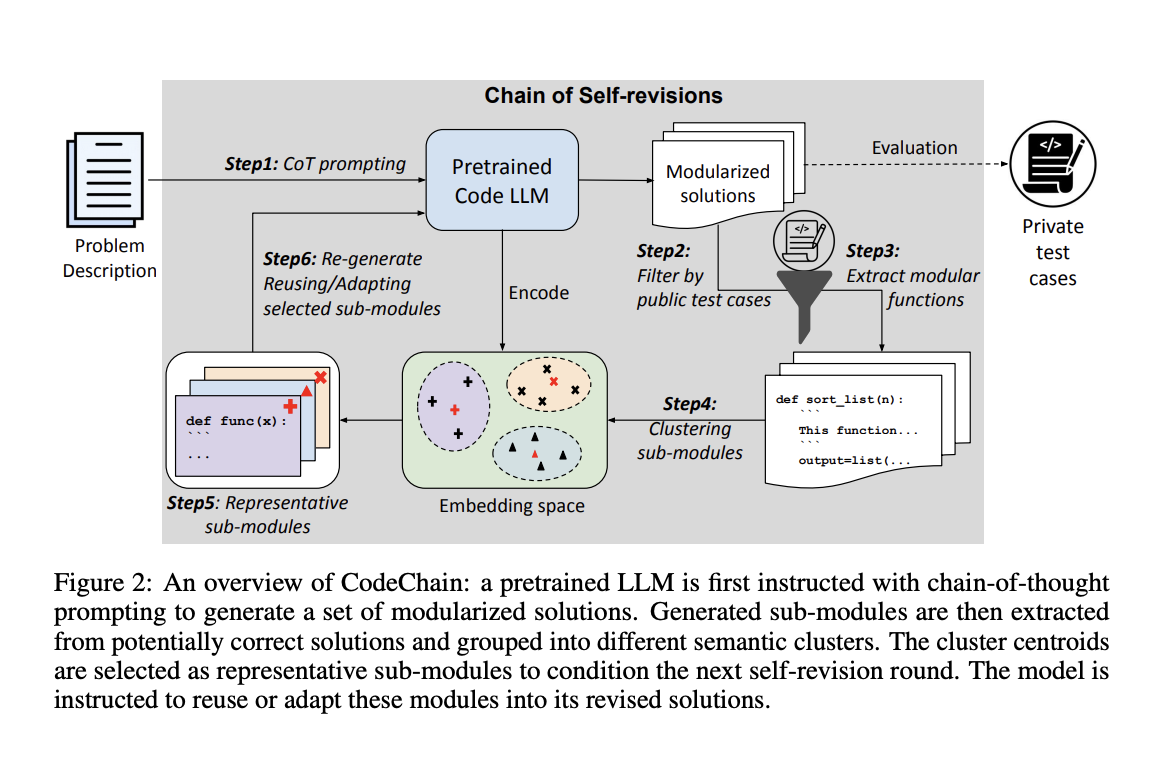
En una investigación reciente, un equipo de investigadores de Salesforce Research presentó CodeChain, un marco innovador para cerrar la brecha entre los LLM y los desarrolladores humanos. Con una secuencia de autorrevisiones impulsadas por submódulos representativos desarrollados en iteraciones anteriores, este marco tiene como objetivo mejorar el proceso de desarrollo de código modularizado. CodeChain le dice al LLM que escriba código modularizado utilizando un enfoque de cadena de pensamiento. La intención es motivar al modelo a abordar la resolución de problemas en términos de subtareas y submódulos lógicos.
Una secuencia de autorrevisiones forma la base de CodeChain. Hay dos fases iterativas en él, que son las siguientes.
- Extracción y agrupación de submódulos: en esta etapa, los submódulos se encuentran analizando el código que produjo el LLM. Después de eso, estos submódulos se organizan en grupos. Se eligen submódulos representativos de cada grupo. Se cree que estas representaciones son más ampliamente aplicables y reutilizables.
- Aumento y regeneración de mensajes: el mensaje de cadena de pensamiento inicial se mejora y regenera integrando las implementaciones de módulos elegidos de la etapa anterior. Después de eso, se le pide al LLM que vuelva a producir nuevas soluciones modulares. Como resultado, el modelo puede ampliar efectivamente la información y la comprensión que obtuvo de iteraciones anteriores.
CodeChain tiene un gran impacto en la generación de código. El equipo ha compartido que la modularidad y precisión de las soluciones generadas mejoran enormemente al impulsar al LLM a desarrollar y reutilizar submódulos verificados preexistentes. El marco ha logrado mejoras relativas de pass@1 del 35% en APPS y en CodeContests de un asombroso 76%. Estos avances se muestran en una variedad de LLM, incluidos LLM de código abierto como WizardCoder y modelos de OpenAI. Se han llevado a cabo estudios exhaustivos de ablación para obtener una comprensión más profunda de los elementos que han contribuido al éxito de CodeChain. En estos estudios se examinan aspectos como las técnicas de estimulación, el número de grupos empleados, los tamaños de los modelos LLM y el calibre de los programas producidos. La comprensión obtenida de estas investigaciones aclara por qué CodeChain tiene tanto éxito en aumentar el calibre y la modularidad del código producido por los LLM.
En resumen, CodeChain es un desarrollo revolucionario en el campo de la generación de código de modelos de lenguajes grandes. Lo logra promoviendo la modularidad y facilitando las autorrevisiones mediante la reutilización de submódulos creados previamente, cerrando así la brecha entre los LLM y los programadores humanos experimentados.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 31k+ ML, Comunidad de Facebook de más de 40.000 personas, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
También estamos en WhatsApp. Únase a nuestro canal de IA en Whatsapp.
Tanya Malhotra es estudiante de último año de la Universidad de Estudios de Petróleo y Energía, Dehradun, y cursa BTech en Ingeniería Informática con especialización en Inteligencia Artificial y Aprendizaje Automático.
Es una entusiasta de la Ciencia de Datos con buen pensamiento analítico y crítico, junto con un ardiente interés en adquirir nuevas habilidades, liderar grupos y gestionar el trabajo de manera organizada.