
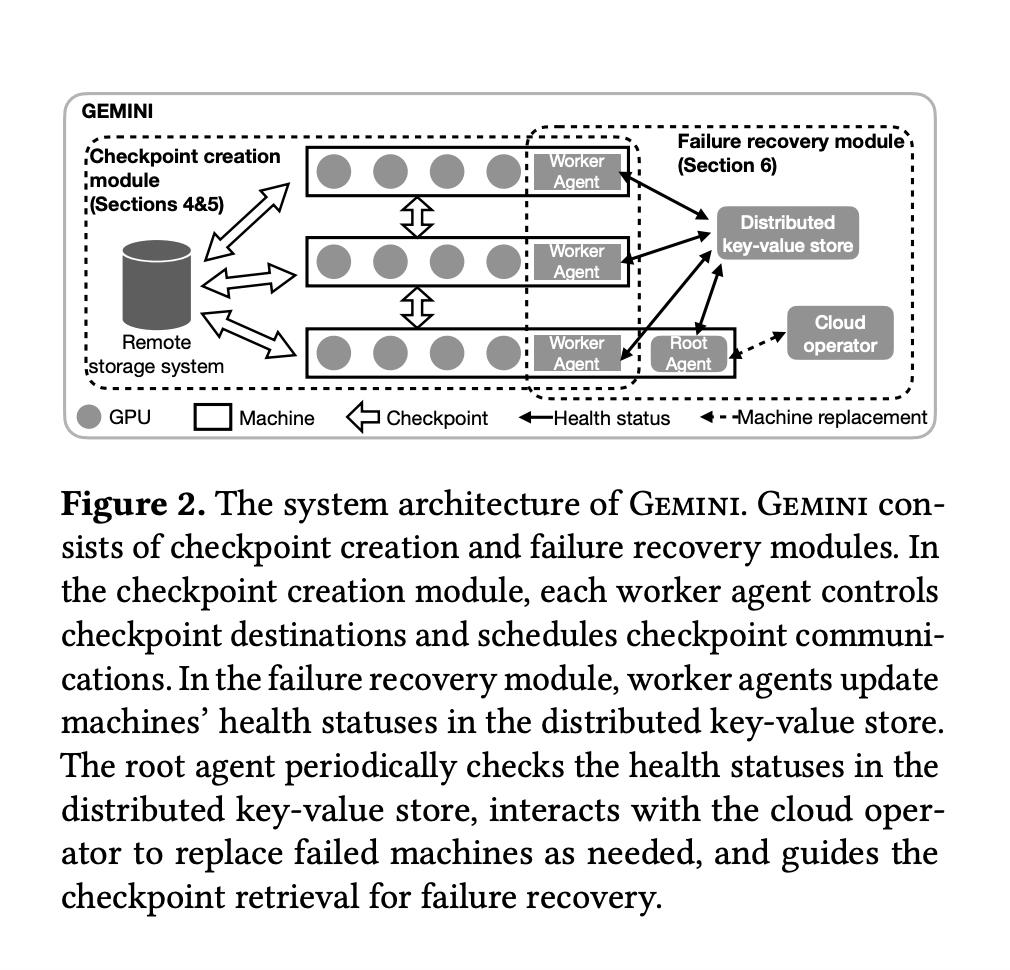
Un equipo de investigadores de la Universidad Rice y Amazon Web Services ha desarrollado un sistema de formación distribuida llamado GEMINI, cuyo objetivo es mejorar la recuperación de fallos en el entrenamiento de grandes modelos de aprendizaje automático. El sistema aborda los desafíos asociados con el uso de la memoria de la CPU para los puntos de control, lo que garantiza una mayor disponibilidad y minimiza la interferencia con el tráfico de entrenamiento. GEMINI ha mostrado una mejora significativa con respecto a las soluciones existentes, lo que la convierte en un avance prometedor en la capacitación de modelos de aprendizaje profundo a gran escala.
GEMINI ha introducido un sistema de formación distribuida para mejorar el proceso de recuperación en la formación de modelos grandes. Las soluciones anteriores estaban limitadas por restricciones de ancho de banda y almacenamiento, lo que afectaba la frecuencia de los puntos de control y la precisión del modelo a pesar de que los marcos de aprendizaje profundo como PyTorch y TensorFlow ofrecían interfaces de puntos de control. El enfoque de GEMINI optimiza la ubicación de los puntos de control y la programación del tráfico, lo que lo convierte en un avance valioso en este campo.
Los modelos de aprendizaje profundo, especialmente los de gran tamaño, han sido reconocidos por su impresionante rendimiento. Sin embargo, el entrenamiento de modelos grandes a menudo requiere mejoras debido a su complejidad y consumo de tiempo. Las soluciones actuales para la recuperación de fallas en el entrenamiento de modelos grandes se ven obstaculizadas por el ancho de banda limitado en el almacenamiento remoto, lo que resulta en costos de recuperación significativos. GEMINI ha introducido técnicas innovadoras de memoria de CPU que permiten una rápida recuperación de fallas. Las estrategias de GEMINI para la ubicación óptima de los puntos de control y la programación del tráfico han llevado a una recuperación de fallas significativamente más rápida que las soluciones existentes. Ha realizado contribuciones notables en el campo del aprendizaje profundo.
GEMINI se basa en Deep-Speed y utiliza la configuración ZeRO-3 para entrenamiento distribuido. Los grupos de Amazon EC2 Auto Scaling se utilizan para administrar los estados del modelo de GPU. Los puntos de control se almacenan tanto en la memoria de la CPU como en el almacenamiento remoto, con una frecuencia de control de tres horas. GEMINI emplea una estrategia de ubicación de puntos de control casi óptima para maximizar la probabilidad de recuperación y un algoritmo de programación de tráfico para reducir la interferencia. La evaluación se realiza en GPU NVIDIA pero se aplica a otros aceleradores como AWS Trainium.
GEMINI mejora significativamente la recuperación ante fallos, superando a las soluciones existentes en más de 13 veces. Los resultados de la evaluación confirman su eficacia para reducir la pérdida de tiempo sin comprometer el rendimiento de la formación. La escalabilidad de GEMINI es evidente en distintas frecuencias de fallas y escalas de capacitación, lo que muestra su potencial para la capacitación distribuida a gran escala. El algoritmo de entrelazado de tráfico en GEMINI influye positivamente en el rendimiento del entrenamiento, mejorando aún más la eficiencia del sistema.
Las soluciones existentes para la recuperación de fallas en el entrenamiento de modelos grandes están limitadas por el ancho de banda del almacenamiento remoto, lo que evita altas frecuencias de puntos de control y genera una pérdida de tiempo significativa. El estudio se centra en el entrenamiento estático y sincrónico con recursos computacionales fijos, omitiendo la consideración de métodos de entrenamiento elásticos y asincrónicos. La cuestión del tamaño de la memoria de la CPU para almacenar el historial de puntos de control para fines distintos de la recuperación de fallas no se aborda en la investigación actual.
En conclusión, GEMINI es un sistema de capacitación distribuido eficiente y escalable que ofrece una recuperación de fallas rápida y confiable mediante puntos de control de la memoria de la CPU y una estrategia de ubicación avanzada. Sus altas frecuencias de puntos de control ayudan a reducir la pérdida de tiempo sin afectar el rendimiento del entrenamiento, lo que la convierte en una excelente solución para el entrenamiento distribuido a gran escala en clústeres de GPU.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 32k+ ML, Comunidad de Facebook de más de 40.000 personas, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
también estamos en Telegrama y WhatsApp.
A Sana Hassan, pasante de consultoría en Marktechpost y estudiante de doble titulación en IIT Madras, le apasiona aplicar la tecnología y la inteligencia artificial para abordar los desafíos del mundo real. Con un gran interés en resolver problemas prácticos, aporta una nueva perspectiva a la intersección de la IA y las soluciones de la vida real.