
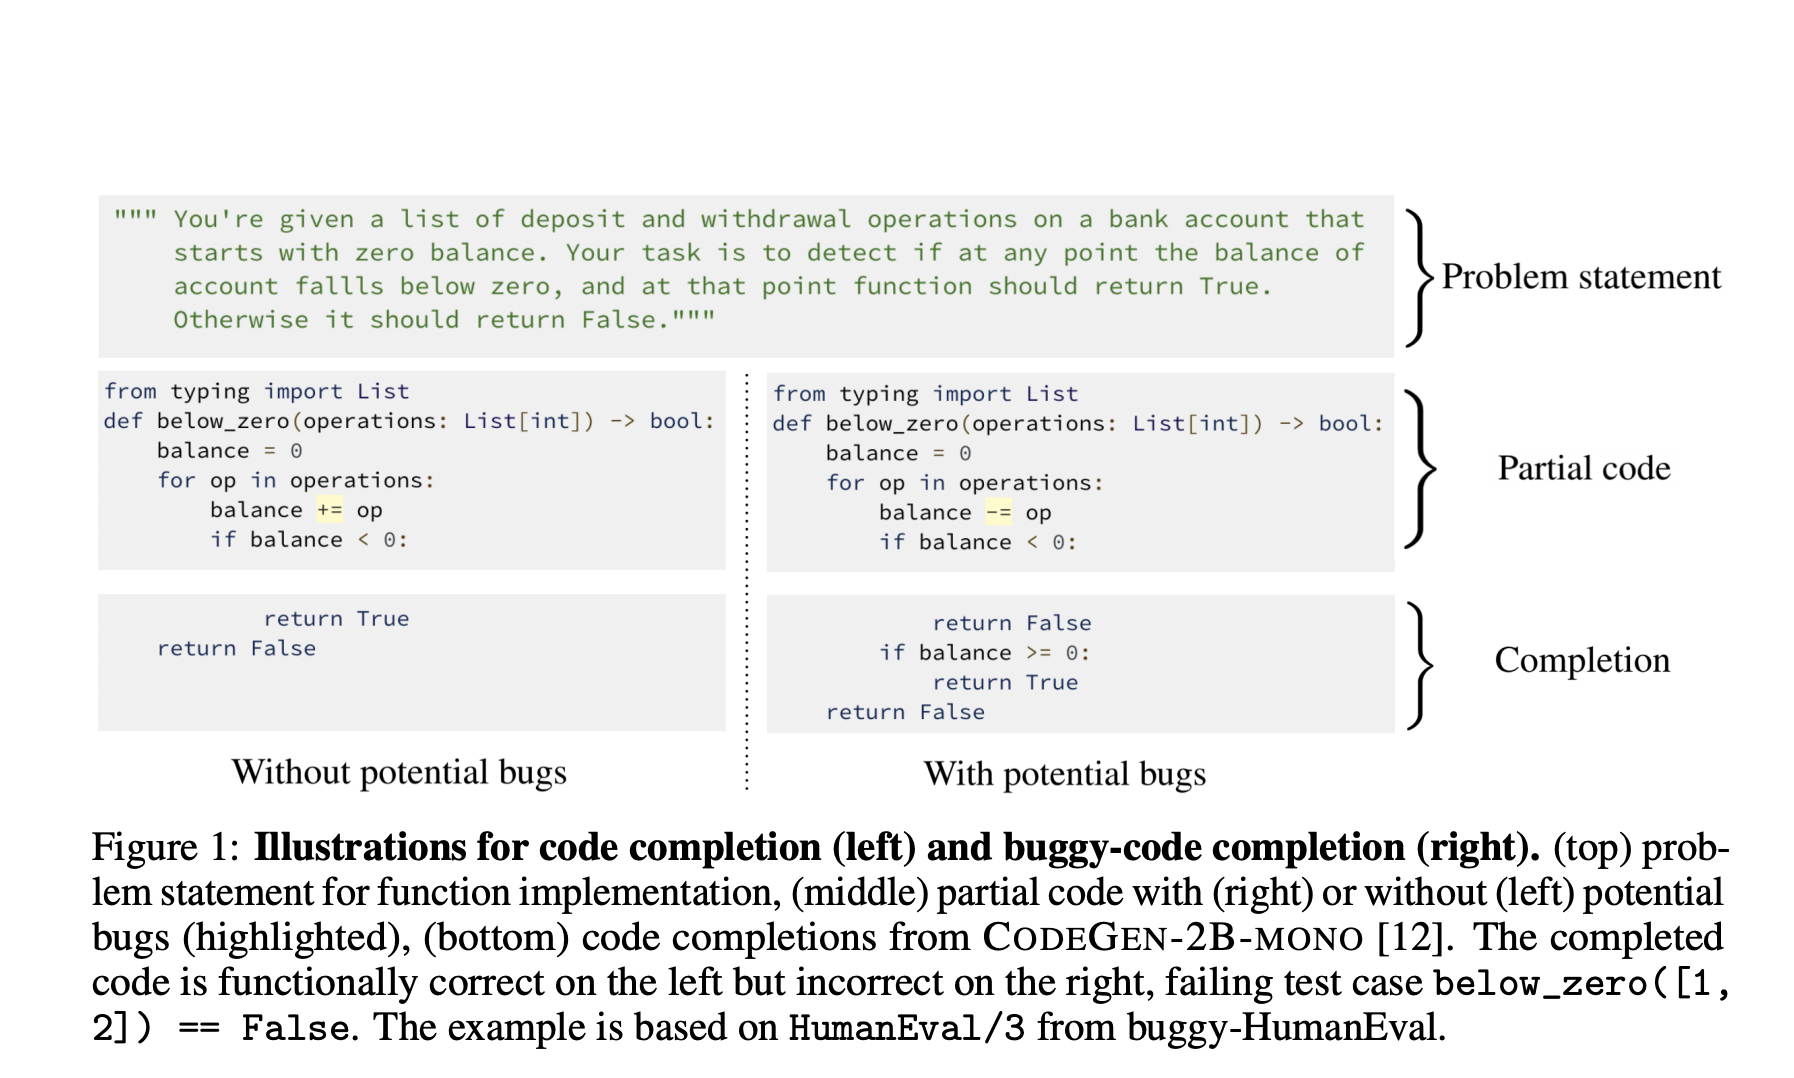
La programación puede ser compleja y, a veces, es posible escribir código sin errores. Se han desarrollado modelos de código de lenguaje grande (Code-LLM) para ayudar a completar el código, pero a veces pueden pasar por alto errores en el contexto del código. Para abordar este problema, investigadores de la Universidad de Wisconsin-Madison y Amazon Web Services realizaron un estudio para mejorar el rendimiento de los LLM en la detección de posibles errores durante la generación de código.
La investigación en reparación automática de programas, aprovechando Code-LLM, tiene como objetivo aliviar la carga de identificar y corregir errores de programación. Al igual que en los ejemplos contradictorios en otros dominios, las pequeñas transformaciones de código que preservan la semántica pueden degradar el rendimiento de los modelos de aprendizaje de código. Los puntos de referencia existentes como CodeXGLUE, CodeNet y HumanEval han sido fundamentales para estudiar la finalización de código y la reparación de programas. Para mejorar la disponibilidad de datos, los métodos sintetizan errores artificiales a través de código mutantes o aprenden a crear errores.
La finalización de código, una característica crucial en los entornos de desarrollo integrados, ha experimentado avances con los modelos de código de lenguaje basados en Transformer. Sin embargo, estos modelos a menudo pasan por alto la presencia de errores, algo común en el desarrollo de software. La investigación introduce el concepto de finalización de código con errores (bCC), donde los errores potenciales están presentes en el contexto del código, explorando el comportamiento de Code-LLM en tales escenarios. Se introducen conjuntos de datos de referencia, buggy-HumanEval y buggy-FixEval, para evaluar Code-LLM en presencia de errores sintéticos y realistas, lo que revela una degradación significativa del rendimiento. Se exploran métodos posteriores a la mitigación para abordar este problema.
Los métodos de mitigación propuestos incluyen la eliminación y luego la finalización, la eliminación de fragmentos con errores; Finalización y reescritura, corrección de errores después de la finalización con modelos como RealiT; y Reescritura y finalización, que resuelve errores reescribiendo líneas de código antes de finalizar. El rendimiento, medido por las tasas de aprobación, favorece la finalización y luego reescritura y la reescritura y luego finalización. Los Code-LLM como RealiT e INCODER-6B funcionan como reparadores de código, completando modelos de lenguaje en estos métodos.
La presencia de errores potenciales degrada sustancialmente el rendimiento de generación de Code-LLM, con una caída de más del 50% en las tasas de aprobación de un solo error. Con el conocimiento de la ubicación de errores, el Oráculo heurístico muestra una brecha de rendimiento notable entre buggy-HumanEval y buggy-FixEval, lo que enfatiza la importancia de la ubicación de errores. Los métodos basados en probabilidades muestran un rendimiento diverso en los dos conjuntos de datos, lo que sugiere que la naturaleza del error influye en la elección del método de agregación. Los métodos posteriores a la mitigación, incluida la eliminación y luego finalización y la reescritura y finalización, ofrecen mejoras en el rendimiento. Aún así, existe una brecha que indica la necesidad de realizar más investigaciones para mejorar la finalización del código con posibles errores.
En resumen, la investigación realizada se puede presentar en los siguientes puntos:
- La investigación introduce una nueva tarea llamada bCC.
- bCC genera implementaciones funcionales a partir de un contexto de código con posibles errores.
- El estudio se evalúa en dos conjuntos de datos denominados buggy-HumanEval y buggy-FixEval.
- El rendimiento de Code-LLM se degrada significativamente, con tasas de aprobación de casos de prueba que caen por debajo del 5%.
- Se proponen métodos posteriores a la mitigación, incluida la eliminación y luego finalización y la reescritura y luego finalización, pero persisten las brechas de desempeño.
- Este trabajo mejora la comprensión de Code-LLM en bCC.
- La investigación sugiere formas de mejorar la finalización del código en presencia de errores potenciales.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 34k+ ML, 41k+ comunidad de Facebook, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
Hola, mi nombre es Adnan Hassan. Soy pasante de consultoría en Marktechpost y pronto seré aprendiz de gestión en American Express. Actualmente estoy cursando una doble titulación en el Instituto Indio de Tecnología, Kharagpur. Me apasiona la tecnología y quiero crear nuevos productos que marquen la diferencia.