
Los modelos fundamentales o fundamentales de visión se utilizan en tareas de visión por computadora. Estos modelos sirven como bloques de construcción o marcos iniciales para modelos más complejos y específicos. Los investigadores y desarrolladores a menudo los utilizan como puntos de partida y los adaptan o mejoran para abordar desafíos específicos u optimizar aplicaciones particulares.
Los modelos de visión se extienden a datos de vídeo para el reconocimiento de acciones, subtítulos de vídeo y detección de anomalías en imágenes de vigilancia. Su adaptabilidad y eficacia en el manejo de diversas tareas de visión por computadora los convierten en parte integral de las aplicaciones modernas de IA.
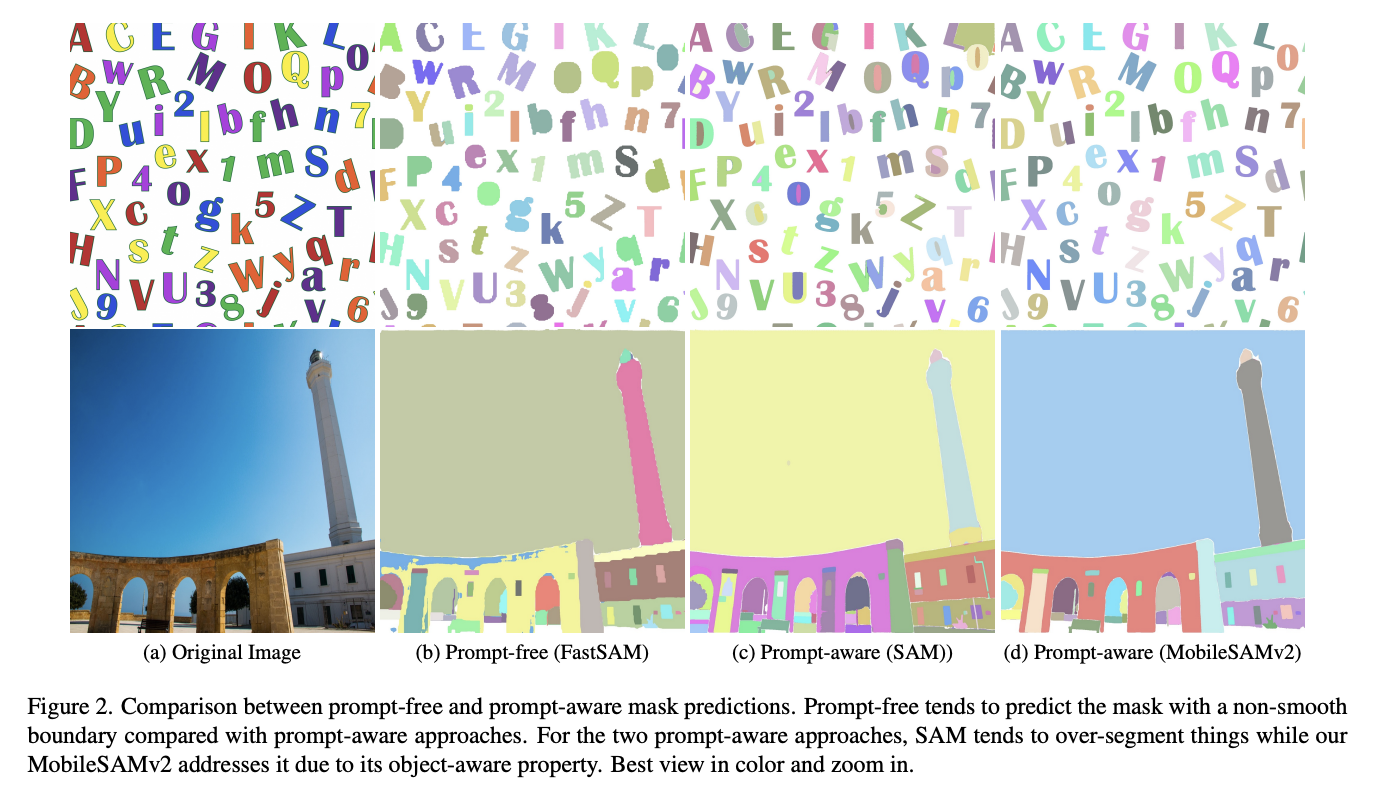
Los investigadores de la Universidad Kyung Hee resuelven los problemas en uno de esos modelos de visión llamado Sam (Segmentar cualquier modelo). Su método resuelve dos desafíos prácticos de segmentación de imágenes: segmentar cualquier cosa (SegAny) y todo (SegEvery). Como sugiere el nombre, SegAny utiliza solo un mensaje determinado para segmentar un único elemento de interés en la imagen, mientras que SegEvery segmenta todos los elementos de la imagen.
SAM consta de un codificador de imágenes basado en ViT y un decodificador de máscara guiado por indicaciones. El decodificador de máscaras genera máscaras detalladas adoptando atención bidireccional para permitir una interacción eficiente entre codificadores de imágenes. SegEvery no es una tarea de segmentación que se puede solicitar, por lo que genera imágenes directamente mediante solicitudes.
Los investigadores identifican por qué SegEvery en SAM es lento y proponen mensajes de cuadro con reconocimiento de objetos. Estas indicaciones se utilizan en lugar de las indicaciones predeterminadas de puntos de búsqueda de cuadrícula, lo que aumenta significativamente la velocidad de generación de imágenes. Muestran que la estrategia de muestreo rápido de object-ware es compatible con los codificadores de imágenes destiladas en MobileSAM. Esto contribuirá aún más a un marco unificado para SegAny y SegEvery eficientes.
Su investigación se centra principalmente en determinar si un objeto se encuentra en una determinada región de la imagen. Las tareas de detección de objetos ya resuelven este problema, pero la mayoría de los cuadros delimitadores generados se superponen. Requiere un filtrado previo antes de usarlo como un mensaje válido para eliminar la superposición.
El desafío con el mensaje de punto dado radica en la necesidad de pronosticar tres máscaras de salida, con el objetivo de abordar la ambigüedad, lo que exige un mayor filtrado de máscaras. Por el contrario, el mensaje de cuadro destaca por su capacidad de proporcionar información más detallada, generando máscaras de calidad superior con ambigüedad reducida. Esta característica alivia el requisito de predecir tres máscaras, lo que la convierte en una opción más ventajosa para SegEvery debido a su eficiencia.
En conclusión, su investigación se centra en MobileSAMv2 y mejora la velocidad de SegEvery mediante la introducción de un innovador método de muestreo rápido dentro del decodificador de máscara guiado por señales. Al reemplazar el enfoque convencional de búsqueda en cuadrícula con su técnica de muestreo rápido con reconocimiento de objetos, mejoran notablemente la eficiencia de SegEvery sin comprometer el rendimiento general, mostrando mejoras significativas.
Revisar la Papel y GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 34k+ ML, 41k+ comunidad de Facebook, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
Arshad es pasante en MarktechPost. Actualmente cursa su carrera internacional. Maestría en Física del Instituto Indio de Tecnología Kharagpur. Comprender las cosas hasta el nivel fundamental conduce a nuevos descubrimientos que conducen al avance de la tecnología. Le apasiona comprender la naturaleza fundamentalmente con la ayuda de herramientas como modelos matemáticos, modelos de aprendizaje automático e inteligencia artificial.