
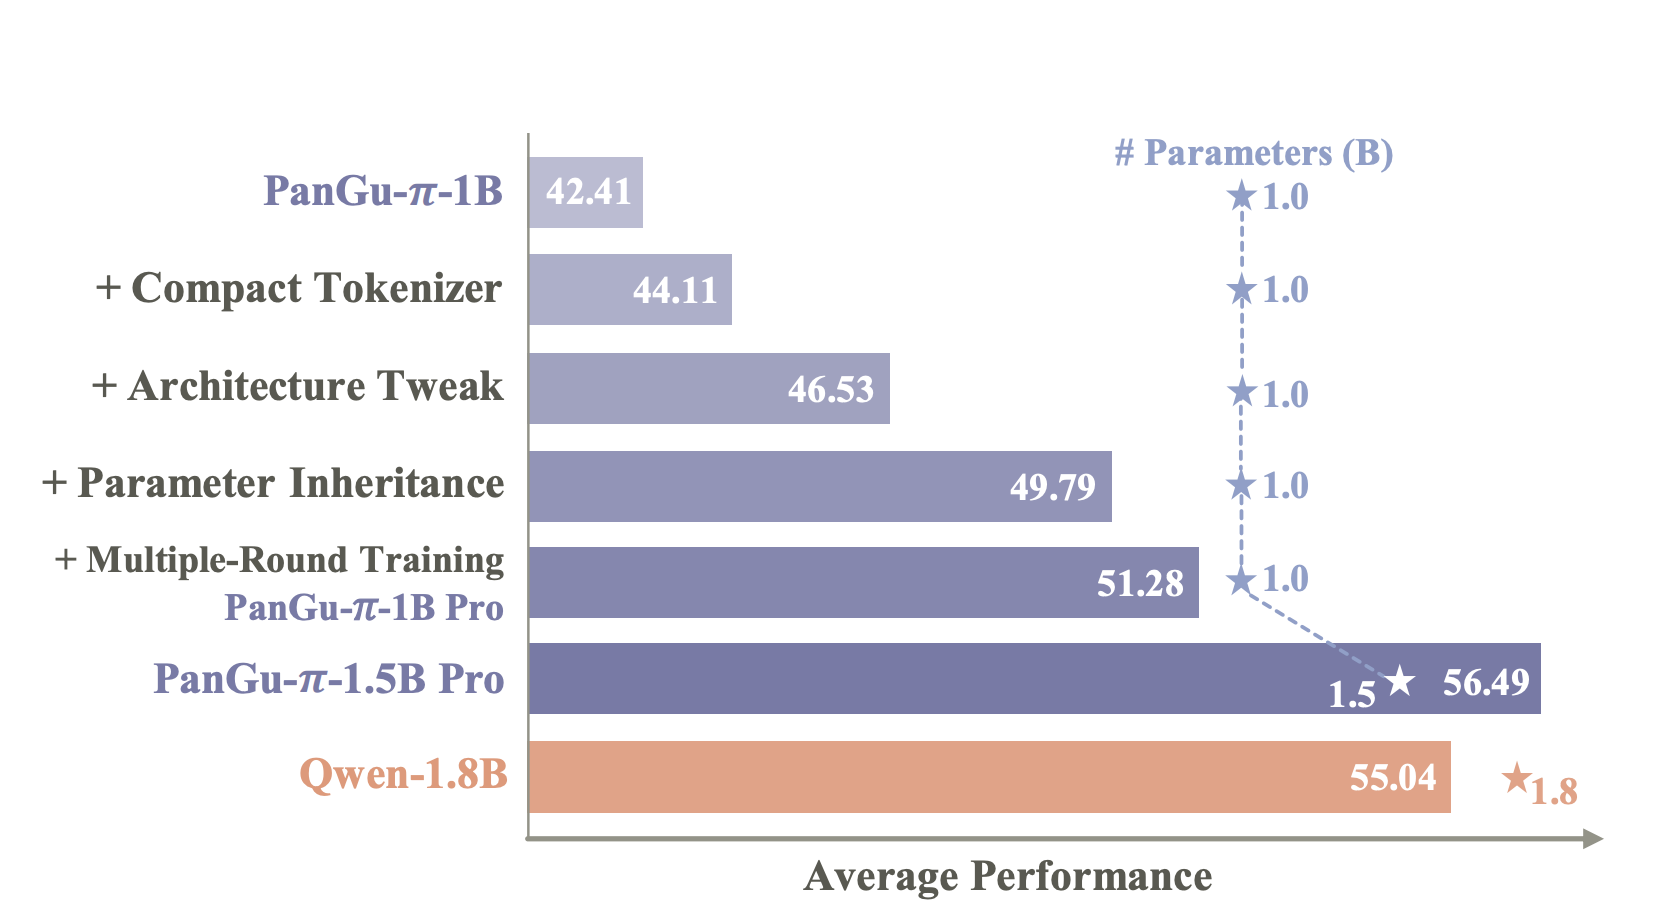
Un estudio innovador realizado por investigadores del Ark Lab de Huawei Noah, en colaboración con la Universidad de Pekín y Huawei Consumer Business Group, presenta un enfoque transformador para desarrollar modelos de lenguaje diminuto (TLM) adecuados para dispositivos móviles. A pesar de su tamaño reducido, estos modelos compactos pretenden ofrecer un rendimiento a la par de sus homólogos más grandes, abordando la necesidad crucial de aplicaciones de IA eficientes en entornos con recursos limitados.
El equipo de investigación abordó el apremiante desafío de optimizar los modelos lingüísticos para la implementación móvil. Los modelos tradicionales de lenguaje grande, aunque potentes, podrían ser más prácticos para uso móvil debido a sus importantes requisitos computacionales y de memoria. Este estudio presenta un innovador modelo de lenguaje pequeño, PanGu-π Pro, que aprovecha una arquitectura meticulosamente diseñada y metodologías de capacitación avanzadas para lograr una eficiencia y efectividad notables.
En el centro de su metodología se encuentra la optimización estratégica de los componentes del modelo. El equipo se embarcó en una serie de estudios empíricos para analizar el impacto de varios elementos en el rendimiento del modelo. Una innovación notable es la compresión del tokenizador, que reduce significativamente el tamaño del modelo sin comprometer su capacidad para comprender y generar lenguaje. Además, se realizaron ajustes arquitectónicos para optimizar el modelo, incluida la herencia de parámetros de modelos más grandes y una estrategia de capacitación de múltiples rondas que mejora la eficiencia del aprendizaje.

La introducción de PanGu-π Pro en versiones de parámetros 1B y 1.5B marca un importante avance. Siguiendo los protocolos de optimización recientemente establecidos, los modelos se entrenaron en un corpus multilingüe de 1,6 T. Los resultados fueron asombrosos; PanGu-π-1B Pro demostró una mejora promedio de 8,87 en conjuntos de evaluación de referencia. Lo más impresionante es que PanGu-π-1.5B Pro superó varios modelos de última generación con tamaños más grandes, estableciendo nuevos puntos de referencia de rendimiento en modelos de lenguaje compacto.
Las implicaciones de esta investigación se extienden mucho más allá del ámbito de los dispositivos móviles. Al lograr un equilibrio tan delicado entre tamaño y rendimiento, el equipo de Huawei ha abierto nuevas vías para implementar tecnologías de IA en diversos escenarios donde los recursos computacionales son limitados. Su trabajo no sólo allana el camino para aplicaciones de IA más accesibles, sino que también sienta un precedente para futuras investigaciones sobre la optimización de modelos lingüísticos.
Los hallazgos de este estudio son un testimonio de las posibilidades inherentes a la IA y muestran cómo los enfoques innovadores pueden superar las limitaciones de las tecnologías actuales. Las contribuciones del equipo de Huawei están preparadas para revolucionar la forma en que pensamos e interactuamos con la IA, haciéndola más ubicua e integrada en nuestra vida diaria. A medida que avancemos, los principios y metodologías desarrollados en esta investigación sin duda influirán en la evolución de las tecnologías de IA, haciéndolas más adaptables, eficientes y accesibles para todos.
Revisar la Papel y GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y noticias de Google. Unirse nuestro SubReddit de 36k+ ML, 41k+ comunidad de Facebook, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Canal de telegramas

Muhammad Athar Ganaie, pasante de consultoría en MarktechPost, es un defensor del aprendizaje profundo eficiente, con especial atención en la capacitación dispersa. Cursando un M.Sc. en Ingeniería Eléctrica, con especialización en Ingeniería de Software, combina conocimientos técnicos avanzados con aplicaciones prácticas. Su esfuerzo actual es su tesis sobre “Mejora de la eficiencia en el aprendizaje por refuerzo profundo”, que muestra su compromiso de mejorar las capacidades de la IA. El trabajo de Athar se encuentra en la intersección “Capacitación escasa en DNN” y “Aprendizaje por refuerzo profundo”.