
La generación de texto a imagen (T2I) y texto a video (T2V) ha logrado avances significativos en los modelos generativos. Si bien los modelos T2I pueden controlar bien la identidad del sujeto, ampliar esta capacidad al T2V sigue siendo un desafío. Los métodos T2V existentes necesitan un control más preciso sobre el contenido generado, en particular la generación de identidades específicas para escenarios relacionados con humanos. Los esfuerzos para aprovechar los avances de T2I para la generación de video necesitan ayuda para mantener identidades consistentes y fondos estables en todos los fotogramas. Estos desafíos surgen de diversas imágenes de referencia que influyen en los tokens de identidad y la lucha de los módulos de movimiento para garantizar la coherencia temporal en medio de diferentes entradas de identidad.
Investigadores de ByteDance Inc. y UC Berkeley han desarrollado Video Custom Diffusion (VCD), un marco sencillo pero potente para generar videos controlables por identidad de sujetos. VCD emplea tres componentes clave: un módulo de identificación para una extracción de identidad precisa, un ruido previo gaussiano 3D para la coherencia entre fotogramas y módulos V2V para mejorar la calidad del vídeo. Al separar la información de identidad del ruido de fondo, VCD alinea las identificaciones con precisión, garantizando salidas de vídeo estables. La flexibilidad del marco le permite funcionar sin problemas con varios modelos de contenido generados por IA. Las contribuciones incluyen avances significativos en la generación de videos específicos de identificación, técnicas sólidas de eliminación de ruido, mejora de la resolución y un enfoque de capacitación para la mitigación del ruido en tokens de identificación.
En los modelos generativos, los avances de la generación T2I han dado lugar a modelos personalizables capaces de crear retratos realistas y composiciones imaginativas. Técnicas como Textual Inversion y DreamBooth ajustan los modelos previamente entrenados con imágenes de temas específicos, generando identificadores únicos vinculados a los temas deseados. Este progreso se extiende a la generación de múltiples sujetos, donde los modelos aprenden a componer múltiples sujetos en imágenes únicas. La transición a la generación T2V presenta nuevos desafíos debido a la necesidad de coherencia espacial y temporal entre fotogramas. Si bien los primeros métodos utilizaban GAN y VAE para videos de baja resolución, los enfoques recientes emplearon modelos de difusión para resultados de mayor calidad.
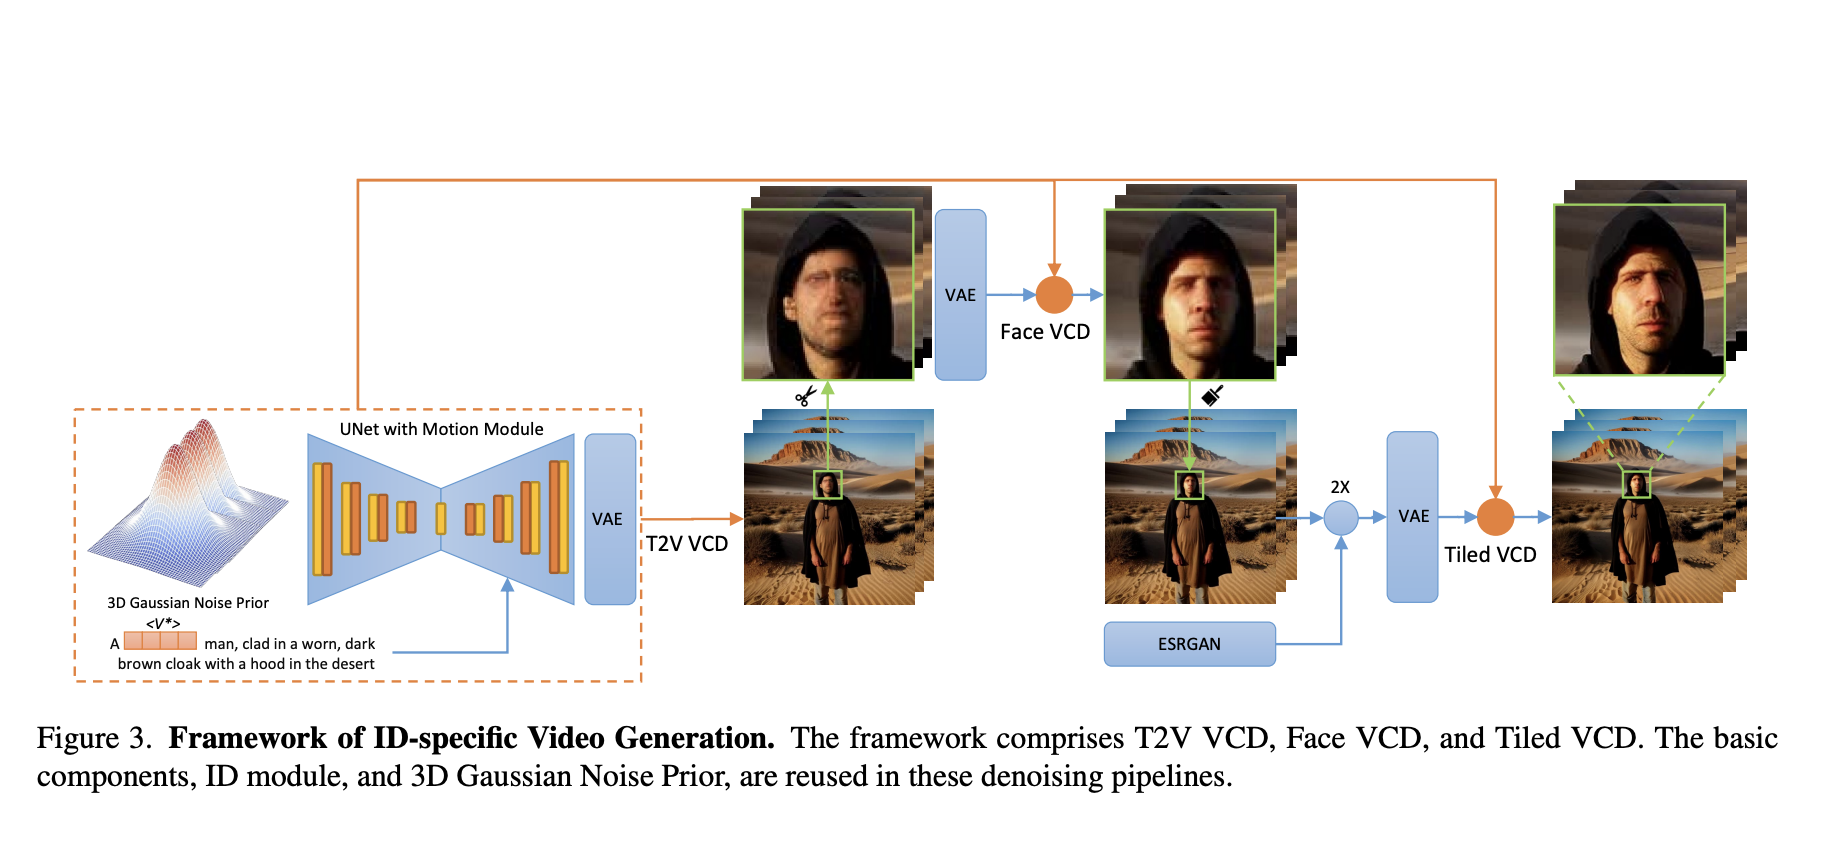
En el marco VCD se han utilizado un módulo de preprocesamiento, un módulo de identificación y un módulo de movimiento. Además, un módulo ControlNet Tile opcional muestra videos para obtener una resolución más alta. VCD mejora un módulo de movimiento disponible en el mercado con un ruido gaussiano 3D antes de mitigar el sesgo de exposición durante la inferencia. El módulo de identificación incorpora tokens de identificación extendidos con pérdida enmascarada y segmentación rápida, lo que elimina eficazmente el ruido de fondo. El estudio también menciona dos canalizaciones de VCD V2V: Face VCD, que mejora los rasgos faciales y la resolución, y Tiled VCD, que mejora aún más el vídeo preservando los detalles de identidad. Estos módulos garantizan colectivamente una generación de vídeo de alta calidad que preserva la identidad.

El modelo VCD mantiene la identidad del personaje en varios modelos realistas y estilizados. Los investigadores seleccionaron meticulosamente sujetos de diversos conjuntos de datos y evaluaron el método frente a múltiples líneas de base utilizando CLIP-I y DINO para la alineación de la identidad, la alineación del texto y la suavidad temporal. Los detalles de la capacitación implicaron el uso de Stable Diffusion 1.5 para el módulo de identificación y ajustar las tasas de aprendizaje y los tamaños de lote en consecuencia. El estudio obtuvo datos de los conjuntos de datos DreamBooth y CustomConcept101 y evaluó el rendimiento del modelo frente a varias métricas. El estudio destacó el papel fundamental del módulo de segmentación y previo de ruido gaussiano 3D para mejorar la fluidez del vídeo y la alineación de la imagen. Realistic Vision en general superó a Stable Diffusion, lo que subraya la importancia de la selección del modelo.
En conclusión, VCD revoluciona la generación de videos controlables por identidad del sujeto al integrar perfectamente la información de identidad y la correlación de cuadros. A través de componentes innovadores como el módulo de identificación, entrenado con segmentación rápida para desenredar la identidad con precisión, y el módulo VCD T2V para mejorar la consistencia del cuadro, VCD establece un nuevo punto de referencia para la preservación de la identidad en video. Su adaptabilidad con los modelos existentes de texto a imagen mejora la practicidad. Con características como los módulos VCD 3D Gaussian Noise Prior y Face/Tiled, VCD garantiza estabilidad, claridad y mayor resolución. Amplios experimentos confirman su superioridad sobre los métodos existentes, lo que lo convierte en una herramienta indispensable para generar vídeos estables y de alta calidad con identidad preservada.
Revisar la Papel, GitHuby Proyecto. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y noticias de Google. Unirse nuestro SubReddit de 38k+ ML, 41k+ comunidad de Facebook, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Canal de telegramas
También te puede gustar nuestro Cursos GRATUITOS de IA….

A Sana Hassan, pasante de consultoría en Marktechpost y estudiante de doble titulación en IIT Madras, le apasiona aplicar la tecnología y la inteligencia artificial para abordar los desafíos del mundo real. Con un gran interés en resolver problemas prácticos, aporta una nueva perspectiva a la intersección de la IA y las soluciones de la vida real.