
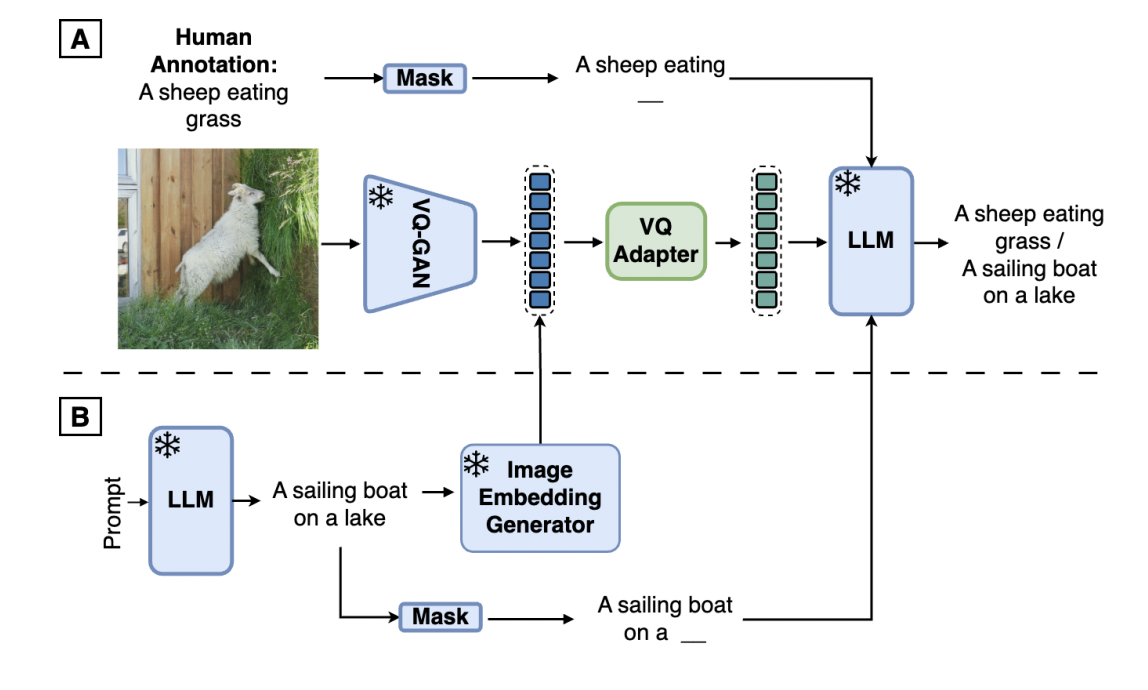
Los VLM son herramientas potentes para captar datos visuales y textuales, lo que promete avances en tareas como los subtítulos de imágenes y la respuesta visual a preguntas. La disponibilidad limitada de datos obstaculiza su desempeño. Los avances recientes muestran que el entrenamiento previo de VLM en conjuntos de datos de imágenes y texto más grandes mejora las tareas posteriores. Sin embargo, la creación de dichos conjuntos de datos enfrenta desafíos: escasez de datos emparejados, altos costos de curación, baja diversidad y datos ruidosos provenientes de Internet.
Estudios anteriores demuestran la eficacia de los VLM en tareas como subtítulos de imágenes, utilizando diversas arquitecturas y estrategias de preentrenamiento. Los avances recientes en generadores de imágenes de alta calidad han despertado el interés en el uso de modelos generativos para la generación de datos sintéticos. Esta tendencia afecta varias tareas de visión por computadora, incluida la segmentación semántica, la comprensión del movimiento humano y la clasificación de imágenes. Este estudio también explora la integración de modelos generativos basados en datos dentro de VLM, enfatizando la eficiencia al generar incrustaciones de imágenes directamente integradas en el modelo, mostrando superioridad sobre los enfoques existentes.
Los investigadores de Google DeepMind han propuesto Sintetizador2. Este método aprovecha modelos de imágenes y texto generativos previamente entrenados para crear datos emparejados sintéticos para VLM, abordando los desafíos de escasez de datos, costos y ruido. Genera texto e imágenes de forma sintética, evitando depender de datos del mundo real. El enfoque opera a nivel de incrustación, evitando la costosa renderización del espacio de píxeles, mejorando así la eficiencia sin comprometer el rendimiento. El entrenamiento previo del modelo de texto a imagen en el mismo conjunto de datos utilizado para el entrenamiento de VLM garantiza una evaluación justa y evita la transferencia de conocimientos no deseada.
Synth2 aprovecha modelos de imágenes y texto generativos previamente entrenados para crear datos emparejados sintéticos para el entrenamiento de VLM. Incluye componentes para Generación de subtítulos, que utilizan LLM con indicaciones basadas en clases para diversos subtítulos, y Generación de imágenes, que emplea un generador controlado de texto a imagen entrenado en el mismo conjunto de datos que el VLM para garantizar una evaluación justa. La arquitectura Synth2 VLM integra redes troncales VQ-GAN para una interacción eficiente con incrustaciones de imágenes generadas sintéticamente, evitando el procesamiento del espacio de píxeles y permitiendo un entrenamiento perfecto. Además, un componente Perceiver Resampler facilita la atención cruzada entre tokens VQ y tokens de idioma en VLM, lo que ayuda a lograr representaciones multimodales efectivas.
Al evaluar imágenes sintéticas para el entrenamiento de VLM, Synth2 mejora significativamente el rendimiento con respecto a las líneas de base, incluso con un volumen menor de imágenes anotadas por humanos. Las imágenes sintéticas sustituyen eficazmente a las reales, mejorando las capacidades de VLM. Synth2 también supera a métodos de última generación como ITIT y DC, logrando resultados competitivos con un uso reducido de datos y recursos computacionales. Esto resalta la efectividad y eficiencia de Synth2 para mejorar el rendimiento de VLM.
En conclusión, los investigadores de Google DeepMind propusieron Synth2, que utiliza pares sintéticos de imagen y texto para mejorar el entrenamiento de VLM. Los resultados muestran un rendimiento de VLM mejorado en comparación con las líneas de base, con una mayor eficiencia y escalabilidad de los datos. Este método ofrece personalización para dominios específicos y aborda los desafíos de adquisición de datos que requieren muchos recursos. Los hallazgos subrayan el potencial de la generación de datos sintéticos para mejorar la comprensión del lenguaje visual, lo que sugiere vías para una mayor exploración.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 38k+ ML

Asjad es consultor interno en Marktechpost. Está cursando B.Tech en ingeniería mecánica en el Instituto Indio de Tecnología, Kharagpur. Asjad es un entusiasta del aprendizaje automático y el aprendizaje profundo que siempre está investigando las aplicaciones del aprendizaje automático en la atención médica.