
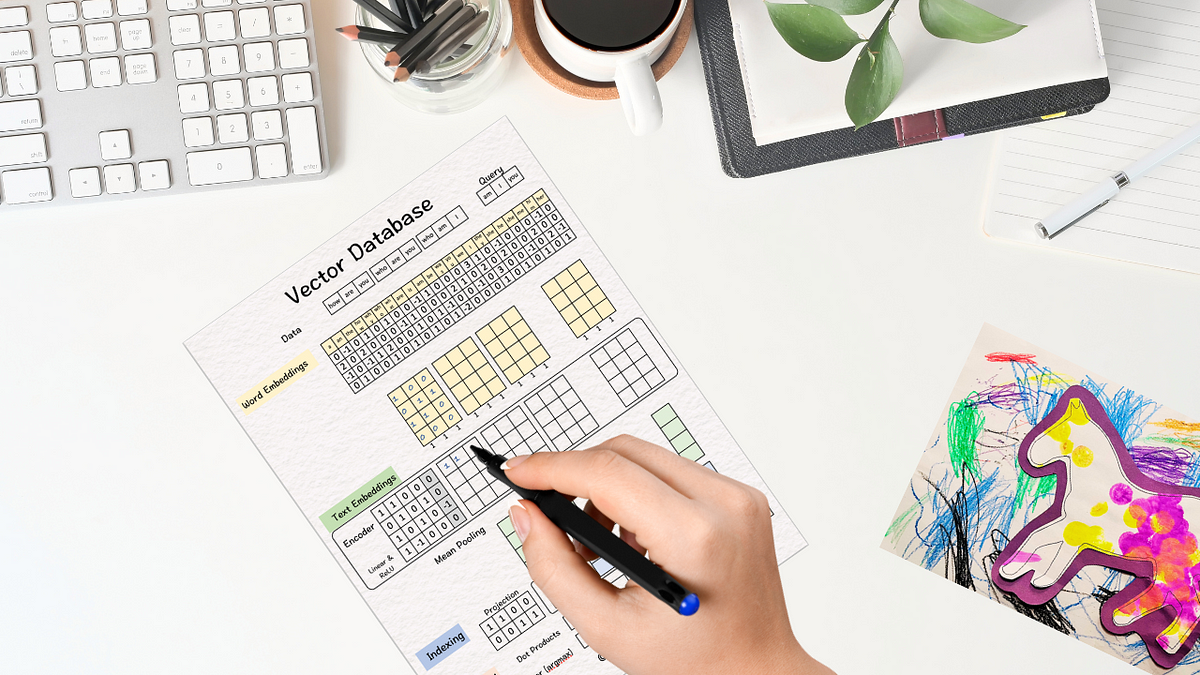

El otro día le pedí a mi modelo de lenguaje grande (LLM) favorito que me ayudara a explicarle los vectores a mi hijo de casi 4 años. En segundos, escupió una historia llena de criaturas míticas, magia y vectores. ¡Y voilá! Tenía un boceto para un nuevo libro infantil y era impresionante porque el unicornio se llamaba ‘LuminaVec’.
Entonces, ¿cómo ayudó el modelo a tejer esta magia creativa? Bueno, la respuesta es mediante el uso de vectores (en la vida real) y probablemente bases de datos vectoriales. ¿Cómo es eso? Dejame explicar.
Primero, el modelo no entiende las palabras exactas que escribí. Lo que le ayuda a entender las palabras son sus representaciones numéricas que tienen la forma de vectores. Estos vectores ayudan al modelo a encontrar similitudes entre las diferentes palabras mientras se centran en información significativa sobre cada una. Lo hace mediante el uso incrustaciones los cuales son vectores de baja dimensión que intentan capturar la semántica y el contexto de la información.
En otras palabras, los vectores en una incrustación son listas de números que especifican la posición de un objeto con respecto a un espacio de referencia. Estos objetos pueden ser características que definen una variable en un conjunto de datos. Con la ayuda de estos valores vectoriales numéricos, podemos determinar qué tan cerca o qué tan lejos está una característica de la otra: ¿son similares (cercanas) o no similares (lejos)?
Ahora bien, estos vectores son bastante poderosos, pero cuando hablamos de LLM, debemos tener mucho cuidado con ellos debido a la palabra “grande”. Como ocurre con estos modelos “grandes”, estos vectores pueden volverse rápidamente largos y más complejos, abarcando cientos o incluso miles de dimensiones. Si no se trata con cuidado, la velocidad de procesamiento y los gastos de montaje podrían volverse engorrosos muy rápidamente.
Para abordar este problema, contamos con nuestro poderoso guerrero: las bases de datos vectoriales.
Bases de datos vectoriales son bases de datos especiales que contienen estas incrustaciones de vectores. Los objetos similares tienen vectores más cercanos entre sí en la base de datos de vectores, mientras que los objetos diferentes tienen vectores más alejados. Entonces, en lugar de analizar los datos cada vez que llega una consulta y generar estas incrustaciones de vectores, lo que induce enormes recursos, es mucho más rápido ejecutar los datos a través del modelo una vez, almacenarlos en la base de datos de vectores y recuperarlos según sea necesario. Esto convierte a las bases de datos vectoriales en una de las soluciones más poderosas para abordar el problema de escala y velocidad de estos LLM.
Entonces, volviendo a la historia sobre el unicornio arcoíris, la magia brillante y los vectores poderosos, cuando le hice esa pregunta al modelo, es posible que haya seguido un proceso como este:
- El modelo de incrustación primero transformó la pregunta en una incrustación vectorial.
- Esta incorporación de vectores se comparó luego con las incorporaciones en las bases de datos de vectores relacionadas con historias divertidas para niños de 5 años y vectores.
- En base a esta búsqueda y comparación, se devolvieron los vectores más similares. El resultado debería haber consistido en una lista de vectores clasificados en orden de similitud con el vector de consulta.
Para resumir las cosas aún más, ¿qué tal si damos un paseo para resolver estos pasos en el nivel micro? ¡Es hora de volver a lo básico! Gracias al Prof. Tom Yeh, hemos esta hermosa obra eso explica el funcionamiento detrás de escena de los vectores y las bases de datos de vectores. (Todas las imágenes a continuación, a menos que se indique lo contrario, son del profesor Tom Yeh de la publicación de LinkedIn mencionada anteriormente, que edité con su permiso).
Así que, aquí vamos:
Para nuestro ejemplo, tenemos un conjunto de datos de tres oraciones con 3 palabras (o tokens) para cada una.
- Cómo estás
- Quién eres
- Quién soy
Y nuestra consulta es la frase ‘soy tú’.
En la vida real, una base de datos puede contener miles de millones de oraciones (piense en Wikipedia, archivos de noticias, artículos de revistas o cualquier colección de documentos) con decenas de miles de tokens como máximo. Ahora que el escenario está listo, que comience el proceso:
[1] incrustar : El primer paso es generar incrustaciones de vectores para todo el texto que queremos usar. Para ello, buscamos nuestras palabras correspondientes en una tabla de 22 vectores, donde 22 es el tamaño del vocabulario para nuestro ejemplo.
En la vida real, el tamaño del vocabulario puede ser de decenas de miles. Las dimensiones de incrustación de palabras se cuentan por miles (por ejemplo, 1024, 4096).
Buscando las palabras Cómo estás en el vocabulario, la palabra incrustación tiene este aspecto:
[2] Codificación : El siguiente paso es codificar la incrustación de palabras para obtener una secuencia de vectores de características, uno por palabra. Para nuestro ejemplo, el codificador es un perceptrón simple que consta de una capa lineal con una función de activación ReLU.
Un resumen rápido:
Transformación lineal : El vector de incrustación de entrada se multiplica por la matriz de peso W y luego se suma con el vector de sesgo b,
z = W.x+bdónde W. es la matriz de peso, x es nuestra incrustación de palabras y b es el vector de sesgo.
Función de activación ReLU : A continuación, aplicamos ReLU a esta z intermedia.
ReLU devuelve el máximo por elementos de la entrada y cero. Matemáticamente, h = máx{0,z}.
Por lo tanto, para este ejemplo, la incrustación de texto se ve así:
Para mostrar cómo funciona, calculemos los valores de la última columna como ejemplo.
Transformación lineal :
[1.0 + 1.1 + 0.0 +0.0] + 0 = 1
[0.0 + 1.1 + 0.0 + 1.0] + 0 = 1
[1.0 + (0).1+ 1.0 + 0.0] + (-1) = -1
[1.0 + (-1).1+ 0.0 + 0.0] + 0 = -1
ReLU
máximo {0,1} =1
máximo {0,1} = 1
máximo {0,-1} = 0
máximo {0,-1} = 0
Y así obtenemos la última columna de nuestro vector de características. Podemos repetir los mismos pasos para las otras columnas.
[3] Agrupación media : En este paso, agrupamos los vectores de características promediando las columnas para obtener un único vector. A esto se le suele llamar incrustación de texto o incrustación de oraciones.
Se pueden utilizar otras técnicas de agrupación, como CLS y SEP, pero la agrupación media es la que se utiliza más ampliamente.
[4] Indexación : El siguiente paso consiste en reducir las dimensiones del vector de incrustación de texto, lo que se realiza con la ayuda de una matriz de proyección. Esta matriz de proyección podría ser aleatoria. La idea aquí es obtener una representación breve que permita una comparación y recuperación más rápidas.
Este resultado se mantiene alejado en el almacenamiento de vectores.
[5] Repetir : Los pasos anteriores [1]-[4] se repiten para las otras oraciones en el conjunto de datos “quién eres tú” y “quién soy yo”.
Ahora que hemos indexado nuestro conjunto de datos en la base de datos vectorial, pasamos a la consulta real y vemos cómo se desarrollan estos índices para darnos la solución.
Consulta : “¿soy tú?”
[6] Para comenzar, repetimos los mismos pasos anteriores: incrustar, codificar e indexar para obtener una representación vectorial 2D de nuestra consulta.
[7] Producto escalar (encontrar similitudes)
Una vez realizados los pasos anteriores, realizamos productos escalares. Esto es importante ya que estos productos punto impulsan la idea de comparación entre el vector de consulta y los vectores de nuestra base de datos. Para realizar este paso, transponemos nuestro vector de consulta y lo multiplicamos por los vectores de la base de datos.
[8] Vecino más cercano
El último paso es realizar un escaneo lineal para encontrar el producto escalar más grande, que para nuestro ejemplo es 60/9. Esta es la representación vectorial de “quién soy yo”. En la vida real, un escaneo lineal podría ser increíblemente lento, ya que puede involucrar miles de millones de valores; la alternativa es utilizar un algoritmo de vecino más cercano aproximado (ANN) como el de los pequeños mundos navegables jerárquicos (HNSW).
Y eso nos lleva al final de este elegante método.
Por lo tanto, al utilizar las incrustaciones de vectores de los conjuntos de datos en la base de datos de vectores y realizar los pasos anteriores, pudimos encontrar la oración más cercana a nuestra consulta. La incrustación, la codificación, la agrupación de medios, la indexación y luego los productos punto forman el núcleo de este proceso.
Sin embargo, para presentar una vez más la perspectiva “grande”:
- Un conjunto de datos puede contener millones o miles de millones de frases.
- La cantidad de tokens para cada uno de ellos puede ser de decenas de miles.
- La palabra dimensiones de incrustación puede ser de miles.
Al reunir todos estos datos y pasos, estamos hablando de realizar operaciones en dimensiones de tamaño gigantesco. Y así, para potenciar esta magnífica escala, las bases de datos vectoriales vienen al rescate. Dado que comenzamos este artículo hablando de LLM, sería un buen lugar para decir que debido a la capacidad de manejo de escala de las bases de datos vectoriales, han llegado a desempeñar un papel importante en la generación aumentada de recuperación (RAG). La escalabilidad y velocidad que ofrecen las bases de datos vectoriales permiten una recuperación eficiente de los modelos RAG, allanando así el camino para un modelo generativo eficiente.
Considerándolo todo, es muy correcto decir que las bases de datos vectoriales son poderosas. No es de extrañar que hayan estado aquí por un tiempo: comenzaron su viaje de ayudar a los sistemas de recomendación y ahora impulsan los LLM, su regla continúa. Y con el ritmo que crecen las incorporaciones de vectores para diferentes modalidades de IA, ¡parece que las bases de datos vectoriales continuarán dominando durante una buena cantidad de tiempo en el futuro!
PD: Si desea realizar este ejercicio por su cuenta, aquí tiene un enlace a una plantilla en blanco para su uso.
Ahora diviértete y crea algunos ‘vectoresco luminoso’ ¡magia!