
Tareas como crear documentos, desarrollar código complejo, responder consultas y llevar a cabo conversaciones similares a las humanas son donde brillan los grandes modelos de lenguaje como ChatGPT. A medida que los LLM encuentran cada vez más usos en muchos tipos diferentes de tareas, ajustarlos para ciertos dominios se ha convertido en una táctica importante para mejorar sus capacidades en el futuro. Sin embargo, estas tecnologías son bastante costosas, lo que dificulta la construcción de modelos a gran escala. Se han sugerido métodos de ajuste fino eficiente en parámetros (PEFT) para minimizar la cantidad de parámetros entrenables y reducir el costo. Estos métodos incluyen pesos adaptadores, pesos rápidos y LoRA.
Entre ellas, LoRA es una de las técnicas PEFT más adoptadas, que permite fusionar el adaptador con los parámetros del modelo base. Pero LoRA todavía necesita mucho camino por recorrer antes de poder competir con el ajuste completo de parámetros en todos los escenarios cuando se trata de tareas de ajuste. Por ejemplo, existen preocupaciones sobre la eficacia de LoRA en conjuntos de datos a gran escala debido a las observaciones de que a menudo falla durante el entrenamiento previo continuo. Esto se debe a que el entrenamiento LoRA tiene menos capacidad de representación que el modelo base porque tiene menos parámetros entrenables.
Para abordar esta limitación, investigadores de la Universidad de Ciencia y Tecnología de Hong Kong y la Universidad de Illinois investigaron las estadísticas de entrenamiento de LoRA en cada capa para cerrar la brecha entre LoRA y el ajuste fino de todos los parámetros. El equipo descubrió que las normas de peso por capas de LoRA están sorprendentemente sesgadas; la mayoría de los pesos se asignan a la capa inferior o superior durante la actualización, y muy pocos pesos se asignan a las otras capas de atención propia. Esto indica que a las diferentes capas se les asignan pesos diferentes según su importancia.
De acuerdo con el concepto de muestreo de importancia, este hallazgo crucial los motivó a “muestrear” varios niveles según su importancia relativa. Como resultado, el equipo introdujo el algoritmo Layerwise Importance Sampled Adam (LISA) que permite entrenar modelos de lenguaje a gran escala (≥ 65B de parámetros) con el mismo o menos consumo de memoria que LoRA actualizando selectivamente solo las capas LLM esenciales mientras dejando a los demás intactos.
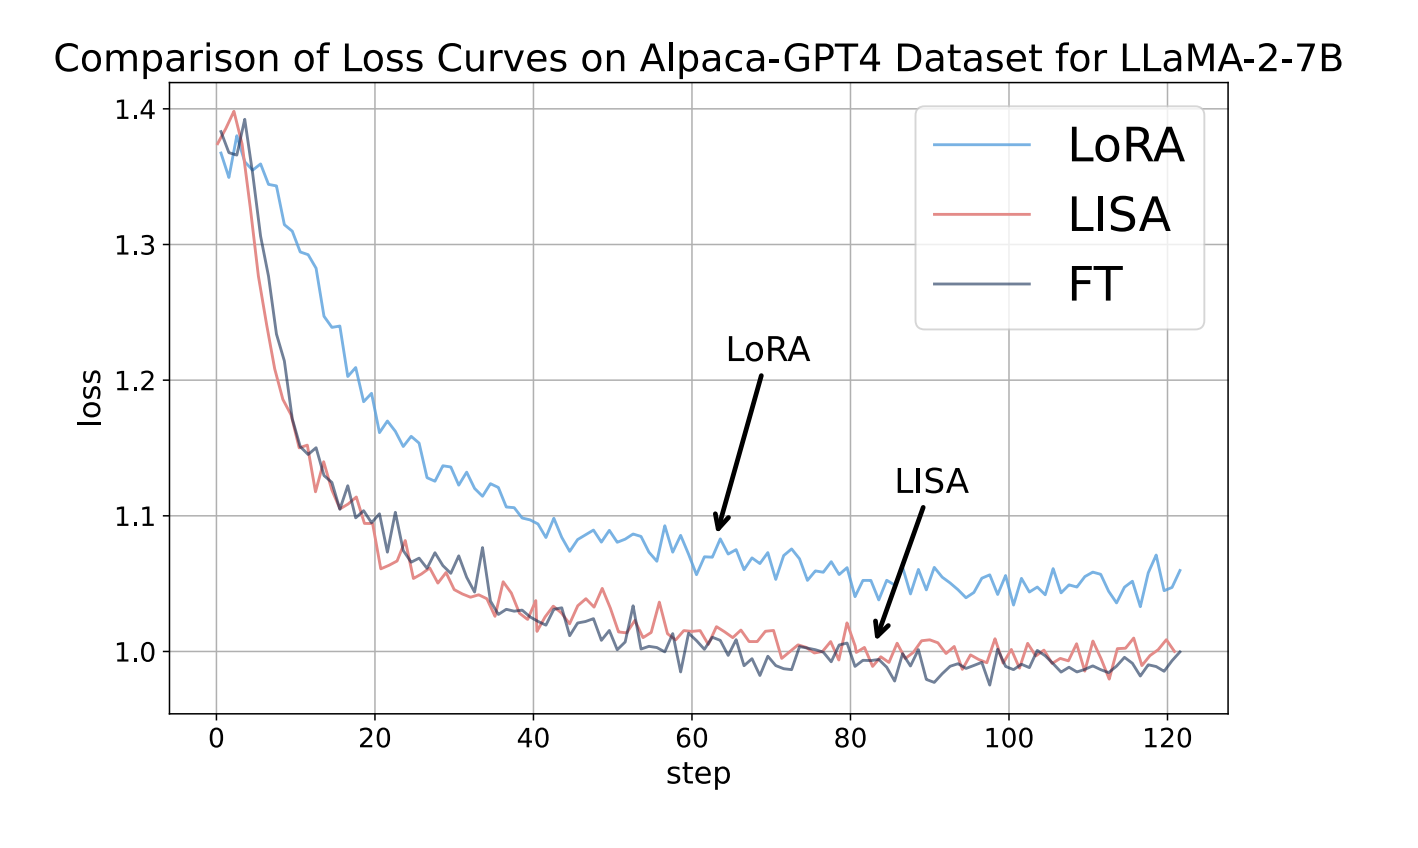
Tras realizar ajustes para tareas posteriores, LISA superó tanto a LoRA como a los métodos tradicionales de ajuste fino de parámetros completos. Esta importante brecha de rendimiento sugiere que LISA podría ser una alternativa prometedora a LoRA, lo que demuestra su superioridad en el campo de la formación de modelos de lenguaje a gran escala.
Esta investigación demuestra que LISA mejora las características de convergencia y supera a LoRA entre un 8% y un 36% en MT-Bench, lo que la convierte en una opción convincente para perfeccionar las tareas de los LLM actuales. Además, el desempeño de LISA no se limita a tareas específicas o tamaños de modelos. Ofrece consistentemente resultados mejorados en diversas actividades, incluido el seguimiento de instrucciones, control de calidad médico y problemas matemáticos para modelos que varían de 7 B a 70 B de tamaño.
El equipo destaca que, al igual que LoRA, el principal inconveniente de LISA es el consumo de memoria provocado por el avance de optimización, que aún requiere que el modelo se muestre en la memoria. En el futuro, quieren realizar pruebas adicionales para confirmar el rendimiento de QLoRA, lo que les ayudará a compensar esta deficiencia.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 39k+ ML
Dhanshree Shenwai es ingeniero en informática y tiene una buena experiencia en empresas de tecnología financiera que cubren el ámbito financiero, tarjetas y pagos y banca con un gran interés en las aplicaciones de IA. Le entusiasma explorar nuevas tecnologías y avances en el mundo en evolución de hoy que facilita la vida de todos.