
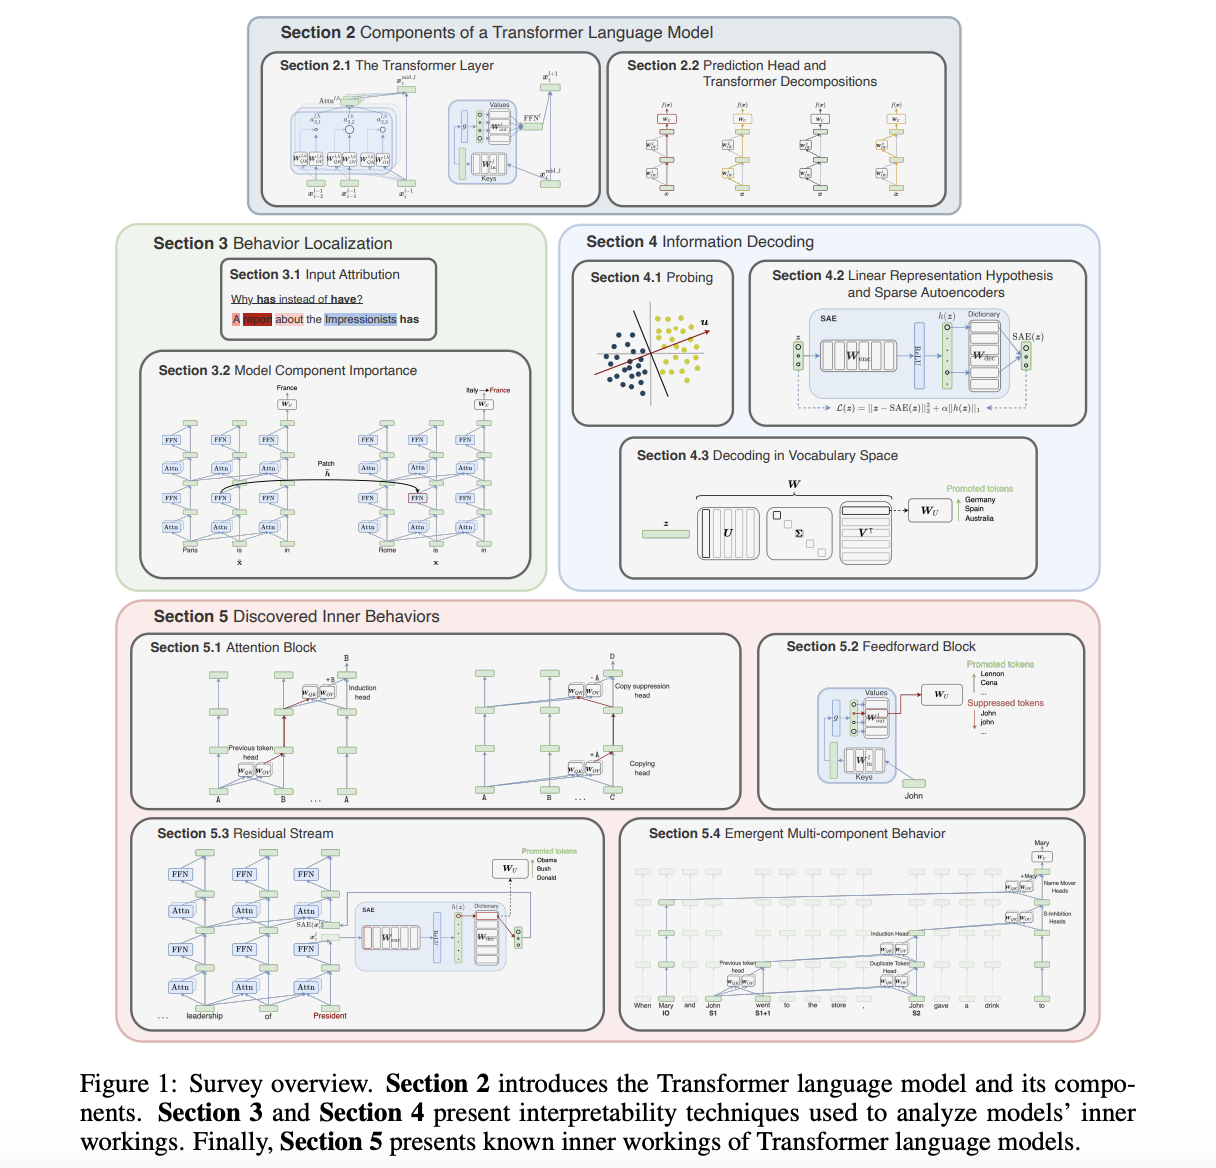
El aumento de potentes modelos de lenguaje (LM) basados en Transformer y su uso generalizado pone de relieve la necesidad de investigar su funcionamiento interno. Comprender estos mecanismos en los sistemas avanzados de IA es crucial para garantizar su seguridad y equidad, y minimizar sesgos y errores, especialmente en contextos críticos. En consecuencia, ha habido un aumento notable en la investigación dentro de la comunidad de procesamiento del lenguaje natural (PNL), específicamente dirigida a la interpretabilidad en modelos de lenguaje, lo que arroja nuevos conocimientos sobre sus operaciones internas.
Las encuestas existentes detallan una variedad de técnicas utilizadas en los análisis de IA explicable y sus aplicaciones dentro de la PNL. Si bien las encuestas anteriores se centraron predominantemente en modelos basados en codificadores como BERT, la aparición de Transformers solo decodificadores impulsó avances en el análisis de estos potentes modelos generativos. Al mismo tiempo, la investigación ha explorado las tendencias en interpretabilidad y sus conexiones con la seguridad de la IA, destacando el panorama en evolución de los estudios de interpretabilidad en el dominio de la PNL.
Investigadores de la Universitat Politècnica de Catalunya, CLCG, University of Groningen y FAIR, Meta presentan el estudio que ofrece una descripción técnica exhaustiva de las técnicas empleadas en la investigación de la interpretabilidad de LM, enfatizando los conocimientos obtenidos de las operaciones internas de los modelos y estableciendo conexiones entre los dominios de la investigación de la interpretabilidad. Al emplear una notación unificada, presenta componentes del modelo, métodos de interpretabilidad y conocimientos de los trabajos estudiados, aclarando la lógica detrás de los diseños de métodos específicos. Los enfoques de interpretabilidad de LM discutidos se clasifican en función de dos dimensiones: localizar entradas o componentes del modelo para predicciones y decodificar información dentro de representaciones aprendidas. Además, proporcionan una lista extensa de conocimientos sobre el funcionamiento de LM basado en transformadores y describen herramientas útiles para realizar análisis de interpretabilidad en estos modelos.
Los investigadores presentan dos tipos diferentes de métodos que permiten localizar el comportamiento del modelo: atribución de entrada y atribución de componentes del modelo. Los métodos de atribución de entrada estiman la importancia del token mediante gradientes o perturbaciones. Las alternativas de combinación de contexto a los pesos de atención brindan información sobre las atribuciones simbólicas. La atribución logit mide las contribuciones de los componentes, mientras que las intervenciones causales ven los cálculos como modelos causales. El análisis de circuitos identifica componentes que interactúan, y los avances recientes automatizan el descubrimiento de circuitos y abstraen las relaciones causales. Estos métodos ofrecen información valiosa sobre el funcionamiento del modelo de lenguaje, lo que ayuda a mejorar el modelo y a los esfuerzos de interpretabilidad. Las primeras investigaciones sobre los Transformer LM revelaron capacidades escasas, donde incluso eliminar una parte significativa de los cabezales de atención puede no perjudicar el rendimiento. Las atribuciones logit directas (DLA) miden la contribución de cada componente LM a la predicción del token, lo que facilita la análisis del comportamiento del modelo. Las intervenciones causales ven los cálculos de LM como modelos causales, que intervienen para medir los efectos de los componentes en las predicciones. El análisis de circuitos identifica componentes que interactúan, lo que ayuda a comprender el funcionamiento de LM, aunque presenta desafíos como el diseño de plantillas de entrada y el comportamiento compensatorio. Los enfoques recientes automatizan el descubrimiento de circuitos, mejorando la interpretabilidad.
Exploran métodos para decodificar información en modelos de redes neuronales, especialmente en el procesamiento del lenguaje natural. El sondeo utiliza modelos supervisados para predecir propiedades de entrada a partir de representaciones intermedias. Las intervenciones lineales borran o manipulan características para comprender su importancia o dirigir los resultados del modelo. Los codificadores automáticos dispersos desenredan características en modelos con superposición, promoviendo representaciones interpretables. Los SAE cerrados mejoran la detección de características en los SAE. La decodificación en el espacio de vocabulario y las entradas de activación máxima proporcionan información sobre el comportamiento del modelo. Las explicaciones en lenguaje natural de los LM ofrecen justificaciones plausibles para las predicciones, pero pueden carecer de fidelidad al funcionamiento interno del modelo. También proporcionaron una descripción general de varias bibliotecas de software de código abierto (Captum, una biblioteca en el ecosistema de Pytorch que proporciona acceso a varios métodos de atribución de entrada basados en gradientes y perturbaciones para cualquier modelo basado en Pytorch) que se introdujeron para facilitar los estudios de interpretabilidad en Transformer- LM basados en
En conclusión, este estudio integral subraya el imperativo de comprender el funcionamiento interno de los modelos de lenguaje basados en Transformer para garantizar su seguridad, equidad y mitigar los sesgos. A través de un examen detallado de las técnicas de interpretabilidad y los conocimientos obtenidos de los análisis de modelos, la investigación contribuye significativamente al panorama cambiante de la interpretabilidad de la IA. Al categorizar los métodos de interpretabilidad y mostrar sus aplicaciones prácticas, el estudio avanza la comprensión del campo y facilita los esfuerzos continuos para mejorar la transparencia y la interoperabilidad del modelo.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 41k+ ML

Asjad es consultor interno en Marktechpost. Está cursando B.Tech en ingeniería mecánica en el Instituto Indio de Tecnología, Kharagpur. Asjad es un entusiasta del aprendizaje automático y el aprendizaje profundo que siempre está investigando las aplicaciones del aprendizaje automático en la atención médica.