
Introducción
Los modelos de lenguaje grande (LLM) son modelos generativos versátiles adecuados para una amplia gama de tareas. Pueden producir resultados consistentes y repetibles o generar contenido creativo juntando palabras improbables. La configuración de “temperatura” permite a los usuarios ajustar la salida del modelo, controlando el grado de previsibilidad.
Tomemos un ejemplo hipotético para comprender el impacto de la temperatura en la próxima predicción simbólica.
Le pedimos a un LLM que completara la oración, “Este es un _____ maravilloso”. Supongamos que los tokens candidatos potenciales son:
|   token    | logit |
|------------|-------|
| day        |    40 |
| space      |     4 |
| furniture  |     2 |
| experience |    35 |
| problem    |    25 |
| challenge  |    15 |
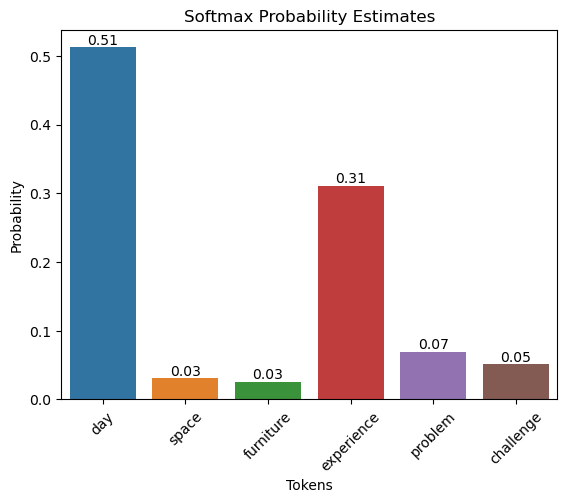
Los logits se pasan a través de una función softmax para que la suma de los valores sea igual a uno. Básicamente, la función softmax genera estimaciones de probabilidad para cada token.
Calculemos las estimaciones de probabilidad en Python.
import numpy as np
import seaborn as sns
import pandas as pd
import matplotlib.pyplot as plt
from ipywidgets import interactive, FloatSliderdef softmax(logits):
exps = np.exp(logits)
return exps / np.sum(exps)
data = {
"tokens": ["day", "space", "furniture", "experience", "problem", "challenge"],
"logits": [5, 2.2, 2.0, 4.5, 3.0, 2.7]
}
df = pd.DataFrame(data)
df['probabilities'] = softmax(df['logits'].values)
df
| No. |   tokens   | logits | probabilities |
|-----|------------|--------|---------------|
|   0 | day        |    5.0 |      0.512106 |
|   1 | space      |    2.2 |      0.031141 |
|   2 | furniture  |    2.0 |      0.025496 |
|   3 | experience |    4.5 |      0.310608 |
|   4 | problem    |    3.0 |      0.069306 |
|   5 | challenge  |    2.7 |      0.051343 |
ax = sns.barplot(x="tokens", y="probabilities", data=df)
ax.set_title('Softmax Probability Estimates')
ax.set_ylabel('Probability')
ax.set_xlabel('Tokens')
plt.xticks(rotation=45)
for bar in ax.patches:
ax.text(bar.get_x() + bar.get_width() / 2, bar.get_height(), f'{bar.get_height():.2f}',
ha='center', va='bottom', fontsize=10, rotation=0)
plt.show()
El función softmax con temperatura se define de la siguiente manera:
donde (T) es la temperatura, (x_i) es el (i)-ésimo componente del vector de entrada (logits) y (n) es el número de componentes del vector.
def softmax_with_temperature(logits, temperature):
if temperature <= 0:
temperature = 1e-10 # Prevent division by zero or negative temperatures
scaled_logits = logits / temperature
exps = np.exp(scaled_logits - np.max(scaled_logits)) # Numerical stability improvement
return exps / np.sum(exps)def plot_interactive_softmax(temperature):
probabilities = softmax_with_temperature(df['logits'], temperature)
plt.figure(figsize=(10, 5))
bars = plt.bar(df['tokens'], probabilities, color='blue')
plt.ylim(0, 1)
plt.title(f'Softmax Probabilities at Temperature = {temperature:.2f}')
plt.ylabel('Probability')
plt.xlabel('Tokens')
# Add text annotations
for bar, probability in zip(bars, probabilities):
yval = bar.get_height()
plt.text(bar.get_x() + bar.get_width()/2, yval, f"{probability:.2f}", ha='center', va='bottom', fontsize=10)
plt.show()
interactive_plot = interactive(plot_interactive_softmax, temperature=FloatSlider(value=1, min=0, max=2, step=0.01, description='Temperature'))
interactive_plot
En T = 1,
A una temperatura de 1, los valores de probabilidad son los mismos que los derivados de la función softmax estándar.
En T > 1,
El aumento de la temperatura infla las probabilidades de los tokens menos probables, ampliando así el rango de candidatos potenciales (o diversidad) para la próxima predicción de tokens del modelo.
En T < 1,
Por otro lado, bajar la temperatura hace que la probabilidad del token más probable se acerque a 1,0, lo que aumenta la confianza del modelo. La disminución de la temperatura elimina efectivamente la incertidumbre dentro del modelo.
Conclusión
Los LLM aprovechan el parámetro de temperatura para ofrecer flexibilidad en sus predicciones. El modelo se comporta de manera predecible a una temperatura de 1, siguiendo de cerca la distribución softmax original. El aumento de la temperatura introduce una mayor diversidad, amplificando los tokens menos probables. Por el contrario, disminuir la temperatura hace que las predicciones sean más enfocadas, lo que aumenta la confianza del modelo en el token más probable al reducir la incertidumbre. Esta adaptabilidad permite a los usuarios adaptar los resultados de LLM a una amplia gama de tareas, logrando un equilibrio entre la exploración creativa y los resultados deterministas.