
La extracción de información (IE) es un área fundamental de la inteligencia artificial que transforma texto no estructurado en datos estructurados y procesables. A pesar de sus amplias capacidades, los modelos de lenguajes grandes (LLM) tradicionales a menudo no logran comprender ni ejecutar las directivas matizadas necesarias para una IE precisa. Estos desafíos se manifiestan principalmente en tareas cerradas de IE, donde un modelo debe cumplir con esquemas estrictos y predefinidos.
Las tareas de IE obligan a los modelos a discernir y categorizar texto en formatos que se alinean con estructuras predefinidas, como el reconocimiento de entidades con nombre y la clasificación de relaciones. Sin embargo, los LLM existentes generalmente fallan cuando se les asigna la comprensión matizada y la alineación necesarias para una IE efectiva. Los investigadores han empleado tradicionalmente estrategias como la ingeniería rápida, que implica proporcionar anotaciones y pautas detalladas para ayudar a los LLM sin alterar los parámetros subyacentes del modelo.
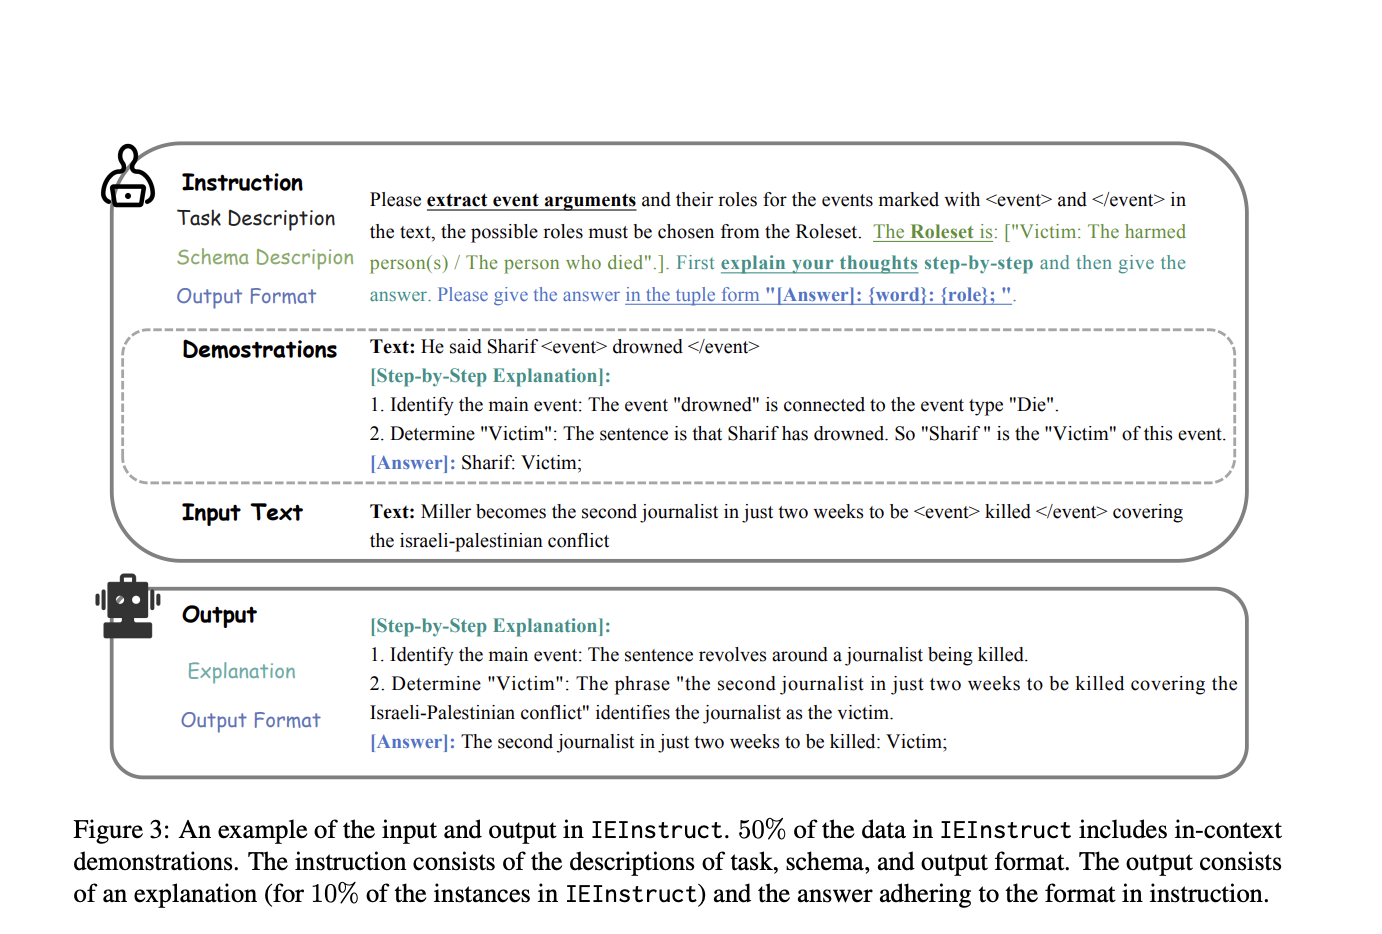
La comunidad de investigación ha observado una necesidad crítica de una metodología que mejore la comprensión de los LLM sobre las tareas estructuradas y mejore la precisión de la ejecución. En respuesta, investigadores de la Universidad de Tsinghua han introducido un nuevo enfoque llamado ADÉLIA (Aalineando mo de lenguaje grandeDELestá encendido Iinformación miextracción). Este enfoque aprovecha un conjunto de datos especializado, IEInstruct, que comprende más de 83 000 instancias en varios formatos de IE, incluidos tripletes, respuestas en lenguaje natural y resultados JSON.

ADELIE se diferencia de los métodos convencionales al integrar un ajuste supervisado con una innovadora estrategia de optimización de preferencias directas (DPO). Esta combinación permite que el modelo se alinee más estrechamente con las complejidades del procesamiento de IE similar al humano. La capacitación inicial implica una combinación de datos genéricos y específicos de IE, utilizando el modelo LLAMA 2 en 6306 pasos de gradiente, lo que garantiza la retención de amplias capacidades lingüísticas junto con el rendimiento especializado de IE.
Las métricas de rendimiento revelan que los modelos ADELIE, ADELIESFT y ADELIEDPO, logran resultados que establecen puntos de referencia. En las evaluaciones con conjuntos de datos disponibles, ADELIESFT muestra una mejora promedio en la puntuación F1 del 5 % con respecto a los resultados estándar de LLM en tareas cerradas de IE. Las mejoras son aún más pronunciadas para IE abierto, con los modelos ADELIE superando a las alternativas de última generación por márgenes de 3-4% en robustez y precisión de extracción. En el ámbito de la IE bajo demanda, los modelos demuestran una comprensión matizada de las instrucciones del usuario, lo que se traduce en una estructuración de datos altamente precisa.
En conclusión, la capacitación metódica y la optimización de ADELIE se traducen en una potente alineación de los LLM con las tareas de IE, lo que demuestra que un enfoque centrado en la diversidad de datos y la especificidad de las instrucciones puede cerrar la brecha entre las expectativas humanas y el rendimiento de las máquinas. Esta alineación no compromete las capacidades generales de los modelos, lo que suele ser una preocupación con el ajuste de tareas específicas. Los impresionantes resultados en varias métricas y tipos de tareas subrayan el potencial de ADELIE para establecer nuevos estándares en la extracción de información, convirtiéndola en una herramienta valiosa para múltiples aplicaciones, desde la investigación académica hasta el procesamiento de datos del mundo real.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 42k+ ML

A Sana Hassan, pasante de consultoría en Marktechpost y estudiante de doble titulación en IIT Madras, le apasiona aplicar la tecnología y la inteligencia artificial para abordar los desafíos del mundo real. Con un gran interés en resolver problemas prácticos, aporta una nueva perspectiva a la intersección de la IA y las soluciones de la vida real.