
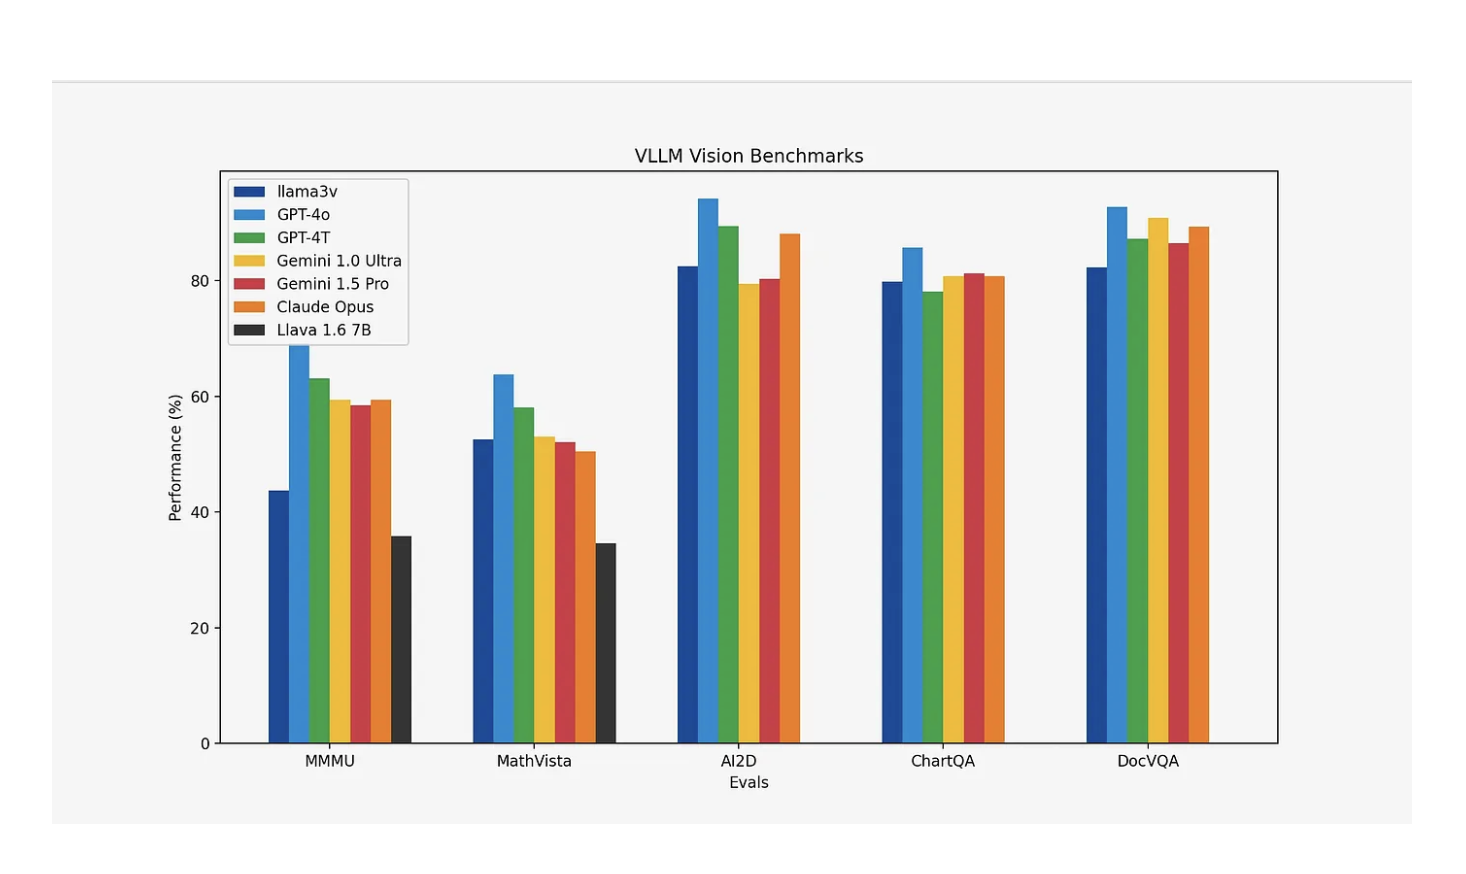
Llama 3 ha superado significativamente a GPT-3.5 e incluso superó a GPT-4 en varios puntos de referencia, mostrando su fortaleza en eficiencia y rendimiento en tareas específicas a pesar de tener menos parámetros. Sin embargo, GPT-4o surgió con capacidades multimodales avanzadas, recuperando la primera posición. Llama 3, que utiliza innovaciones como la atención de consultas agrupadas, sobresale en traducción y generación de diálogos, mientras que GPT-4 demuestra habilidades superiores de razonamiento y resolución de problemas. GPT-4o mejora aún más estas habilidades, solidificando su dominio con una arquitectura neuronal mejorada y competencia multimodal.
Este estudio presenta Llama3-V, un modelo multimodal basado en Llama3, entrenado por menos de 500 dólares. Integra información visual incorporando imágenes de entrada en incrustaciones de parches utilizando el modelo SigLIP. Estas incrustaciones se alinean con tokens textuales a través de un bloque de proyección que utiliza bloques de autoatención, colocando incrustaciones visuales y textuales en el mismo plano. Luego, los tokens visuales se anteponen a los tokens textuales y la representación conjunta se procesa a través de Llama3, mejorando su capacidad para comprender e integrar datos visuales.
SigLIP, un modelo de incrustación de imágenes, utiliza una pérdida sigmoidea por pares para procesar cada par de imagen-texto de forma independiente, a diferencia de la pérdida contrastiva de CLIP con normalización softmax. El codificador de visión de SigLIP divide las imágenes en parches que no se superponen, proyectándolas en un espacio de incrustación de dimensiones inferiores y aplicando atención propia para la extracción de características de nivel superior. Para alinear las incrustaciones de imágenes de SigLIP con las incrustaciones textuales de Llama3, se utiliza un módulo de proyección con dos bloques de autoatención. Los tokens visuales de estas incrustaciones se anteponen a los tokens textuales, creando una entrada conjunta para Llama3.

Para optimizar los recursos computacionales, se emplearon dos estrategias principales. En primer lugar, un mecanismo de almacenamiento en caché precalcula las incrustaciones de imágenes SigLIP, lo que aumenta la utilización de la GPU y el tamaño del lote sin provocar errores de falta de memoria. Esta separación de las etapas de procesamiento SigLIP y Llama3 mejora la eficiencia. En segundo lugar, mediante la utilización de optimizaciones MPS/MLX, SigLIP, debido a su tamaño más pequeño, ejecuta inferencias en Macbooks y logra un rendimiento de 32 imágenes/segundo. Estas optimizaciones ahorran tiempo de capacitación e inferencia al administrar eficientemente los recursos y maximizar el uso de la GPU.
Precalcular incrustaciones de imágenes a través de SigLIP implica cargar el modelo SigLIP, preprocesar imágenes y obtener representaciones vectoriales. Las imágenes de alta resolución se dividen en parches para una codificación eficiente. La activación sigmoidea se aplica a logits para extraer incrustaciones, que luego se proyectan en un espacio multimodal conjunto utilizando una matriz de peso aprendida. Estas incrustaciones proyectadas, o “latentes”, se anteponen a los tokens de texto para el entrenamiento previo de Llama3. El entrenamiento previo utiliza 600.000 pares de imagen-texto y actualiza solo la matriz de proyección. El ajuste supervisado mejora el rendimiento utilizando ejemplos de 1 millón, centrándose en las matrices de visión y proyección.
Llama3-V logra un aumento de rendimiento del 10 al 20 % sobre Llava, el modelo líder para la comprensión multimodal. También funciona de manera comparable a modelos de código cerrado mucho más grandes en la mayoría de las métricas, excepto MMMU, lo que demuestra su eficiencia y competitividad a pesar de un tamaño más pequeño.
En resumen, Llama3-V demuestra avances significativos en IA multimodal, superando a Llava y rivalizando con modelos de código cerrado más grandes en la mayoría de las métricas. Al integrar SigLIP para la incrustación eficiente de imágenes y emplear optimizaciones computacionales estratégicas, Llama3-V maximiza la utilización de la GPU y reduce los costos de capacitación. El entrenamiento previo y el ajuste supervisado mejoran sus capacidades multimodales, lo que lleva a un aumento significativo del rendimiento del 10 al 20 % con respecto a Llava. El enfoque innovador y la formación rentable de Llama3-V lo establecen como un modelo de vanguardia competitivo y eficiente para la comprensión multimodal.
Revisar la GitHub, Modeloy Blog. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 43k+ ML | Además, consulte nuestro Plataforma de eventos de IA

Asjad es consultor interno en Marktechpost. Está cursando B.Tech en ingeniería mecánica en el Instituto Indio de Tecnología, Kharagpur. Asjad es un entusiasta del aprendizaje automático y el aprendizaje profundo que siempre está investigando las aplicaciones del aprendizaje automático en la atención médica.