
Los modelos de lenguaje grande (LLM) y sus contrapartes multimodales (MLLM) han logrado avances significativos en el avance de la inteligencia artificial general (AGI) en varios dominios. Sin embargo, estos modelos enfrentan un desafío significativo en el ámbito de la resolución visual de problemas matemáticos. Si bien los MLLM han demostrado capacidades impresionantes en diversas tareas, tienen dificultades para aprovechar al máximo su potencial cuando se enfrentan a problemas matemáticos presentados en contextos visuales. Esta limitación es particularmente evidente en escenarios donde los modelos deben interpretar figuras geométricas, comprender relaciones espaciales e integrar conceptos matemáticos complejos con información visual.
La dificultad radica en las exigencias particulares de la resolución de problemas matemáticos visuales, que requiere una integración perfecta del razonamiento analítico a partir de preguntas textuales con la información contextual proporcionada por los diagramas visuales. A diferencia de los problemas matemáticos basados únicamente en texto, en los que los LLM han demostrado un progreso considerable debido a la abundancia de datos de entrenamiento y a su dominio inherente del lenguaje, las matemáticas visuales introducen una capa adicional de complejidad. Los modelos no solo deben comprender los conceptos matemáticos, sino también interpretar con precisión los elementos visuales, como formas geométricas, ángulos, medidas y relaciones espaciales representados en los diagramas.
El ajuste de la instrucción visual para MLLM ha experimentado avances significativos a través de enfoques como LLaMA-Adapter, LLaVA, Flamingo, SPHINX e InternVL, cada uno de los cuales presenta técnicas eficientes para la integración de la visión y el lenguaje. Al mismo tiempo, la resolución de problemas matemáticos basados en texto ha avanzado con proyectos como MAmmoTH, MetaMATH y MathCoder. Sin embargo, en el dominio matemático multimodal, los esfuerzos siguen siendo limitados. Han surgido conjuntos de datos como Geometry3K y UniMath, pero su alcance y escala son insuficientes. G-LLaVA muestra ser prometedor en geometría gráfica, pero tiene dificultades en otras áreas matemáticas, lo que resalta la necesidad de enfoques más sólidos y completos para la resolución visual de problemas matemáticos.
Investigadores de CUHK, la Universidad de Pekín, el Laboratorio de IA de Shanghái y Oracle presentan MAVIS (ajuste de instrucciones visual-matemáticas) MAVIS presenta un enfoque sólido que aborda las limitaciones de los MLLM en la resolución visual de problemas matemáticos. Este marco aborda tres problemas críticos: incrustaciones de diagramas matemáticos insatisfactorias por parte de codificadores de visión, desalineación del lenguaje de diagramas entre codificadores de visión y LLM, y razonamiento matemático inexacto con elementos visuales. MAVIS presenta dos conjuntos de datos extensos, MAVIS-Caption y MAVIS-Instruct, que cubren varios dominios matemáticos. Emplea un proceso de entrenamiento progresivo de tres etapas para mejorar las capacidades de codificación visual de diagramas y razonamiento. El resultado es MAVIS-7B, un MLLM especializado y optimizado para tareas matemáticas visuales, que demuestra un rendimiento superior en los puntos de referencia de evaluación en comparación con los MLLM de código abierto existentes, lo que resalta la efectividad de este enfoque específico para avanzar en las capacidades de resolución visual de problemas matemáticos.
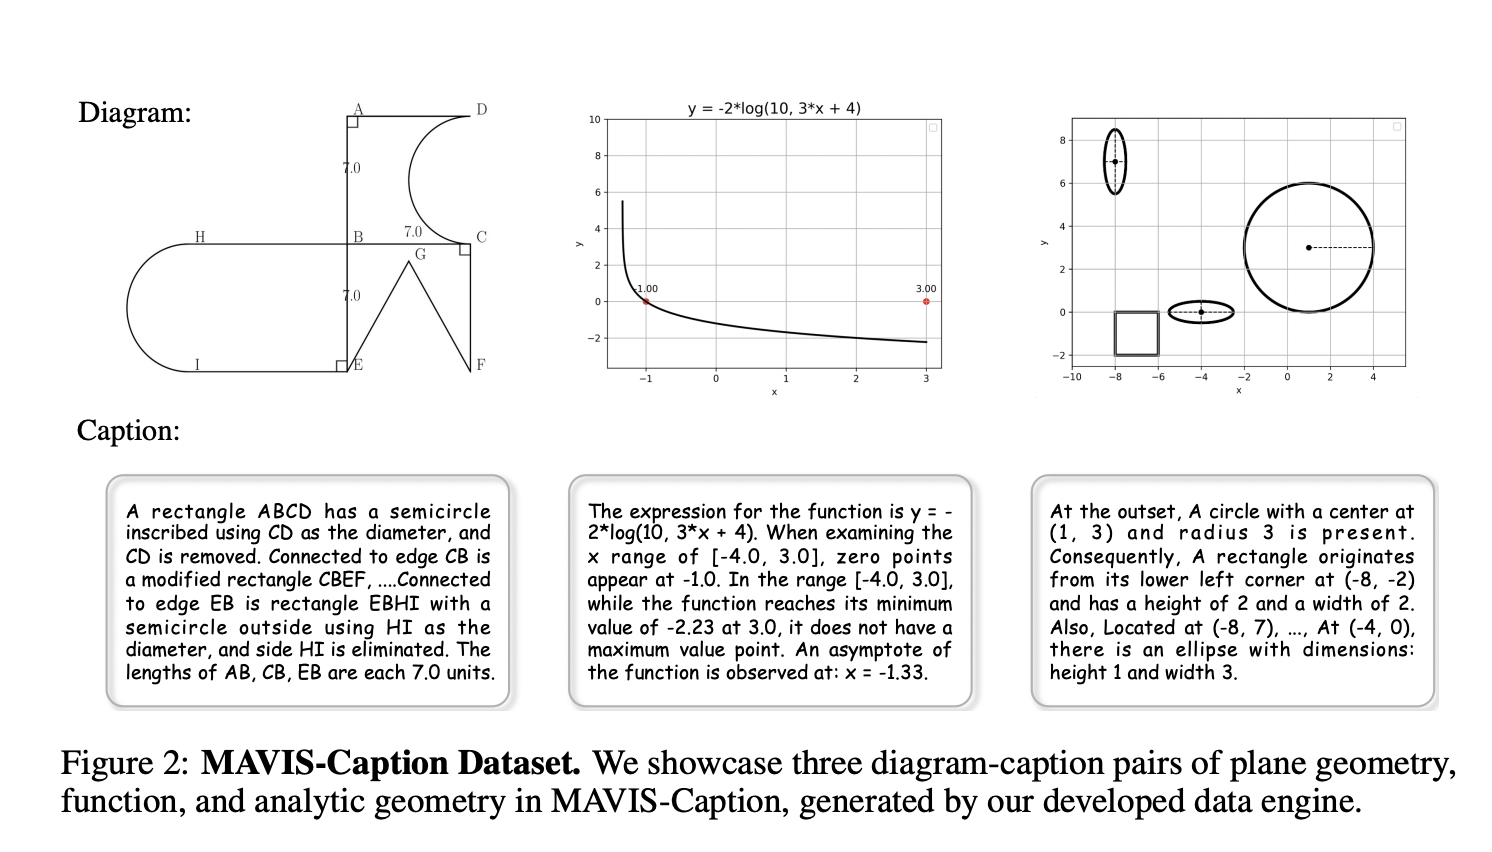
MAVIS presenta un innovador motor de datos para generar diagramas matemáticos de alta calidad de manera eficiente, abordando así la escasez de conjuntos de datos matemáticos visuales. El motor cubre tres tipos principales de diagramas: geometría plana, geometría analítica y función. Para la geometría plana, emplea principios de curación de datos de múltiples saltos, combinando iterativamente formas básicas para crear diversas configuraciones. Los diagramas de geometría analítica se construyen en un sistema de coordenadas cartesianas, incorporando varios elementos geométricos sin superposición. Los diagramas de función se centran en siete tipos fundamentales, utilizando ecuaciones parametrizadas para generar diversos gráficos. Todos los diagramas se representan utilizando Matplotlib, con características adicionales como etiquetado de vértices y representación gráfica de puntos clave para mejorar la comprensión matemática y las capacidades de razonamiento.

MAVIS-Caption, un componente crucial del marco MAVIS, es un conjunto de datos a gran escala que comprende 588.000 pares de diagramas y leyendas. Abarca tres dominios matemáticos: geometría plana (299.000 pares), geometría analítica (77.000 pares) y función (212.000 pares). Las leyendas del conjunto de datos son detalladas, con una longitud media de 61,48 palabras y un tamaño de vocabulario de 149. Las estrategias de generación de leyendas varían según el tipo de diagrama, utilizando plantillas creadas con GPT-4 y reglas específicas para cada dominio. Las leyendas de geometría plana se crean de forma iterativa, las leyendas de geometría analítica utilizan descripciones basadas en coordenadas y las leyendas de función detallan varias propiedades de las funciones graficadas. Todas las leyendas son refinadas por ChatGPT para la expresión en lenguaje natural, lo que garantiza descripciones de alta calidad, diversas y matemáticamente precisas del contenido matemático visual.
MAVIS-Instruct es un conjunto de datos completo de 834.000 problemas matemáticos visuales diseñados para mejorar las capacidades de razonamiento matemático visual de los MLLM. Abarca problemas de geometría plana y de funciones, cada uno acompañado de una justificación de cadena de pensamiento (CoT) con un promedio de 150 palabras. Las preguntas del conjunto de datos están simplificadas para minimizar la redundancia textual, lo que alienta a los MLLM a extraer información crítica de las entradas visuales. MAVIS-Instruct se compila a partir de cuatro fuentes: problemas recopilados manualmente aumentados por GPT-4 (84K), conjuntos de datos existentes ampliados por GPT-4 (80K), leyendas del motor de datos anotadas por GPT-4 (51K) y problemas generados directamente por el motor de datos. Este enfoque diverso garantiza una amplia cobertura de conceptos matemáticos y tipos de problemas, al tiempo que mantiene soluciones y justificaciones detalladas de alta calidad para cada problema.
MAVIS-7B demuestra un rendimiento superior en múltiples pruebas de referencia matemáticas, lo que demuestra su eficacia en la resolución visual de problemas matemáticos. En la prueba de referencia integral MathVerse, MAVIS-7B logra la mayor precisión general entre los modelos de código abierto, superando a los modelos más grandes y a los MLLM matemáticos especializados. Supera a InternLM-XComposer2 (7B) en un 11,0 % y a ShareGPT4V (13B) en un 10,1 %. En dominios específicos, MAVIS-7B se destaca en GeoQA para geometría plana, logrando una precisión del 66,7 %, y en FunctionQA, alcanzando una precisión del 40,3 %, superando tanto a los métodos tradicionales como a otros MLLM. El análisis cualitativo revela la comprensión superior de MAVIS-7B de elementos geométricos, curvas de función y ejes de coordenadas, lo que conduce a un razonamiento en cadena de pensamiento de mayor calidad en comparación con GPT-4V.
Este estudio presenta TORDO MÚSICOun enfoque eficiente para el ajuste de la instrucción visual matemática para MLLM. El marco consta de dos componentes clave: conjuntos de datos de alta calidad (MAVIS-Caption y MAVIS-Instruct) generados por un motor de datos sofisticado y una secuencia de entrenamiento de tres etapas. Este proceso mejora secuencialmente el codificador de visión específico de matemáticas, mejora la alineación del lenguaje del diagrama y desarrolla capacidades de razonamiento matemático. El modelo especializado resultante, MAVIS-7B, demuestra un rendimiento excepcional en varios puntos de referencia visuales matemáticos. El enfoque innovador de MAVIS establece un nuevo estándar en la resolución visual de problemas matemáticos, allanando el camino para futuros avances en esta área crítica de la inteligencia artificial y la tecnología educativa.
Revisar la Papel y GitHubTodo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo.
Únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Subreddit de más de 46 000 millones de usuarios

Asjad es consultor en prácticas en Marktechpost. Está cursando la licenciatura en ingeniería mecánica en el Instituto Indio de Tecnología de Kharagpur. Asjad es un entusiasta del aprendizaje automático y del aprendizaje profundo que siempre está investigando las aplicaciones del aprendizaje automático en el ámbito de la atención médica.