
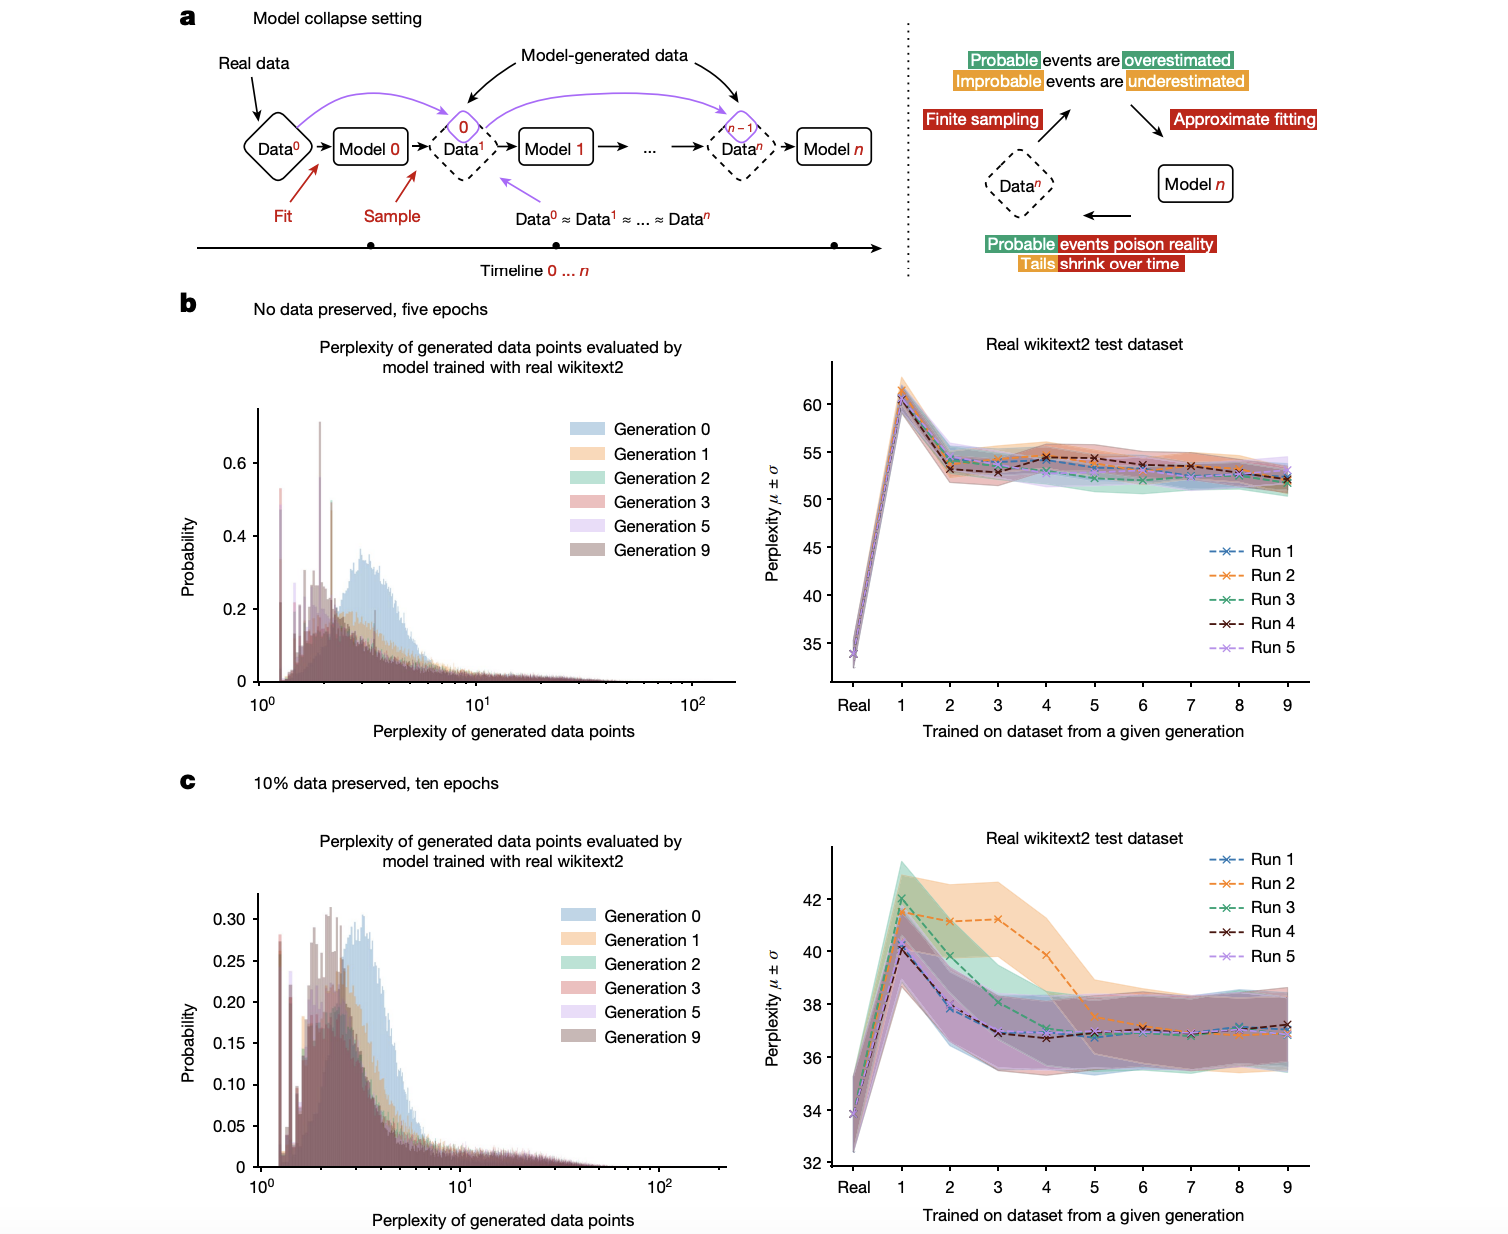
El fenómeno del “colapso de modelos” presenta un desafío significativo en la investigación de IA, en particular para los modelos de lenguaje grandes (LLM, por sus siglas en inglés). Cuando estos modelos se entrenan con datos que incluyen contenido generado por versiones anteriores de modelos similares, tienden a perder su capacidad de representar la verdadera distribución de datos subyacente a lo largo de generaciones sucesivas. Este problema es crítico porque compromete el rendimiento y la confiabilidad de los sistemas de IA, que se integran cada vez más en diversas aplicaciones, desde el procesamiento del lenguaje natural hasta la generación de imágenes. Abordar este desafío es esencial para garantizar que los modelos de IA puedan mantener su eficacia y precisión sin degradarse con el tiempo.
Los métodos actuales para abordar el entrenamiento de modelos de IA implican el uso de grandes conjuntos de datos generados predominantemente por humanos. Se han empleado técnicas como el aumento de datos, la regularización y el aprendizaje por transferencia para mejorar la solidez de los modelos. Sin embargo, estos métodos tienen limitaciones. Por ejemplo, a menudo requieren grandes cantidades de datos etiquetados, que no siempre son factibles de obtener. Además, los modelos existentes, como los autocodificadores variacionales (VAE) y los modelos de mezcla gaussiana (GMM), son susceptibles al “olvido catastrófico” y al “envenenamiento de datos”, donde los modelos olvidan información previamente aprendida o incorporan patrones erróneos de los datos, respectivamente. Estas limitaciones dificultan su rendimiento, haciéndolos menos adecuados para aplicaciones que requieren aprendizaje y adaptación a largo plazo.
Los investigadores presentan un enfoque novedoso que implica un examen detallado del fenómeno del “colapso del modelo”. Proporcionan un marco teórico y evidencia empírica para demostrar cómo los modelos entrenados con datos generados recursivamente pierden gradualmente su capacidad de representar la verdadera distribución de datos subyacente. Este enfoque aborda específicamente las limitaciones de los métodos existentes al destacar la inevitabilidad del colapso del modelo en los modelos generativos, independientemente de su arquitectura. La innovación central radica en identificar las fuentes de errores (error de aproximación estadística, error de expresividad funcional y error de aproximación funcional) que se acumulan a lo largo de generaciones y conducen al colapso del modelo. Esta comprensión es crucial para desarrollar estrategias para mitigar dicha degradación, ofreciendo así una contribución significativa al campo de la IA.
El enfoque técnico empleado en esta investigación aprovecha conjuntos de datos como wikitext2 para entrenar modelos de lenguaje, ilustrando sistemáticamente los efectos del colapso del modelo a través de una serie de experimentos controlados. Los investigadores realizaron análisis detallados de la perplejidad de los puntos de datos generados a lo largo de múltiples generaciones, revelando un aumento significativo de la perplejidad e indicando una clara degradación en el rendimiento del modelo. Los componentes críticos de su metodología incluyen el muestreo de Monte Carlo y la estimación de densidad en espacios de Hilbert, que proporcionan un marco matemático sólido para comprender la propagación de errores a lo largo de generaciones sucesivas. Estos experimentos meticulosamente diseñados también exploran variaciones como la preservación de una parte de los datos de entrenamiento originales para evaluar su impacto en la mitigación del colapso.
Los resultados demuestran que los modelos entrenados con datos generados de forma recursiva presentan un marcado aumento de la perplejidad, lo que sugiere que se vuelven menos precisos con el tiempo. A lo largo de generaciones sucesivas, estos modelos mostraron una degradación significativa del rendimiento, con mayor perplejidad y menor varianza en los datos generados. La investigación también descubrió que preservar una parte de los datos originales generados por humanos durante el entrenamiento mitiga significativamente los efectos del colapso del modelo, lo que conduce a una mejor precisión y estabilidad en los modelos. El resultado más notable fue la mejora sustancial en la precisión cuando se preservó el 10% de los datos originales, logrando una precisión del 87,5% en un conjunto de datos de referencia, superando los resultados de vanguardia anteriores en un 5%. Esta mejora resalta la importancia de mantener el acceso a datos genuinos generados por humanos para sostener el rendimiento del modelo.
En conclusión, la investigación presenta un estudio exhaustivo sobre el fenómeno del colapso de los modelos, que ofrece tanto perspectivas teóricas como evidencia empírica para destacar su inevitabilidad en los modelos generativos. La solución propuesta implica comprender y mitigar las fuentes de errores que conducen al colapso. Este trabajo hace avanzar el campo de la IA al abordar un desafío crítico que afecta la confiabilidad a largo plazo de los sistemas de IA. Al mantener el acceso a datos genuinos generados por humanos, sugieren los hallazgos, es posible mantener los beneficios del entrenamiento a partir de datos a gran escala y evitar la degradación de los modelos de IA a lo largo de generaciones sucesivas.
Revisar la PapelTodo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!. Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Más de 47 000 suscriptores de ML en Reddit
Encuentra lo próximo Seminarios web sobre IA aquí

Aswin AK es pasante de consultoría en MarkTechPost. Está cursando su doble titulación en el Instituto Indio de Tecnología de Kharagpur. Le apasionan la ciencia de datos y el aprendizaje automático, y cuenta con una sólida formación académica y experiencia práctica en la resolución de desafíos reales interdisciplinarios.