
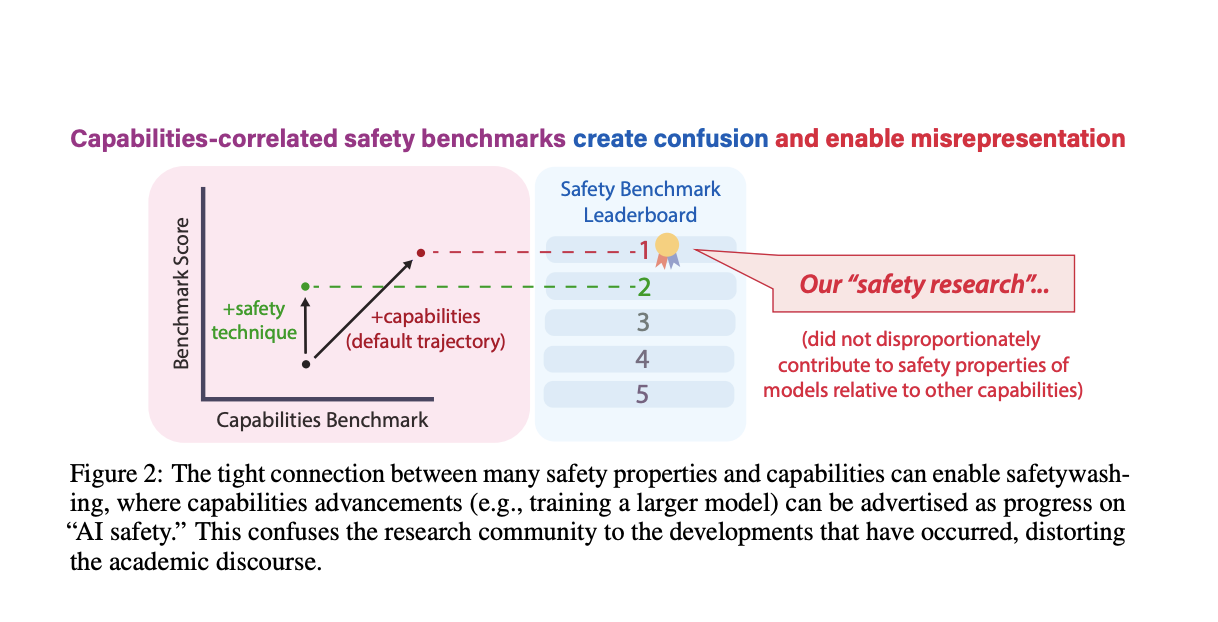
Garantizar la seguridad de los sistemas de IA cada vez más potentes es una preocupación fundamental. La investigación actual sobre seguridad de la IA tiene como objetivo abordar los riesgos emergentes y futuros mediante el desarrollo de parámetros de referencia que midan diversas propiedades de seguridad, como la imparcialidad, la fiabilidad y la solidez. Sin embargo, el campo sigue estando mal definido, y los parámetros de referencia suelen reflejar capacidades generales de la IA en lugar de mejoras genuinas de seguridad. Esta ambigüedad puede dar lugar a un “lavado de imagen de la seguridad”, en el que los avances en las capacidades se presentan erróneamente como avances en materia de seguridad, lo que no garantiza que los sistemas de IA sean realmente más seguros. Abordar este desafío es esencial para avanzar en la investigación sobre la IA y garantizar que las medidas de seguridad sean significativas y eficaces.
Los métodos existentes para garantizar la seguridad de la IA implican parámetros de referencia diseñados para evaluar atributos como la imparcialidad, la fiabilidad y la solidez frente a los adversarios. Los parámetros de referencia más comunes incluyen pruebas de alineación de modelos con las preferencias humanas, evaluaciones de sesgo y métricas de calibración. Sin embargo, estos parámetros de referencia tienen limitaciones significativas. Muchos están altamente correlacionados con las capacidades generales de la IA, lo que significa que las mejoras en estos parámetros de referencia suelen ser resultado de mejoras generales del rendimiento en lugar de mejoras específicas de la seguridad. Esta confusión hace que las mejoras de las capacidades se presenten erróneamente como avances en la seguridad, lo que no garantiza que los sistemas de IA sean realmente más seguros.
Un equipo de investigadores del Centro para la Seguridad de la IA, la Universidad de Pensilvania, la Universidad de California en Berkeley, la Universidad de Stanford, la Universidad de Yale y la Universidad de Keio presenta un novedoso enfoque empírico para distinguir el verdadero progreso en materia de seguridad de las mejoras generales en materia de capacidad. Los investigadores realizan un metaanálisis de varios parámetros de referencia de seguridad de la IA y miden su correlación con las capacidades generales en numerosos modelos. Este análisis revela que muchos parámetros de referencia de seguridad están correlacionados de hecho con las capacidades generales, lo que conduce a un posible lavado de imagen de la seguridad. La innovación radica en la base empírica para desarrollar métricas de seguridad más significativas que se distingan de los avances genéricos en materia de capacidad. Al definir la seguridad de la IA en un contexto de aprendizaje automático como un conjunto de objetivos de investigación claramente separables, los investigadores pretenden crear un marco riguroso que mida realmente el progreso en materia de seguridad, lo que hace avanzar la ciencia de las evaluaciones de seguridad.

La metodología implica la recopilación de puntuaciones de rendimiento de varios modelos en numerosos parámetros de seguridad y capacidad. Las puntuaciones se normalizan y se analizan mediante el análisis de componentes principales (PCA) para obtener una puntuación de capacidades generales. A continuación, se calcula la correlación entre esta puntuación de capacidades y las puntuaciones de los parámetros de seguridad mediante la correlación de Spearman. Este enfoque permite identificar qué parámetros miden las propiedades de seguridad independientemente de las capacidades generales y cuáles no. Los investigadores utilizan un conjunto diverso de modelos y parámetros para garantizar resultados sólidos, incluidos modelos ajustados para tareas específicas y modelos generales, así como parámetros para la alineación, el sesgo, la solidez adversaria y la calibración.
Los resultados de este estudio revelan que muchos parámetros de referencia de seguridad de la IA están altamente correlacionados con las capacidades generales, lo que indica que las mejoras en estos parámetros de referencia a menudo surgen de mejoras generales del rendimiento en lugar de avances específicos en materia de seguridad. Por ejemplo, el parámetro de referencia de alineación MT-Bench muestra una correlación de capacidades del 78,7 %, lo que sugiere que las puntuaciones de alineación más altas se deben principalmente a las capacidades generales del modelo. Por el contrario, el parámetro de referencia MACHIAVELLI para las propensiones éticas muestra una baja correlación con las capacidades generales, lo que demuestra su eficacia para medir distintos atributos de seguridad. Esta distinción es crucial, ya que destaca el riesgo de lavado de imagen, en el que las mejoras en los parámetros de referencia de seguridad de la IA pueden malinterpretarse como un progreso genuino en materia de seguridad cuando son simplemente reflejos de mejoras generales de la capacidad. Hacer hincapié en la necesidad de parámetros de referencia que midan de forma independiente las propiedades de seguridad garantiza que los avances en materia de seguridad de la IA sean significativos y no simplemente mejoras superficiales.
En conclusión, los investigadores aportan una claridad empírica sobre la medición de la seguridad de la IA. Al demostrar que muchos de los parámetros de referencia actuales están altamente correlacionados con las capacidades generales, se destaca la necesidad de desarrollar parámetros de referencia que realmente midan las mejoras de seguridad. La solución propuesta implica la creación de un conjunto de objetivos de investigación de seguridad empíricamente separables, asegurando que los avances en la seguridad de la IA no sean meros reflejos de mejoras de la capacidad general, sino mejoras genuinas en la fiabilidad y la confianza de la IA. Este trabajo tiene el potencial de influir significativamente en la investigación de la seguridad de la IA al proporcionar un marco más riguroso para evaluar el progreso de la seguridad.
Revisar la PapelTodo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!. Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Más de 47 000 suscriptores de ML en Reddit
Encuentra lo próximo Seminarios web sobre IA aquí

Aswin AK es pasante de consultoría en MarkTechPost. Está cursando su doble titulación en el Instituto Indio de Tecnología de Kharagpur. Le apasionan la ciencia de datos y el aprendizaje automático, y cuenta con una sólida formación académica y experiencia práctica en la resolución de desafíos reales interdisciplinarios.