
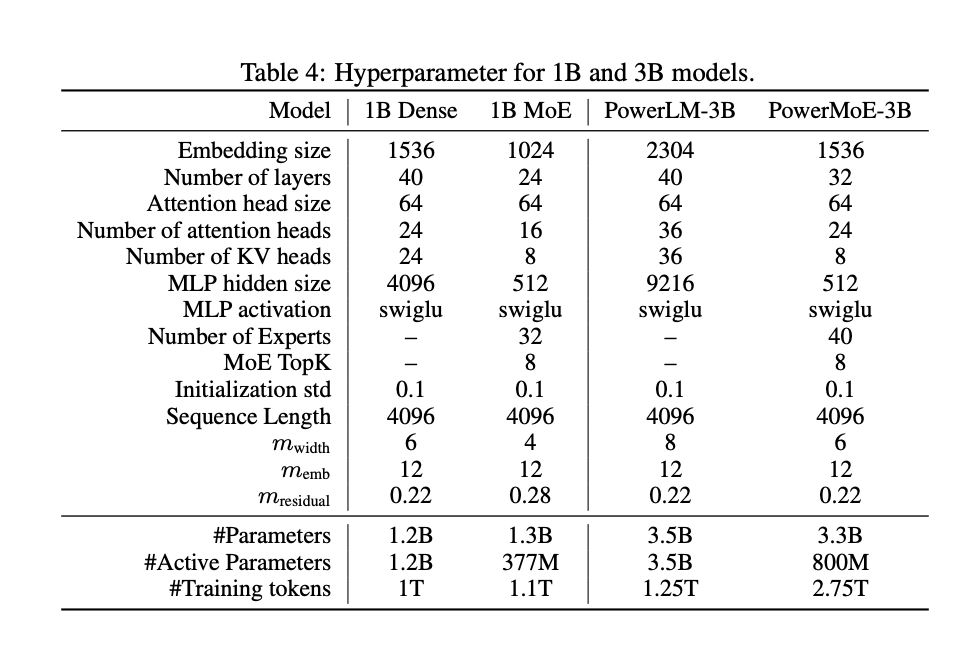
Lanzamiento de IBM de Potencia LM-3B y PotenciaMoE-3B significa un salto significativo en el esfuerzo por mejorar la eficiencia y la escalabilidad del entrenamiento de modelos de lenguaje. IBM ha presentado estos modelos basados en metodologías innovadoras que abordan algunos de los desafíos clave que enfrentan los investigadores y desarrolladores en el entrenamiento de modelos a gran escala. Estos modelos, construidos sobre Programador de energía de IBMdemuestran el compromiso de IBM de avanzar en las capacidades de IA y al mismo tiempo optimizar los costos computacionales.
Antecedentes sobre los modelos de lenguaje de gran tamaño
Los modelos de lenguaje se han vuelto fundamentales para muchas aplicaciones de inteligencia artificial, desde la atención al cliente automatizada hasta los sistemas avanzados de comprensión del lenguaje natural. Los modelos de lenguaje a gran escala, como GPT, LLaMA y otros, han demostrado ser eficaces para generar texto coherente, comprender el contexto y resolver problemas complejos que requieren razonamiento. Sin embargo, el entrenamiento de estos modelos requiere una enorme cantidad de recursos computacionales. La configuración óptima de hiperparámetros, como la tasa de aprendizaje, el tamaño del lote y la cantidad de tokens, es crucial para garantizar la eficacia de estos modelos durante el entrenamiento. A pesar de las mejoras realizadas por los modelos anteriores, optimizar estos hiperparámetros sigue siendo una tarea desafiante, especialmente cuando se escalan a miles de millones de parámetros.
El problema de la programación de la tasa de aprendizaje
La tasa de aprendizaje es uno de los hiperparámetros más cruciales al entrenar redes neuronales profundas, especialmente las LLM. Una tasa de aprendizaje bien elegida garantiza una convergencia más rápida y evita el sobreajuste. Los programadores de tasa de aprendizaje tradicionales, como el programador de coseno, se han adoptado ampliamente para entrenar modelos grandes. Sin embargo, a menudo requieren predefinir la cantidad de pasos de entrenamiento y no son lo suficientemente flexibles para adaptarse a los datos cambiantes durante el entrenamiento. Además, los puntos de control intermedios durante el entrenamiento suelen ser subóptimos, lo que genera ineficiencias al reanudar el entrenamiento después de las interrupciones. Este problema se vuelve aún más complejo a medida que aumentan el tamaño del modelo, el tamaño del lote y los tokens de entrenamiento.
El programador Power de IBM tiene como objetivo resolver estos problemas mediante la introducción de un programador de tasa de aprendizaje independiente del tamaño del lote y la cantidad de tokens. Esto garantiza que el modelo se pueda entrenar de manera eficiente independientemente de estas variables. El programador Power se basa en una relación de ley de potencia entre la tasa de aprendizaje y la cantidad de tokens de entrenamiento. Permite que el modelo ajuste su tasa de aprendizaje de manera dinámica durante el entrenamiento sin especificar la cantidad de pasos de entrenamiento de antemano.
Programador de energía de IBM
El programador de potencia se desarrolló para superar las limitaciones de los programadores de tasa de aprendizaje existentes. Uno de los principales problemas de los programadores tradicionales, como el programador de coseno, es que requieren que se defina de antemano la cantidad de pasos de entrenamiento. Esta falta de flexibilidad es particularmente problemática para los modelos a gran escala, donde es difícil predecir cuántos tokens o pasos de entrenamiento se necesitarán para un rendimiento óptimo.
El programador de potencia presenta un enfoque flexible que ajusta la tasa de aprendizaje en función de la cantidad de tokens de entrenamiento y el tamaño de los lotes. Una ecuación de ley de potencia modela la relación entre estas variables, lo que garantiza que la tasa de aprendizaje se mantenga óptima durante todo el proceso de entrenamiento, incluso cuando cambia la cantidad de tokens de entrenamiento.
Una de las principales ventajas del programador de Power Scheduler es que permite un entrenamiento continuo sin sacrificar el rendimiento. Esto resulta especialmente útil para las organizaciones que desean ajustar sus modelos después de la fase de entrenamiento inicial o ajustar los datos de entrenamiento durante el proceso de entrenamiento. La capacidad de reanudar el entrenamiento desde cualquier punto de control sin volver a optimizar la tasa de aprendizaje garantiza que el entrenamiento sea eficiente y eficaz.
Modelos PowerLM-3B y PowerMoE-3B
La introducción de los modelos PowerLM-3B y PowerMoE-3B es una demostración práctica de los beneficios del planificador Power. Ambos modelos se entrenaron con el planificador Power de IBM y muestran un rendimiento de vanguardia en diversas tareas de procesamiento de lenguaje natural.
PowerLM-3B es un modelo de transformador denso con 3 mil millones de parámetros. Se entrenó utilizando una combinación de conjuntos de datos de código abierto de alta calidad y corpus sintéticos durante un período de entrenamiento de 1,25 billones de tokens. La arquitectura del modelo denso garantiza que todos los parámetros del modelo estén activos durante la inferencia, lo que proporciona un rendimiento constante en varias tareas.
A pesar de que se entrena con menos tokens que otros modelos de última generación, PowerLM-3B demuestra un rendimiento comparable al de modelos más grandes. Esto resalta la eficiencia del programador de Power para garantizar que el modelo pueda aprender de manera efectiva incluso con una cantidad limitada de tokens de entrenamiento.
PowerMoE-3B es un modelo de combinación de expertos (MoE) que utiliza la innovadora arquitectura MoE de IBM. A diferencia de los modelos densos, los modelos MoE activan solo un subconjunto de los parámetros del modelo durante la inferencia, lo que los hace más eficientes computacionalmente. PowerMoE-3B, con sus 3 mil millones de parámetros, activa solo 800 millones de parámetros durante la inferencia, lo que reduce significativamente los costos computacionales y mantiene un alto rendimiento.
PowerMoE-3B se entrenó con 2,5 billones de tokens, utilizando una combinación de datos similar a la de PowerLM-3B. La arquitectura de combinación de expertos, combinada con el programador Power, permite que este modelo alcance un rendimiento comparable al de los modelos densos con muchos más parámetros, lo que demuestra la escalabilidad y la eficiencia del enfoque MoE.
Aplicaciones y rendimiento en el mundo real
Se evaluaron PowerLM-3B y PowerMoE-3B en diversas tareas de procesamiento de lenguaje natural, incluidas la respuesta a preguntas de opción múltiple, el razonamiento de sentido común y la generación de código. Los resultados muestran que estos modelos tienen un rendimiento competitivo con otros modelos de última generación a pesar de haber sido entrenados con menos tokens y de utilizar menos parámetros activos durante la inferencia en el caso de PowerMoE-3B.
Por ejemplo, PowerLM-3B logró puntuaciones altas en tareas como ARC (AI2 Reasoning Challenge) y PIQA (Physical Interaction Question Answering), superando a muchos modelos con un recuento de parámetros similar. PowerMoE-3B, por otro lado, se destacó en tareas que requerían eficiencia computacional, logrando resultados competitivos con costos de inferencia mucho más bajos.
Estos resultados resaltan el potencial del planificador Power de IBM y la arquitectura MoE para revolucionar la forma en que se entrenan e implementan los modelos de lenguaje de gran tamaño. Al optimizar la tasa de aprendizaje y reducir los requisitos computacionales, estos modelos ofrecen un camino a seguir para las organizaciones que buscan aprovechar los modelos de lenguaje avanzados sin incurrir en los enormes costos asociados con los modelos densos tradicionales.
Conclusión
El lanzamiento de PowerLM-3B y PowerMoE-3B por parte de IBM marca un avance fundamental en los LLM y el NLP. El innovador programador Power de IBM ha demostrado ser una herramienta muy eficaz para optimizar el proceso de entrenamiento de estos modelos, lo que permite un entrenamiento más eficiente y una mejor escalabilidad. Con la combinación de arquitecturas densas y mixtas de expertos, IBM ha proporcionado un marco sólido para crear modelos de IA potentes que pueden desempeñarse bien en diversas tareas y, al mismo tiempo, reducir la sobrecarga computacional.
Echa un vistazo a la Modelo y Relacionado PapelTodo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!. Si te gusta nuestro trabajo, te encantará nuestro hoja informativa..
No olvides unirte a nuestro Subreddit con más de 50 000 millones de usuarios
Asif Razzaq es el director ejecutivo de Marktechpost Media Inc. Como ingeniero y emprendedor visionario, Asif está comprometido con aprovechar el potencial de la inteligencia artificial para el bien social. Su iniciativa más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, Marktechpost, que se destaca por su cobertura en profundidad de noticias sobre aprendizaje automático y aprendizaje profundo que es técnicamente sólida y fácilmente comprensible para una amplia audiencia. La plataforma cuenta con más de 2 millones de visitas mensuales, lo que ilustra su popularidad entre el público.