
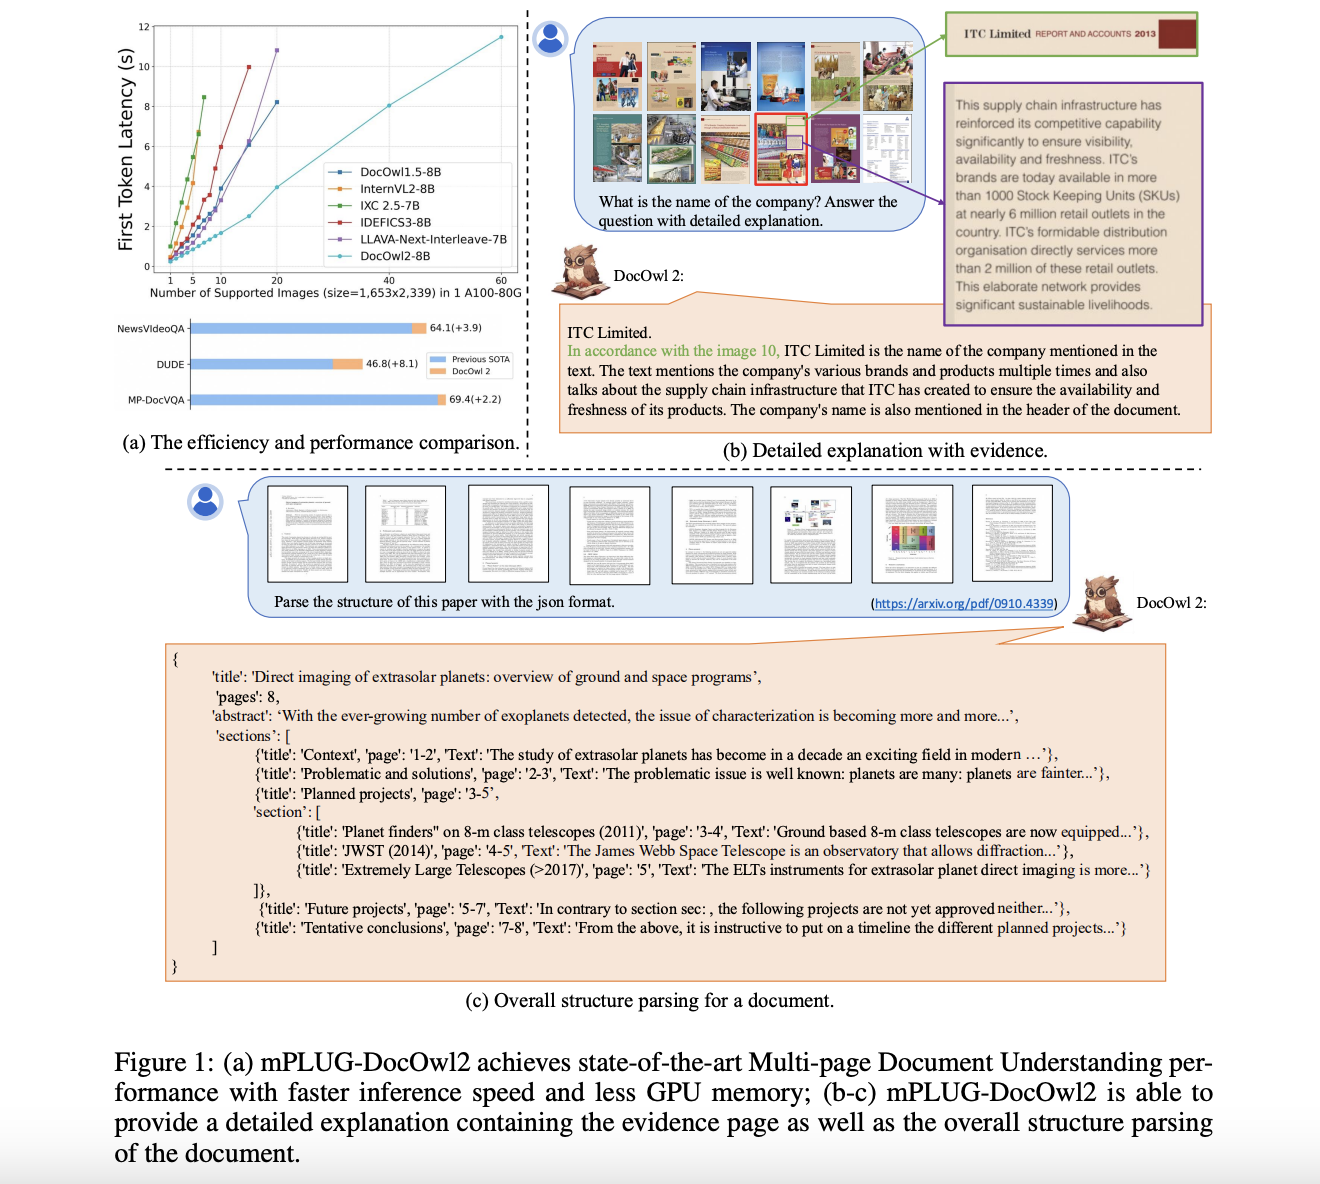
Comprender documentos de varias páginas y vídeos de noticias es una tarea común en la vida diaria de las personas. Para abordar estos escenarios, los modelos de lenguaje multimodales de gran tamaño (MLLM) deben estar equipados con la capacidad de comprender múltiples imágenes con información de texto rica y ubicada visualmente. Sin embargo, comprender imágenes de documentos es más desafiante que las imágenes naturales, ya que requiere una percepción más detallada para reconocer todos los textos. Los enfoques existentes agregan un codificador de alta resolución o recortan imágenes de alta resolución en subimágenes de baja resolución, ambos con limitaciones.
Los investigadores anteriores han intentado resolver el desafío de comprender imágenes de documentos utilizando diversas técnicas. Algunos trabajos propusieron agregar un codificador de alta resolución para capturar mejor la información textual de grano fino en imágenes de documentos. Otros optaron por recortar imágenes de alta resolución en subimágenes de baja resolución y dejar que el Modelo de Lenguaje Grande entienda su relación.
Si bien estos enfoques han logrado un rendimiento prometedor, sufren un problema común: la gran cantidad de tokens visuales necesarios para representar una sola imagen de documento. Por ejemplo, el modelo InternVL 2 cuesta un promedio de 3k tokens visuales en el punto de referencia de comprensión de documentos de una sola página DocVQA. Esas secuencias de tokens visuales tan largas no solo dan como resultado tiempos de inferencia prolongados, sino que también ocupan una cantidad significativa de memoria de GPU, lo que limita en gran medida su aplicación en escenarios que implican la comprensión de documentos o videos completos.
Investigadores de Alibaba Group y la Universidad Renmin de China han propuesto una arquitectura de compresión robusta llamada DocCompressor de alta resolución. Este método utiliza las características visuales de una imagen global de baja resolución como guía de compresión (consulta), ya que el mapa de características globales puede capturar de manera efectiva la información de diseño general del documento.
En lugar de ocuparse de todas las características de alta resolución, el compresor de documentos de alta resolución recopila un grupo de características de alta resolución con posiciones relativas idénticas en la imagen original que los objetos comprimidos para cada consulta del mapa de características global. Este enfoque que tiene en cuenta el diseño ayuda a resumir mejor la información de texto dentro de una región de diseño específica.
Además, los investigadores sostienen que comprimir las características visuales después del módulo de visión a texto del Modelo de Lenguaje Multimodal Grande puede mantener mejor la semántica textual en las imágenes del documento, ya que esto es análogo a resumir textos en el Procesamiento del Lenguaje Natural.
El modelo DocOwl2 utiliza un módulo de recorte adaptable a la forma y un codificador de visión de baja resolución para codificar imágenes de documentos de alta resolución. El módulo de recorte adaptable a la forma corta la imagen original en múltiples subimágenes de baja resolución, y el codificador de visión de baja resolución se utiliza para codificar tanto las subimágenes como la imagen global. A continuación, el modelo utiliza un módulo de visión a texto llamado H-Reducer para agrupar las características visuales horizontales y alinear la dimensión de las características visuales con el modelo de lenguaje grande. Además de eso, DocOwl2 incluye un compresor de alta resolución, que es el componente clave del compresor de documentos de alta resolución. Este compresor utiliza las características visuales de la imagen global de baja resolución como consulta y recopila un grupo de características de alta resolución con posiciones relativas idénticas en la imagen original como objetos de compresión para cada consulta. Este enfoque consciente del diseño ayuda a resumir mejor la información de texto dentro de una región de diseño específica. Finalmente, los tokens visuales comprimidos de múltiples imágenes o páginas se concatenan con instrucciones de texto y se ingresan a un Modelo de Lenguaje Grande para una comprensión multimodal.

Los investigadores compararon el modelo DocOwl2 con modelos de lenguaje grande multimodales de última generación en 10 puntos de referencia de comprensión de documentos de una sola imagen, 2 puntos de referencia de comprensión de documentos de varias páginas y 1 punto de referencia de comprensión de videos con mucho texto. Consideraron tanto el rendimiento de respuesta a preguntas (medido por ANLS) como la latencia del primer token (en segundos) para evaluar la eficacia de su modelo. Para la tarea de comprensión de documentos de una sola imagen, los investigadores dividieron las líneas de base en tres grupos: (a) modelos sin modelos de lenguaje grande como decodificadores, (b) LLM multimodales con un promedio de más de 1000 tokens visuales por imagen de documento y (c) LLM multimodales con menos de 1000 tokens visuales.
Los resultados muestran que, si bien los modelos específicamente ajustados en cada conjunto de datos posteriores tuvieron un buen desempeño, los LLM multimodales demostraron el potencial para la comprensión generalizada de documentos sin OCR. En comparación con otros LLM multimodales con menos de 1000 tokens visuales, el modelo DocOwl2 logró un desempeño mejor o comparable en los 10 puntos de referencia. En particular, con menos tokens visuales, DocOwl2 superó a modelos como TextMonkey y TokenPacker, que también apuntaban a comprimir tokens visuales, lo que demuestra la efectividad del DocCompressor de alta resolución.
Además, en comparación con los LLM multimodales de última generación con más de 1000 tokens visuales, el modelo DocOwl2 logró más del 80 % de su rendimiento mientras utilizaba menos del 20 % de los tokens visuales. Para las tareas de comprensión de documentos de varias páginas y comprensión de videos con mucho texto, el modelo DocOwl2 también demostró un rendimiento superior y una latencia del primer token significativamente menor en comparación con otros LLM multimodales que pueden recibir más de 10 imágenes con una sola GPU A100-80G.
Este estudio presenta mPLUG-DocOwl2un modelo de lenguaje grande multimodal capaz de comprender documentos de varias páginas sin OCR de manera eficiente. La sólida arquitectura de alta resolución DocCompressor comprime cada imagen de documento de alta resolución en solo 324 tokens utilizando la atención cruzada con características visuales globales como guía. En los puntos de referencia de una sola imagen, DocOwl2 supera los métodos de compresión existentes y se equipara a los MLLM de última generación mientras utiliza menos tokens visuales. También logra un rendimiento de última generación sin OCR en tareas de comprensión de documentos de varias páginas y videos ricos en texto con una latencia mucho menor. Los investigadores enfatizan que el uso de miles de tokens visuales por página de documento a menudo es redundante y un desperdicio de recursos computacionales. Esperan que DocOwl2 llame la atención sobre el equilibrio entre la representación eficiente de imágenes y la comprensión de documentos de alto rendimiento.
Echa un vistazo a la Papel y GitHub. Todo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y LinkedInÚnete a nuestro Canal de Telegram.
Si te gusta nuestro trabajo, te encantará nuestro hoja informativa..
No olvides unirte a nuestro Subreddit con más de 50 000 millones de usuarios

Asjad es consultor en prácticas en Marktechpost. Está cursando la licenciatura en ingeniería mecánica en el Instituto Indio de Tecnología de Kharagpur. Asjad es un entusiasta del aprendizaje automático y del aprendizaje profundo que siempre está investigando las aplicaciones del aprendizaje automático en el ámbito de la atención médica.