
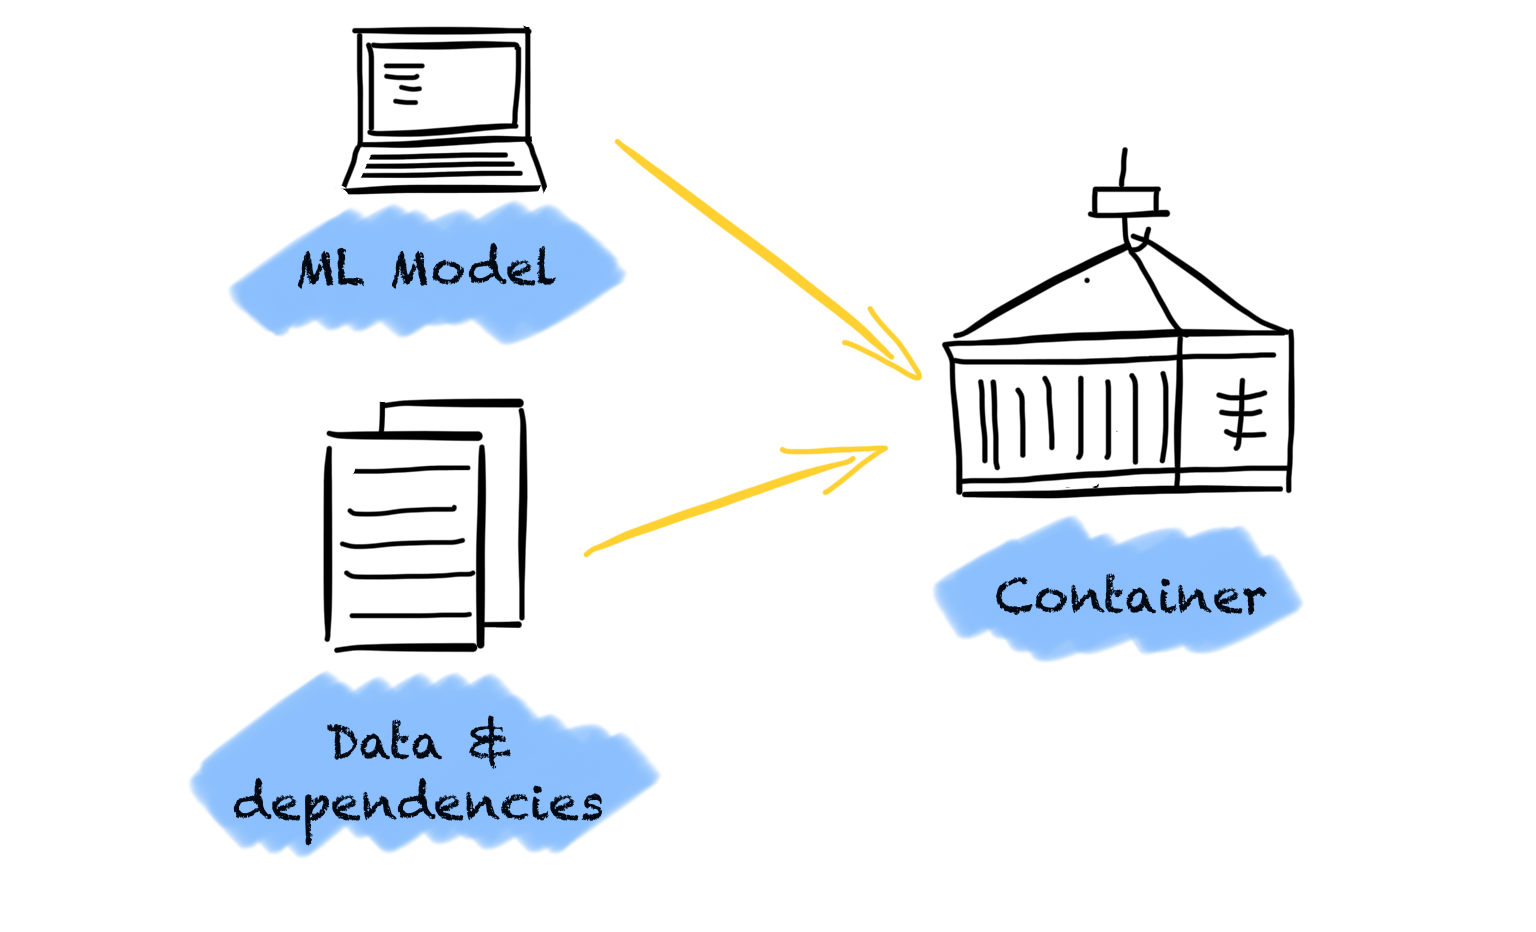
Un ML para ser útil debe funcionar en algún lugar. Es muy probable que este en algún lugar no sea su máquina local. Un modelo no tan bueno que se ejecuta en un entorno de producción es mejor que un modelo perfecto que nunca deja su máquina local.
Sin embargo, la máquina de producción suele ser diferente de la que desarrolló el modelo. Entonces, envías el modelo a la máquina de producción, pero de alguna manera el modelo ya no funciona. Eso es extraño, ¿verdad? Probaste todo en tu máquina local y funcionó bien. Incluso escribiste pruebas unitarias.
¿Qué pasó? Lo más probable es que la máquina de producción difiera de su máquina local. Quizás no tenga todas las dependencias necesarias instaladas para ejecutar su modelo. Quizás las dependencias instaladas están en una versión diferente. Puede haber muchas razones para esto.
¿Cómo puedes resolver este problema? Un enfoque podría ser replicar exactamente la máquina de producción. Pero eso es muy inflexible en cuanto a cada nueva máquina de producción que necesitaría para construir una réplica local.
Un enfoque mucho mejor es usar Estibador contenedores.
Docker es una herramienta que nos ayuda a crear, administrar y ejecutar código y aplicaciones en contenedores. Un contenedor es un pequeño entorno informático aislado en el que podemos empaquetar una aplicación con todas sus dependencias. En nuestro caso, nuestro modelo ML con todas las bibliotecas que necesita ejecutar. Con esto, no necesitamos confiar en lo que está instalado en la máquina host. A Contenedor de acopolador nos permite separar las aplicaciones de la infraestructura subyacente.
Por ejemplo, empaquetamos nuestro modelo ML localmente y lo empujamos a la nube. Con esto, Docker nos ayuda a asegurarnos de que nuestro modelo pueda ejecutarse en cualquier lugar y en cualquier momento. El uso de Docker tiene varias ventajas para nosotros. Nos ayuda a entregar nuevos modelos más rápido, mejorar la reproducibilidad y facilitar la colaboración. Todo porque tenemos exactamente las mismas dependencias sin importar dónde ejecutemos el contenedor.
Como Docker se usa ampliamente en la industria, los científicos de datos deben poder construir y ejecutar contenedores usando Docker. Por lo tanto, en este artículo, revisaré el concepto básico de contenedores. Te mostraré todo lo que necesitas saber sobre Docker para comenzar. Después de haber cubierto la teoría, le mostraré cómo puede construir y ejecutar su propio contenedor Docker.
¿Qué es un contenedor?
Un contenedor es un entorno pequeño y aislado en el que todo es autónomo. El entorno empaqueta todos los códigos y dependencias.
Un contenedor tiene cinco características principales.
- autónomo: Un contenedor aísla la aplicación/software, de su entorno/infraestructura. Debido a este aislamiento, no necesitamos confiar en ninguna dependencia preinstalada en la máquina host. Todo lo que necesitamos es parte del contenedor. Esto asegura que la aplicación siempre pueda ejecutarse independientemente de la infraestructura.
- aislado: El contenedor tiene una influencia mínima en el huésped y otros contenedores y viceversa.
- independiente: Podemos administrar contenedores de forma independiente. Eliminar un contenedor no afecta a otros contenedores.
- portátil: Como un contenedor aísla el software del hardware, podemos ejecutarlo sin problemas en cualquier máquina. Con esto, podemos moverlo entre máquinas sin problemas.
- ligero: Los contenedores son livianos ya que comparten el sistema operativo de la máquina host. Como no requieren su propio sistema operativo, no necesitamos dividir el recurso de hardware de la máquina host.
Esto puede sonar similar a las máquinas virtuales. Pero hay una gran diferencia. La diferencia es en cómo usan los recursos de su computadora host. Las máquinas virtuales son una abstracción del hardware físico. Participan un servidor en múltiples. Por lo tanto, una VM incluye una copia completa del sistema operativo que ocupa más espacio.
En contraste, los contenedores son una abstracción en la capa de aplicación. Todos los contenedores comparten el sistema operativo del host pero se ejecutan en procesos aislados. Debido a que los contenedores no contienen un sistema operativo, son más eficientes en el uso del sistema y recursos subyacentes reduciendo la sobrecarga.
Ahora sabemos qué son los contenedores. Obtengamos una comprensión de alto nivel de cómo funciona Docker. Introduciré brevemente los términos técnicos que se usan a menudo.
¿Qué es Docker?
Para comprender cómo funciona Docker, echemos un vistazo breve a su arquitectura.
Docker utiliza una arquitectura de cliente cliente que contiene tres partes principales: un cliente de Docker, un Docker Daemon (servidor) y un registro de Docker.
El cliente Docker es la forma principal de interactuar con Docker a través de los comandos. Usamos el cliente para comunicarnos a través de una API REST con tantos Docker Daemons como queramos. Los comandos utilizados a menudo son Docker Run, Docker Build, Docker Pull y Docker Push. Explicaré más tarde lo que hacen.
El Docker Daemon maneja objetos Docker, como imágenes y contenedores. El Daemon escucha las solicitudes de la API de Docker. Dependiendo de la solicitud, el demonio construye, ejecuta y distribuye contenedores Docker. El Docker Daemon y el cliente pueden ejecutarse en los mismos o diferentes sistemas.
El Registro de Docker es una ubicación centralizada que almacena y administra imágenes de Docker. Podemos usarlas para compartir imágenes y hacerlas accesibles para otros.
¿Suena un poco abstracto? No se preocupe, una vez que comencemos, será más intuitivo. Pero antes de eso, pasemos por los pasos necesarios para crear un contenedor Docker.

¿Qué necesitamos para crear un contenedor Docker?
Es simple. Solo necesitamos hacer tres pasos:
- Crea un Dockerfile
- Construya una imagen Docker desde Dockerfile
- Ejecute la imagen Docker para crear un contenedor Docker
Vamos paso a paso.
Un DockerFile es un archivo de texto que contiene instrucciones sobre cómo construir una imagen de Docker. En el Dockerfile definimos cómo se ve la aplicación y sus dependencias. También declaramos qué proceso debe ejecutar al lanzar el contenedor Docker. El DockerFile está compuesto por capas, que representa una parte del sistema de archivos de la imagen. Cada capa agrega, elimina o modifica la capa debajo de ella.
Basado en Dockerfile, creamos una imagen Docker. La imagen es una plantilla de solo lectura con instrucciones para ejecutar un contenedor Docker. Las imágenes son inmutables. Una vez que creamos una imagen de Docker, ya no podemos modificarla. Si queremos hacer cambios, solo podemos agregar cambios sobre las imágenes existentes o crear una nueva imagen. Cuando reconstruimos una imagen, Docker es lo suficientemente inteligente como para reconstruir solo capas que han cambiado, reduciendo el tiempo de construcción.
Un contenedor Docker es una instancia ejecutable de una imagen Docker. El contenedor está definido por la imagen y cualquier opción de configuración que proporcionemos al crear o iniciar el contenedor. Cuando eliminamos un contenedor, todos los cambios a sus estados internos también se eliminan si no se almacenan en un almacenamiento persistente.
Usando Docker: un ejemplo
Con toda la teoría, nos ensucie las manos y juntemos todo.
Como ejemplo, empaquetaremos un modelo ML simple con frasco en un contenedor Docker. Luego podemos ejecutar solicitudes contra el contenedor y recibir predicciones a cambio. Entrenaremos un modelo localmente y solo cargaremos los artefactos del modelo capacitado en el contenedor Docker.
Revisaré el flujo de trabajo general necesario para crear y ejecutar un contenedor Docker con su modelo ML. Te guiaré a través de los siguientes pasos:
- modelo de construcción
- crear
requirements.txtArchivo que contiene todas las dependencias - crear
Dockerfile - Imagen de Docker de construcción
- Ejecutar contenedor
Antes de comenzar, necesitamos instalar Docker Desktop. Lo usaremos para ver y ejecutar nuestros contenedores Docker más adelante.
1. Construye un modelo
Primero, capacitaremos un simple clasificador RandomForest en scikit-learnSet DataSet de Iris y luego almacene el modelo capacitado.
En segundo lugar, construimos un script que pone a disposición nuestro modelo a través de una API REST, usando Flask. El script también es simple y contiene tres pasos principales:
- Extraiga y convierta los datos que queremos pasar al modelo de la carga útil JSON
- Cargue los artefactos del modelo y cree una sesión de ONNX y ejecute el modelo
- devolver las predicciones del modelo como JSON
Tomé la mayor parte del código de aquí y aquí e hizo solo cambios menores.
2. Crear requisitos
Una vez que hemos creado el archivo de Python que queremos ejecutar cuando el contenedor Docker se está ejecutando, debemos crear un requirements.txt archivo que contiene todas las dependencias. En nuestro caso, se ve así:
3. Crea Dockerfile
Lo último que debemos preparar antes de poder construir una imagen Docker y ejecutar un contenedor Docker es escribir un DockerFile.
DockerFile contiene todas las instrucciones necesarias para construir la imagen Docker. Las instrucciones más comunes son
FROM <image>– Esto especifica la imagen base que la compilación extenderá.WORKDIR <path>– Esta instrucción especifica el “directorio de trabajo” o la ruta en la imagen donde se copiarán los archivos y se ejecutarán los comandos.COPY <host-path><image-path>– Esta instrucción le dice al constructor que copie archivos del host y los coloque en la imagen del contenedor.RUN <command>– Esta instrucción le dice al constructor que ejecute el comando especificado.ENV <name><value>– Esta instrucción establece una variable de entorno que utilizará un contenedor en ejecución.EXPOSE <port-number>– Esta instrucción establece la configuración en la imagen que indica un puerto que la imagen desea exponer.USER <user-or-uid>– Esta instrucción establece el usuario predeterminado para todas las instrucciones posteriores.CMD ["<command>", "<arg1>"]– Esta instrucción establece el comando predeterminado que se ejecutará un contenedor usando esta imagen.
Con estos, podemos crear DockerFile para nuestro ejemplo. Necesitamos seguir los siguientes pasos:
- Determinar la imagen base
- Instalar dependencias de aplicaciones
- Copiar en cualquier código fuente relevante y/o binarios
- Configurar la imagen final
Veamos a través de ellos paso a paso. Cada uno de estos pasos da como resultado una capa en la imagen Docker.
Primero, especificamos la imagen base sobre la que luego construimos. Como hemos escrito en el ejemplo en Python, usaremos una imagen base de Python.
En segundo lugar, establecemos el directorio de trabajo en el que copiaremos todos los archivos que necesitamos para poder ejecutar nuestro modelo ML.
En tercer lugar, actualizamos los archivos de índice de paquetes para garantizar que tengamos la última información disponible sobre paquetes y sus versiones.
Cuarto, copiamos e instalamos las dependencias de la aplicación.
Quinto, copiamos en el código fuente y en todos los demás archivos que necesitamos. Aquí, también exponemos el puerto 8080, que utilizaremos para interactuar con el modelo ML.
Sexto, establecemos un usuario, para que el contenedor no se ejecute como usuario root
Séptimo, definimos que el example.py El archivo se ejecutará cuando ejecutemos el contenedor Docker. Con esto, creamos el servidor Flask para ejecutar nuestras solicitudes.
Además de crear el DockerFile, también podemos crear un .dockerignore archivo para mejorar la velocidad de compilación. Similar a un .gitignore Archivo, podemos excluir directorios del contexto de compilación.
Si quieres saber más, ve a docker.com.
4. Crear imagen de Docker
Después de crear todos los archivos que necesitábamos para construir la imagen Docker.
Para construir la imagen, primero debemos abrir Docker Desktop. Puede verificar si Docker Desktop se está ejecutando ejecutándose docker ps en la línea de comando. Este comando muestra que todos ejecutan contenedores.
Para construir una imagen de Docker, necesitamos estar al mismo nivel que nuestro DockerFile y requirements.txt archivo. Entonces podemos correr docker build -t our_first_image . El -t la bandera indica el nombre de la imagen, es decir, our_first_imagey el . nos dice que construamos a partir de este directorio actual.
Una vez que construimos la imagen, podemos hacer varias cosas. Podemos
- Ver la imagen ejecutando
docker image ls - ver la historia o cómo se creó la imagen ejecutándose
docker image history <image_name> - Empujar la imagen a un registro ejecutando
docker push <image_name>
5. Ejecutar contenedor de Docker
Una vez que hemos construido la imagen de Docker, podemos ejecutar nuestro modelo ML en un contenedor.
Para esto, solo necesitamos ejecutar docker run -p 8080:8080 <image_name> en la línea de comando. Con -p 8080:8080 Conectamos el puerto local (8080) con el puerto en el contenedor (8080).
Si la imagen de Docker no expone un puerto, simplemente podríamos ejecutar docker run <image_name>. En lugar de usar el image_nametambién podemos usar el image_id.
De acuerdo, una vez que el contenedor se está ejecutando, realicemos una solicitud en su contra. Para esto, enviaremos una carga útil al punto final ejecutando curl X POST http://localhost:8080/invocations -H "Content-Type:application/json" -d @.path/to/sample_payload.json
Conclusión
En este artículo, le mostré los conceptos básicos de los contenedores Docker, lo que son y cómo construirlos usted mismo. Aunque solo arañé la superficie, debería ser suficiente para comenzar y poder empaquetar su próximo modelo. Con este conocimiento, debe poder evitar los problemas de “funciona en mi máquina”.
Espero que encuentre útil este artículo y que lo ayude a convertirse en un mejor científico de datos.
Nos vemos en mi próximo artículo y/o deja un comentario.