
¿Sobre la construcción de sus propios agentes de IA? ¿Estás constantemente abrumado por todas las palabras de moda alrededor de los agentes? No estás solo; También he estado allí. Existen numerosas herramientas disponibles, e incluso descubrir cuál para elegir puede parecer un proyecto en sí mismo. Además, existe incertidumbre en torno al costo e infraestructura. ¿Consumiré demasiadas fichas? ¿Cómo y dónde puedo implementar mi solución?
Durante un tiempo, también dudé en construir algo por mi cuenta. Primero necesitaba entender los conceptos básicos, ver algunos ejemplos para comprender cómo funcionan las cosas y luego probar una experiencia práctica para dar vida a esos conceptos. Después de mucha investigación, finalmente aterricé sobre Crewai – Y resultó ser el punto de partida perfecto. Hay dos excelentes cursos ofrecidos por Deeplearning.ai: Sistemas de agentes de IA múltiples con Crewai Y Agentes prácticos de AI y casos de uso avanzados con Crewai. En el curso, el instructor ha explicado muy claramente todo lo que necesita saber sobre los agentes de IA para comenzar. Hay más de 10 estudios de casos con códigos proporcionados en el curso que sirve como un buen punto de partida.
Ya no es suficiente aprender sobre cosas. Si no ha aplicado lo que ha aprendido, es probable que olvide los conceptos básicos con el tiempo. Si recién vuelvo los casos de uso del curso, en realidad no está “aplicando”. Tuve que construir algo e implementarlo para mí. Decidí construir un caso de uso que estaba estrechamente relacionado con lo que trabajo. Como analista de datos e ingeniero, trabajo principalmente con Python y SQL. Pensé para mí mismo lo genial que sería si pudiera construir un asistente que generara consultas SQL basadas en el lenguaje natural. Estoy de acuerdo en que ya hay muchas soluciones fuera de caja disponibles en el mercado. No estoy tratando de reinventar la rueda aquí. Con este POC, quiero aprender cómo se construyen tales sistemas y cuáles son sus posibles limitaciones. Lo que estoy tratando de descubrir aquí es lo que se necesita para construir tal asistente.
En esta publicación, te guiaré a través de cómo usé Crewai Y RacionalizarPara construir un Asistente de SQL de múltiples agentes . Permite a los usuarios consultar un Sqlite base de datos utilizando lenguaje natural. Para tener más control sobre todo el proceso, también he incorporado un humano comprobar más que muestro el Costos de uso de LLM para cada consulta. Una vez que el asistente genere una consulta, el usuario tendrá 3 opciones: aceptar y continuar si la consulta se ve bien, solicite al asistente que vuelva a intentarlo si la consulta parece apagada o aborta todo el proceso si no funciona bien. Tener este punto de control hace una gran diferencia: le da más potencia al usuario, evita ejecutar malas consultas y también ayuda a ahorrar costos de LLM a largo plazo.
Puede encontrar todo el repositorio de código aquí. A continuación se muestra la estructura completa del proyecto:
SQL Assistant Crew Project Structure
===================================

.
├── app.py (Streamlit UI)
├── main.py (terminal)
├── crew_setup.py
├── config
│   ├── agents.yaml
│   └── tasks.yaml
├── data
│   └── sample_db.sqlite
├── utils
│   ├── db_simulator.py
│   └── helper.py
La arquitectura del agente (mi equipo de crewai)
Para mi sistema de asistente SQL, necesitaba al menos 3 agentes básicos para manejar todo el proceso de manera eficiente:
- Agente generador de consultas convertiría las preguntas del lenguaje natural del usuario en una consulta SQL utilizando el esquema de la base de datos como contexto.
- Agente de revisor de consultas Tomaría la consulta SQL generada por el agente del generador y la optimiza aún más para la precisión y la eficiencia.
- Agente de control de cumplimiento Verificaría la consulta para la posible exposición de PII y presentaría un veredicto de si la consulta cumple o no.
Cada agente debe tener 3 atributos centrales: un papel (lo que se supone que es el agente), un objetivo (cuál es la misión del agente) y una historia de fondo (establece la personalidad del agente para guiar cómo debe comportarse). Yo he habilitado verbose=“True” para ver el proceso de pensamiento interno del agente. Estoy usando el openai/gpt-4o-mini como el modelo de lenguaje subyacente para todos mis agentes. Después de mucha prueba y error, configuré el temperature=0.2 Para reducir las alucinaciones de los agentes. Las temperaturas más bajas hacen que el modelo sea más determinista y proporcione salidas predecibles (como consultas SQL en mi caso). Hay muchos otros parámetros disponibles para sintonizar como max_tokens (Establezca límites para la duración de la respuesta), top_p (para muestreo de núcleo), allow_delegation (Para delegar la tarea a otros agentes), etc. Si está utilizando otros LLM, simplemente puede especificar el nombre del modelo LLM aquí. Puede establecer la misma LLM para todos los agentes o diferentes según sus requisitos.
A continuación se muestra el archivo YAML que tiene las definiciones de los agentes:
query_generator_agent:
  role: Senior Data Analyst
  goal: Translate natural language requests into accurate and efficient SQL queries
  backstory:  >
        You are an experienced analyst who knows SQL best practices. You work with stakeholders to gather requirements
        and turn their questions into clear, performant queries. You prefer readable SQL with appropriate filters and joins.
  allow_delegation: False
  verbose: True
  model: openai/gpt-4o-mini
  temperature: 0.2

query_reviewer_agent:
  role: SQL Code Reviewer
  goal: Critically evaluate SQL for correctness, performance, and clarity
  backstory: >
        You are a meticulous reviewer of SQL code. You identify inefficiencies, bad practices, and logical errors, and
        provide suggestions to improve the query's performance and readability.
  allow_delegation: False
  verbose: True
  model: openai/gpt-4o-mini
  temperature: 0.2

compliance_checker_agent:
  role: Data Privacy and Governance Officer
  goal: Ensure SQL queries follow data compliance rules and avoid PII exposure
  backstory: >
        You are responsible for ensuring queries do not leak or expose personally identifiable information (PII) or
        violate company policies. You flag any unsafe or non-compliant practices.
  allow_delegation: False
  verbose: True
  model: openai/gpt-4o-mini
  temperature: 0.2
Una vez que haya terminado de crear sus agentes, el siguiente paso es definir las tareas que deben realizar. Cada tarea debe tener una descripción clara de lo que se supone que debe hacer el agente. Es muy recomendable que también establezca el expected_output Parámetro para dar forma a la respuesta final de la LLM. Es una forma de decirle al LLM exactamente el tipo de respuesta que espera: podría ser un texto, un número, una consulta o incluso un artículo. La descripción debe ser lo más detallada y concreta posible. Tener descripciones vagas solo dará como resultado salidas vagas o incluso completamente incorrectas. Tuve que modificar las descripciones varias veces durante la prueba para ajustar la calidad de la respuesta que el agente estaba generando. Una de las características que amo es la capacidad de inyectar entradas dinámicasen las descripciones de tareas proporcionando aparatos ortopédicos rizados ({}). Estos marcadores de posición podrían ser indicaciones del usuario, conceptos, definiciones o incluso resultados de agentes anteriores. Todos estos permiten que las LLM generen resultados más precisos.
query_task:
  description: |
    You are an expert SQL assistant. Your job is to translate user requests into SQL queries using ONLY the tables and columns listed below.
    SCHEMA:
    {db_schema}
    USER REQUEST:
    {user_input}
    IMPORTANT:
    - First, list which tables and columns from the schema you will use to answer the request.
    - Then, write the SQL query.
    - Only use the tables and columns from the schema above.
    - If the request cannot be satisfied with the schema, return a SQL comment (starting with --) explaining why.
    - Do NOT invent tables or columns.
    - Make sure the query matches the user's intent as closely as possible.
  expected_output: First, a list of tables and columns to use. Then, a syntactically correct SQL query using appropriate filters, joins, and groupings.

review_task:
  description: |
    Review the following SQL query for correctness, performance, and readability: {sql_query} and verify that the query fits the schema: {db_schema}
    Ensure that only tables and columns from the provided schema are used.
    IMPORTANT:
    - First, only review the SQL query provided for correctness, performance, or readability
    - Do NOT invent new tables or columns.
    - If the Query is already correct, return it unchanged.
    - If the Query is not correct and cannot be fixed, return a SQL comment (starting with --) explaining why.
  expected_output: An optimized or verified SQL query

compliance_task:
  description: >
    Review the following SQL query for compliance violations, including PII access, unsafe usage, or policy violations.
    List any issues found, or state "No issues found" if the query is compliant.
    SQL Query: {reviewed_sqlquery}
  expected_output: >
    A markdown-formatted compliance report listing any flagged issues, or stating that the query is compliant. Include a clear verdict at the top (e.g., "Compliant" or "Issues found")
Es una buena práctica tener las definiciones de agente y tareas en archivos YAML separados. Si alguna vez desea realizar cualquier actualización de las definiciones de agentes o tareas, solo necesita modificar los archivos YAML y no tocar la base de código en absoluto. En el crew_setup.py Archivo, todo se une. Leí y cargué las configuraciones de agente y tareas de sus respectivos archivos YAML. También creé las definiciones para todas las salidas esperadas utilizando modelos pydánticos para darles estructura y validar lo que el LLM debería devolver. Luego asigno a los agentes sus respectivas tareas y ensamble mi tripulación. Hay múltiples formas de estructurar a su tripulación según el caso de uso. Una sola tripulación de agentes puede realizar tareas en secuencia o paralelo. Alternativamente, puede crear múltiples equipos, cada uno responsable de una parte específica de su flujo de trabajo. Para mi caso de uso, elegí construir múltiples tripulaciones para tener más control sobre el flujo de ejecución al insertar un punto de control humano en bucle y un costo de control.
from crewai import Agent, Task, Crew
from pydantic import BaseModel, Field
from typing import List
import yaml

# Define file paths for YAML configurations
files = {
    'agents': 'config/agents.yaml',
    'tasks': 'config/tasks.yaml',
}

# Load configurations from YAML files
configs = {}
for config_type, file_path in files.items():
    with open(file_path, 'r') as file:
        configs[config_type] = yaml.safe_load(file)

# Assign loaded configurations to specific variables
agents_config = configs['agents']
tasks_config = configs['tasks']

class SQLQuery(BaseModel):
    sqlquery: str = Field(..., description="The raw sql query for the user input")

class ReviewedSQLQuery(BaseModel):
    reviewed_sqlquery: str = Field(..., description="The reviewed sql query for the raw sql query")

class ComplianceReport(BaseModel):
    report: str = Field(..., description="A markdown-formatted compliance report with a verdict and any flagged issues.")

# Creating Agents
query_generator_agent = Agent(
  config=agents_config['query_generator_agent']
)

query_reviewer_agent = Agent(
  config=agents_config['query_reviewer_agent']
)

compliance_checker_agent = Agent(
  config=agents_config['compliance_checker_agent']
)

# Creating Tasks
query_task = Task(
  config=tasks_config['query_task'],
  agent=query_generator_agent,
  output_pydantic=SQLQuery
)

review_task = Task(
  config=tasks_config['review_task'],
  agent=query_reviewer_agent,
  output_pydantic=ReviewedSQLQuery
)

compliance_task = Task(
  config=tasks_config['compliance_task'],
  agent=compliance_checker_agent,
  context=[review_task],
  output_pydantic=ComplianceReport
)

# Creating Crew objects for import
sql_generator_crew = Crew(
    agents=[query_generator_agent],
    tasks=[query_task],
    verbose=True
)

sql_reviewer_crew = Crew(
    agents=[query_reviewer_agent],
    tasks=[review_task],
    verbose=True
)

sql_compliance_crew = Crew(
    agents=[compliance_checker_agent],
    tasks=[compliance_task],
    verbose=True
)
Configuré una base de datos SQLite local con algunos datos de muestra para simular las interacciones de la base de datos de la vida real para mi POC. Obtengo el esquema de la base de datos que comprende todas las tablas y nombres de columnas presentes en el sistema. Más tarde alimenté este esquema como contexto para el LLM junto con la consulta de usuario original para ayudar a la LLM a generar una consulta SQL con las tablas y columnas originales del esquema proporcionado y no inventar algo por sí mismo. Una vez que el agente del generador crea una consulta SQL, el agente revisor es una revisión seguida de una verificación de cumplimiento del agente de cumplimiento. Solo después de estas revisiones, permito que la consulta revisada se ejecute en la base de datos para mostrar los resultados finales al usuario a través de la interfaz Streamlit. Al agregar verificaciones de validación y seguridad, me aseguro de que solo se ejecuten consultas de alta calidad en la base de datos que minimiza el uso innecesario del token y calcula los costos a largo plazo.
import sqlite3
import pandas as pd

DB_PATH = "data/sample_db.sqlite"

def setup_sample_db():
    conn = sqlite3.connect(DB_PATH)
    cursor = conn.cursor()

    # Drop tables if they exist (for repeatability in dev)
    cursor.execute("DROP TABLE IF EXISTS order_items;")
    cursor.execute("DROP TABLE IF EXISTS orders;")
    cursor.execute("DROP TABLE IF EXISTS products;")
    cursor.execute("DROP TABLE IF EXISTS customers;")
    cursor.execute("DROP TABLE IF EXISTS employees;")
    cursor.execute("DROP TABLE IF EXISTS departments;")

    # Create richer example tables
    cursor.execute("""
        CREATE TABLE products (
            product_id INTEGER PRIMARY KEY,
            product_name TEXT,
            category TEXT,
            price REAL
        );
    """)
    cursor.execute("""
        CREATE TABLE customers (
            customer_id INTEGER PRIMARY KEY,
            name TEXT,
            email TEXT,
            country TEXT,
            signup_date TEXT
        );
    """)
    cursor.execute("""
        CREATE TABLE orders (
            order_id INTEGER PRIMARY KEY,
            customer_id INTEGER,
            order_date TEXT,
            total_amount REAL,
            FOREIGN KEY(customer_id) REFERENCES customers(customer_id)
        );
    """)
    cursor.execute("""
        CREATE TABLE order_items (
            order_item_id INTEGER PRIMARY KEY,
            order_id INTEGER,
            product_id INTEGER,
            quantity INTEGER,
            price REAL,
            FOREIGN KEY(order_id) REFERENCES orders(order_id),
            FOREIGN KEY(product_id) REFERENCES products(product_id)
        );
    """)
    cursor.execute("""
        CREATE TABLE employees (
            employee_id INTEGER PRIMARY KEY,
            name TEXT,
            department_id INTEGER,
            hire_date TEXT
        );
    """)
    cursor.execute("""
        CREATE TABLE departments (
            department_id INTEGER PRIMARY KEY,
            department_name TEXT
        );
    """)

    # Populate with mock data
    cursor.executemany("INSERT INTO products VALUES (?, ?, ?, ?);", [
        (1, 'Widget A', 'Widgets', 25.0),
        (2, 'Widget B', 'Widgets', 30.0),
        (3, 'Gadget X', 'Gadgets', 45.0),
        (4, 'Gadget Y', 'Gadgets', 50.0),
        (5, 'Thingamajig', 'Tools', 15.0)
    ])
    cursor.executemany("INSERT INTO customers VALUES (?, ?, ?, ?, ?);", [
        (1, 'Alice', '[email protected]', 'USA', '2023-10-01'),
        (2, 'Bob', '[email protected]', 'Canada', '2023-11-15'),
        (3, 'Charlie', '[email protected]', 'USA', '2024-01-10'),
        (4, 'Diana', '[email protected]', 'UK', '2024-02-20')
    ])
    cursor.executemany("INSERT INTO orders VALUES (?, ?, ?, ?);", [
        (1, 1, '2024-04-03', 100.0),
        (2, 2, '2024-04-12', 150.0),
        (3, 1, '2024-04-15', 120.0),
        (4, 3, '2024-04-20', 180.0),
        (5, 4, '2024-04-28', 170.0)
    ])
    cursor.executemany("INSERT INTO order_items VALUES (?, ?, ?, ?, ?);", [
        (1, 1, 1, 2, 25.0),
        (2, 1, 2, 1, 30.0),
        (3, 2, 3, 2, 45.0),
        (4, 3, 4, 1, 50.0),
        (5, 4, 5, 3, 15.0),
        (6, 5, 1, 1, 25.0)
    ])
    cursor.executemany("INSERT INTO employees VALUES (?, ?, ?, ?);", [
        (1, 'Eve', 1, '2022-01-15'),
        (2, 'Frank', 2, '2021-07-23'),
        (3, 'Grace', 1, '2023-03-10')
    ])
    cursor.executemany("INSERT INTO departments VALUES (?, ?);", [
        (1, 'Sales'),
        (2, 'Engineering'),
        (3, 'HR')
    ])

    conn.commit()
    conn.close()

def run_query(query):
    try:
        conn = sqlite3.connect(DB_PATH)
        df = pd.read_sql_query(query, conn)
        conn.close()
        return df.head().to_string(index=False)
    except Exception as e:
        return f"Query failed: {e}"

def get_db_schema(db_path):
    conn = sqlite3.connect(db_path)
    cursor = conn.cursor()
    schema = ""
    cursor.execute("SELECT name FROM sqlite_master WHERE type='table';")
    tables = cursor.fetchall()
    for table_name, in tables:
        cursor.execute(f"SELECT sql FROM sqlite_master WHERE type='table' AND name='{table_name}';")
        create_stmt = cursor.fetchone()[0]
        schema += create_stmt + ";\n\n"
    conn.close()
    return schema

def get_structured_schema(db_path):
    conn = sqlite3.connect(db_path)
    cursor = conn.cursor()
    cursor.execute("SELECT name FROM sqlite_master WHERE type='table';")
    tables = cursor.fetchall()
    lines = ["Available tables and columns:"]
    for table_name, in tables:
        cursor.execute(f"PRAGMA table_info({table_name})")
        columns = [row[1] for row in cursor.fetchall()]
        lines.append(f"- {table_name}: {', '.join(columns)}")
    conn.close()
    return '\n'.join(lines)

if __name__ == "__main__":
    setup_sample_db()
    print("Sample database created.")
La carga de LLM por tokens: fragmentos de texto simples. Para cualquier LLM, existe un modelo de precios basado en el número de tokens de entrada y salida, generalmente facturados por millón de tokens. Para obtener una lista completa de precios de todos los modelos OpenAI, consulte su página de precios oficial aquí. Para gpt-4o-minilos tokens de entrada cuestan $ 0.15/m, mientras que los tokens de salida cuestan $ 0.60/m. Para procesar los costos totales de una solicitud de LLM, creé las funciones auxiliares a continuación en helper.py para calcular el costo total basado en el uso del token en una solicitud.
import re

def extract_token_counts(token_usage_str):
    prompt = completion = 0
    prompt_match = re.search(r'prompt_tokens=(\d+)', token_usage_str)
    completion_match = re.search(r'completion_tokens=(\d+)', token_usage_str)
    if prompt_match:
        prompt = int(prompt_match.group(1))
    if completion_match:
        completion = int(completion_match.group(1))
    return prompt, completion

def calculate_gpt4o_mini_cost(prompt_tokens, completion_tokens):
    input_cost = (prompt_tokens / 1000) * 0.00015
    output_cost = (completion_tokens / 1000) * 0.0006
    return input_cost + output_cost
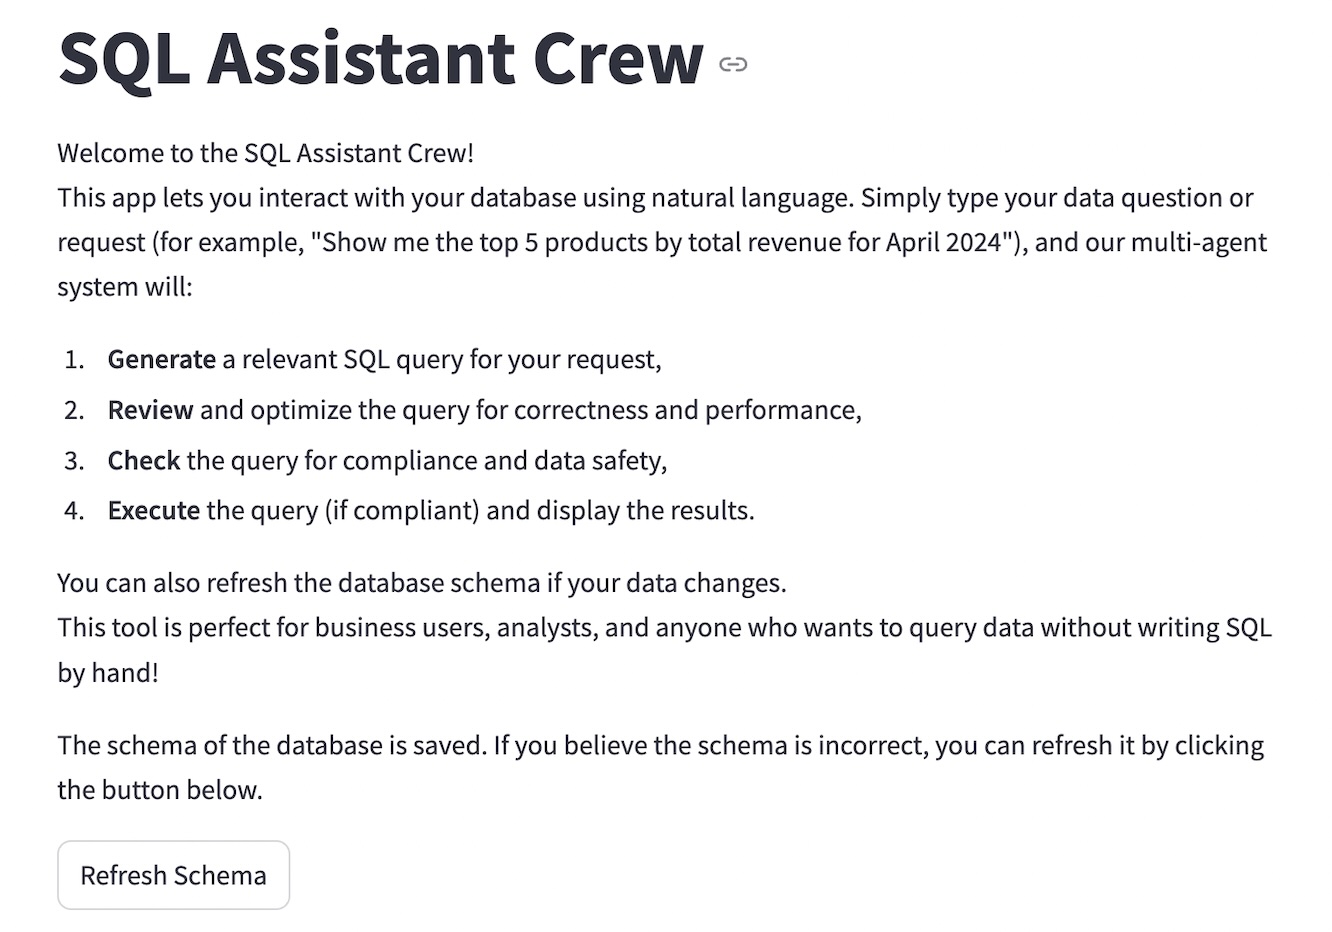
El app.py Archivo crea una poderosa aplicación de transmisión que permitirá al usuario solicitar la base de datos SQLite usando el lenguaje natural. Detrás de escena, mi conjunto de agentes de Crewai se pone en marcha. Después de que el primer agente genera una consulta SQL, se muestra en la aplicación para el usuario. El usuario tendrá tres opciones:
- Confirmar y revisar: si el usuario encuentra la consulta aceptable y desea continuar
- Intente nuevamente: si el usuario no está satisfecho con la consulta y desea que el agente genere una nueva consulta nuevamente
- Abortar: si el usuario quiere detener el proceso aquí
Junto con las opciones anteriores, el costo de LLM incurrido para esta solicitud se muestra en la pantalla. Una vez que el usuario hace clic en el “Confirm & Review” Botón, la consulta SQL pasará por los próximos dos niveles de revisión. El agente del revisor lo optimiza para la corrección y la eficiencia seguido del agente de cumplimiento que verifica el cumplimiento. Si la consulta cumple, se ejecutará en la base de datos SQLite. Los resultados finales y los costos acumulativos de LLM incurridos en todo el proceso se muestran en la interfaz de la aplicación. El usuario no solo tiene el control durante el proceso, sino que también es consciente de los costos.
import streamlit as st
from crew_setup import sql_generator_crew, sql_reviewer_crew, sql_compliance_crew
from utils.db_simulator import get_structured_schema, run_query
import sqlparse
from utils.helper import extract_token_counts, calculate_gpt4o_mini_cost

DB_PATH = "data/sample_db.sqlite"

# Cache the schema, but allow clearing it
@st.cache_data(show_spinner=False)
def load_schema():
    return get_structured_schema(DB_PATH)

st.title("SQL Assistant Crew")

st.markdown("""
Welcome to the SQL Assistant Crew!
This app lets you interact with your database using natural language. Simply type your data question or request (for example, "Show me the top 5 products by total revenue for April 2024"), and our multi-agent system will:
1. **Generate** a relevant SQL query for your request,
2. **Review** and optimize the query for correctness and performance,
3. **Check** the query for compliance and data safety,
4. **Execute** the query (if compliant) and display the results.

You can also refresh the database schema if your data changes.
This tool is perfect for business users, analysts, and anyone who wants to query data without writing SQL by hand!
""")

st.write("The schema of the database is saved. If you believe the schema is incorrect, you can refresh it by clicking the button below.")
# Add a refresh button
if st.button("Refresh Schema"):
    load_schema.clear()  # Clear the cache so next call reloads from DB
    st.success("Schema refreshed from database.")

# Always get the (possibly cached) schema
db_schema = load_schema()

with st.expander("Show database schema"):
    st.code(db_schema)

st.write("Enter your request in natural language and let the crew generate, review, and check compliance for the SQL query.")

if "generated_sql" not in st.session_state:
    st.session_state["generated_sql"] = None
if "awaiting_confirmation" not in st.session_state:
    st.session_state["awaiting_confirmation"] = False
if "reviewed_sql" not in st.session_state:
    st.session_state["reviewed_sql"] = None
if "compliance_report" not in st.session_state:
    st.session_state["compliance_report"] = None
if "query_result" not in st.session_state:
    st.session_state["query_result"] = None
if "regenerate_sql" not in st.session_state:
    st.session_state["regenerate_sql"] = False
if "llm_cost" not in st.session_state:
    st.session_state["llm_cost"] = 0.0

user_prompt = st.text_input("Enter your request (e.g., 'Show me the top 5 products by total revenue for April 2024'):")

# Automatically regenerate SQL if 'Try Again' was clicked
if st.session_state.get("regenerate_sql"):
    if user_prompt.strip():
        try:
            gen_output = sql_generator_crew.kickoff(inputs={"user_input": user_prompt, "db_schema": db_schema})
            raw_sql = gen_output.pydantic.sqlquery
            st.session_state["generated_sql"] = raw_sql
            st.session_state["awaiting_confirmation"] = True
            st.session_state["reviewed_sql"] = None
            st.session_state["compliance_report"] = None
            st.session_state["query_result"] = None
            # LLM cost tracking
            token_usage_str = str(gen_output.token_usage)
            prompt_tokens, completion_tokens = extract_token_counts(token_usage_str)
            cost = calculate_gpt4o_mini_cost(prompt_tokens, completion_tokens)
            st.session_state["llm_cost"] += cost
            st.info(f"Your LLM cost so far: ${st.session_state['llm_cost']:.6f}")
        except Exception as e:
            st.error(f"An error occurred: {e}")
    else:
        st.warning("Please enter a prompt.")
    st.session_state["regenerate_sql"] = False

# Step 1: Generate SQL
if st.button("Generate SQL"):
    if user_prompt.strip():
        try:
            gen_output = sql_generator_crew.kickoff(inputs={"user_input": user_prompt, "db_schema": db_schema})
            # st.write(gen_output)  # Optionally keep for debugging
            raw_sql = gen_output.pydantic.sqlquery
            st.session_state["generated_sql"] = raw_sql
            st.session_state["awaiting_confirmation"] = True
            st.session_state["reviewed_sql"] = None
            st.session_state["compliance_report"] = None
            st.session_state["query_result"] = None
            # LLM cost tracking
            token_usage_str = str(gen_output.token_usage)
            prompt_tokens, completion_tokens = extract_token_counts(token_usage_str)
            cost = calculate_gpt4o_mini_cost(prompt_tokens, completion_tokens)
            st.session_state["llm_cost"] += cost
        except Exception as e:
            st.error(f"An error occurred: {e}")
    else:
        st.warning("Please enter a prompt.")

# Only show prompt and generated SQL when awaiting confirmation
if st.session_state.get("awaiting_confirmation") and st.session_state.get("generated_sql"):
    st.subheader("Generated SQL")
    formatted_generated_sql = sqlparse.format(st.session_state["generated_sql"], reindent=True, keyword_case='upper')
    st.code(formatted_generated_sql, language="sql")
    st.info(f"Your LLM cost so far: ${st.session_state['llm_cost']:.6f}")
    col1, col2, col3 = st.columns(3)
    with col1:
        if st.button("Confirm and Review"):
            try:
                # Step 2: Review SQL
                review_output = sql_reviewer_crew.kickoff(inputs={"sql_query": st.session_state["generated_sql"],"db_schema": db_schema})
                reviewed_sql = review_output.pydantic.reviewed_sqlquery
                st.session_state["reviewed_sql"] = reviewed_sql
                # LLM cost tracking for reviewer
                token_usage_str = str(review_output.token_usage)
                prompt_tokens, completion_tokens = extract_token_counts(token_usage_str)
                cost = calculate_gpt4o_mini_cost(prompt_tokens, completion_tokens)
                st.session_state["llm_cost"] += cost
                # Step 3: Compliance Check
                compliance_output = sql_compliance_crew.kickoff(inputs={"reviewed_sqlquery": reviewed_sql})
                compliance_report = compliance_output.pydantic.report
                # LLM cost tracking for compliance
                token_usage_str = str(compliance_output.token_usage)
                prompt_tokens, completion_tokens = extract_token_counts(token_usage_str)
                cost = calculate_gpt4o_mini_cost(prompt_tokens, completion_tokens)
                st.session_state["llm_cost"] += cost
                # Remove duplicate header if present
                lines = compliance_report.splitlines()
                if lines and lines[0].strip().lower().startswith("# compliance report"):
                    compliance_report = "\n".join(lines[1:]).lstrip()
                st.session_state["compliance_report"] = compliance_report
                # Only execute if compliant
                if "compliant" in compliance_report.lower():
                    result = run_query(reviewed_sql)
                    st.session_state["query_result"] = result
                else:
                    st.session_state["query_result"] = None
                st.session_state["awaiting_confirmation"] = False
                st.info(f"Your LLM cost so far: ${st.session_state['llm_cost']:.6f}")
                st.rerun()
            except Exception as e:
                st.error(f"An error occurred: {e}")
    with col2:
        if st.button("Try Again"):
            st.session_state["generated_sql"] = None
            st.session_state["awaiting_confirmation"] = False
            st.session_state["reviewed_sql"] = None
            st.session_state["compliance_report"] = None
            st.session_state["query_result"] = None
            st.session_state["regenerate_sql"] = True
            st.rerun()
    with col3:
        if st.button("Abort"):
            st.session_state.clear()
            st.rerun()

# After review, only show reviewed SQL, compliance, and result
elif st.session_state.get("reviewed_sql"):
    st.subheader("Reviewed SQL")
    formatted_sql = sqlparse.format(st.session_state["reviewed_sql"], reindent=True, keyword_case='upper')
    st.code(formatted_sql, language="sql")
    st.subheader("Compliance Report")
    st.markdown(st.session_state["compliance_report"])
    if st.session_state.get("query_result"):
        st.subheader("Query Result")
        st.code(st.session_state["query_result"])
    # LLM cost display at the bottom
    st.info(f"Your LLM cost so far: ${st.session_state['llm_cost']:.6f}")
Aquí hay una demostración rápida de la aplicación en acción. Le pedí que mostrara los mejores productos en función de las ventas totales. El asistente generó una consulta SQL, y hice clic en “Confirm and Review”. La consulta ya estaba bien optimizada, por lo que el agente del revisor devolvió la misma consulta sin ninguna modificación. A continuación, el agente de verificación de cumplimiento revisó la consulta y confirmó que era seguro ejecutarse, sin operaciones de riesgo o exposición de datos confidenciales. Después de pasar las dos revisiones, la consulta se ejecutó contra la base de datos de muestra y se mostraron los resultados. Para todo este proceso, el costo de uso de LLM fue de solo $ 0.001349.
Aquí hay otro ejemplo en el que le pido a la aplicación que identifique qué productos tienen la mayor cantidad de devoluciones. Sin embargo, no hay información en el esquema sobre los retornos. Como resultado, el asistente no genera una consulta y establece la misma razón. Hasta esta etapa, el costo de LLM fue de $ 0.00853. Dado que no tiene sentido revisar o ejecutar una consulta inexistente, simplemente hice clic “Abort” para terminar el proceso con gracia.
Crewai es increíblemente poderoso para construir sistemas de múltiples agentes. Al combinarlo con Strewlit, uno puede crear fácilmente una IU interactiva simple en la parte superior para trabajar con el sistema. En este POC, exploré cómo agregar un elemento humano en bucle para mantener el control y la transparencia durante todo el flujo de trabajo. También rastreé cuántos tokens se consumieron en cada paso, ayudando al usuario a mantenerse costosa durante el proceso. Con la ayuda de un agente de cumplimiento, hice cumplir algunas medidas de seguridad básicas al bloquear las consultas arriesgadas o relacionadas con la exposición PII. Sintonicé la temperatura del modelo y refiné iterativamente las descripciones de las tareas para mejorar la calidad de la salida y reducir las alucinaciones. ¿Es perfecto? La respuesta es no. Todavía hay algunas veces cuando el sistema se alucina. Si implemento esto a escala, entonces el costo de LLM sería una preocupación mayor. En la vida real, las bases de datos son complejas y, como tal, su esquema también será enorme. Tendría que explorar trabajar con RAG (generación aumentada de recuperación) para alimentar solo fragmentos de esquema relevantes para la LLM, optimizar la memoria del agente y usar el almacenamiento en caché para evitar llamadas de API redundantes.
Pensamientos finales
Este fue un proyecto divertido que combina el poder de los LLM, la practicidad de la transmisión y la inteligencia modular de Crewai. Si está interesado en construir agentes inteligentes para la interacción de datos, pruébelo, ¡o bifurque el repositorio y construya sobre ello!
Antes de que te vayas …
Sígueme para que no te pierdas ninguna publicación nueva que escriba en el futuro; Encontrarás más de mis artículos en mi página de perfil. También puedes conectarte conmigo en LinkedIn o incógnita!