
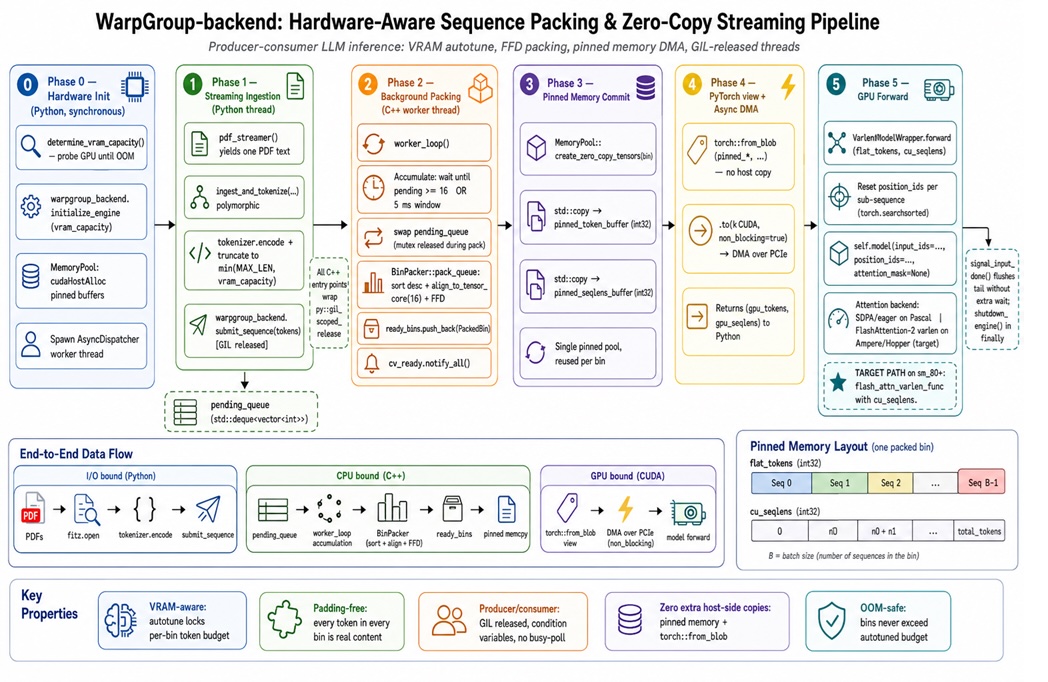
Este es un recorrido divertido pero real: que cubre el empaquetado de contenedores compatibles con VRAM, las transferencias de memoria fijada y cómo hacer que su LLM sea hasta 5,89 veces más rápido siendo un poco grosero con PyTorch.
Repositorio: github.com/AnubhabBanerjee/WarpGroup-backend
TL;DR: El procesamiento por lotes LLM estándar rellena secuencias cortas con ceros para que coincidan con la más larga. Luego, su GPU realiza diligentemente miles de millones de multiplicaciones en esos ceros, lo que es el equivalente computacional de pagarle a un chef para que cocine un plato vacío. WarpGroup-Backend reemplaza esto con un pequeño motor C++ que reúne secuencias de longitud variable como un campeón de Tetris muy ansioso. Resultado: rendimiento de 2,08× en una H100, 5,89× en una GTX 1080 y cero fallos de OOM. El artículo cuenta toda la historia con código, chistes y solo una cantidad moderada de gritos a NVIDIA.
(Confesión rápida antes de comenzar: llegué a esto con experiencia en ingeniería RAN 5G/6G. Resulta que el empaquetado del contenedor de GPU es sorprendentemente cercano a lo que el programador MAC de su teléfono ha estado haciendo durante dos décadas. Hay una sección completa sobre eso a continuación, sección 7, pero también es la razón por la que escribo esto en primer lugar).
1. Una confesión: la mayor parte del “trabajo” de tu GPU es falso
Si alguna vez ha agrupado texto de longitud variable a través de un transformador, esto es lo que realmente sucede, dramatizado:
Usted: "Por favor, resuma estos 8 documentos, GPU".
PyTorch: "Absolutamente. Primero déjame darles la misma forma a todos".
Tú: "Espera, son 80, 90, 110, 130, 95, 1850, 2000 y 60 fichas. No…"
PyTorch: "Rellené todo hasta 2000. Diviértete". 🫡
GPU: quema alegremente ~la mitad de su ancho de banda de cómputo y memoria en ceros rellenos
Su factura de AWS: *desarrolla sentido del humor*
Ésa es la broma. Ése es el sucio secreto de toda la industria. Datos de longitud variable + tensores rectangulares = a su GPU se le paga por hora para realizar un trabajo simulado.
WarpGroup-Backend es lo que sucede cuando decides que ya es suficiente y prefieres escribir 30% C++ que seguir pagando por esas tonterías.
2. ¿Por qué existe el relleno? (un curso intensivo de un minuto)
Omita esto si ya lo sabe. Para todos los demás:
A una GPU le encantan los rectángulos. Específicamente, le encantan las matrices donde cada fila tiene la misma longitud, porque eso le permite ejecutar miles de operaciones matemáticas idénticas en paralelo. Esto es lo que hace que una GPU sea una GPU en lugar de un pisapapeles caro.
Pero el texto no es un rectángulo. El texto es un desastre irregular. Un tweet son 12 tokens. Un contrato legal cuesta 4.000. Si quieres alimentar 8 de ellos a la vez a través de un transformador, tienes dos opciones:
Rellénalos todos hasta el más largo con una ficha. Las matemáticas se ejecutan en rectángulos, su código es simple y su GPU ahora pasa la mayor parte del tiempo multiplicando cero por otro cero. (El valor predeterminado de HuggingFace). Concatenarlos en una cinta larga 1-D y decirle al núcleo de atención "oye, no dejes que el token 12 hable con el token 4001, son de documentos diferentes". Esta es una atención de longitud variable, y para eso existe flash_attn_varlen_func de FlashAtttention-2.
La opción 2 es obviamente mejor, y un número creciente de pilas de inferencia de producción (vLLM, TensorRT-LLM, SGLang, FlashInfer, TGI internals) ya utilizan variantes de la misma.
Pero llamar a flash_attn_varlen_func es la parte fácil. La parte difícil (la parte que todos siguen reimplementando en formas ligeramente diferentes) es organizar la cinta: decidir qué documentos van en qué lote, en qué orden y hasta qué longitud total, mientras se mantiene la GPU saturada y la sobrecarga del lado del host invisible.
WarpGroup-Backend es la mitad organizadora molesta de esa ecuación, escrita en C++ para que pueda ser rápido.
3. La bombilla de “simplemente empaquételos” (y por qué es más difícil de lo que parece)
El argumento es simple: toma tu cola de secuencias de longitud variable y empácalas en contenedores como una abuela realmente intensa en un día de mudanza. Cada contenedor tiene capacidad para N tokens en total. Introduces tantas secuencias pequeñas como puedas junto a cada una de las grandes y luego envías todo el contenedor a la GPU como una cinta plana.
Este es un problema clásico de embalaje en contenedores y la solución del libro de texto es la disminución del primer ajuste (FFD):
Ordena secuencias de más larga a más corta. Para cada secuencia, recorra los contenedores abiertos. Déjalo en el primero que tenga espacio. Si ninguno tiene espacio, abra un contenedor nuevo.
Este es el mismo algoritmo que utiliza tu cerebro cuando haces la maleta: primero las rocas grandes y luego los guijarros llenan las grietas. No es óptimo, pero se sitúa dentro de ~22% del óptimo en el peor de los casos mientras es O(n log n) en lugar de tardar hasta la muerte por calor del universo.
Ahora aquí están las tres cosas que hacen que este no sea un script Python de 10 líneas:
Problema A: ¿Qué tamaño debe tener el contenedor?
Respuesta fácil: “tan grande como me permita la VRAM”. Respuesta incorrecta: ese no es un número que puedas buscar. La VRAM utilizable real depende de:
Tamaño del modelo (un 7B en bf16 consume ~14 GB antes de que hayas hecho algo). La memoria caché de activación/KV para esta longitud de secuencia específica (que escala de manera extraña). La fragmentación del asignador de PyTorch (un arte, no una ciencia). Si estornudó sobre el conductor.
No puedes calcular esto. Tienes que medirlo. La fase 0 de WarpGroup es literalmente "la entrevista de trabajo de la GPU": siga pidiéndole que trague secuencias cada vez más grandes hasta que haga OOM, luego retroceda un 10% por seguridad.
Problema B: Las GPU son quisquillosas con la comida (lo de los 16 tokens)
Los Tensor Cores de NVIDIA ejecutan sus instrucciones matriciales de acumulación y multiplicación (MMA) en formas de mosaicos fijos, por ejemplo, m16n8k16 en Hopper, y las dimensiones exactas varían según el tipo de datos y la arquitectura. La heurística práctica que surge de toda esa complejidad es deliciosamente simple: los núcleos de GPU (incluido FlashAttention-2) tienden a alcanzar la mejor eficiencia cuando las dimensiones relacionadas con la secuencia son múltiplos de 16 (a veces 8, según el tipo de d y el arco). Así que redondeamos la longitud de cada secuencia hacia arriba: 137 → 144, 200 → 208. No es que la GPU literalmente no pueda procesar los últimos 9 tokens, es que dejarlos colgar irregularmente le cuesta la fusión de la memoria, el mosaico de deformación y las formas GEMM que los núcleos posteriores realmente quieren ver.
Esta es la parte más tonta de todo el ejercicio y, sin embargo, ignorarla deja un rendimiento mensurable en el suelo.
Problema C: Python es demasiado lento para hacer esto en el bucle activo
Me encanta pitón. Tengo tatuado esto en mi alma. Pero Python tiene el GIL, el bloqueo de intérprete global, que es básicamente un portero que solo permite que un hilo entre al club nocturno de Python a la vez. Mientras Python está ocupado tokenizando archivos PDF, no puede también estar ocupado empacando contenedores. Mientras está empacando contenedores, no puede estar ocupado alimentando la GPU. El canal productor-consumidor colapsa en una lenta y triste línea de una sola fila.
Solución: empaquete en C++, en un subproceso en segundo plano, y libere el GIL en el límite de PyBind11 para que el lado de Python pueda seguir tokenizando mientras C++ sigue empaquetando. Ahora tienes un paralelismo real. El portero deja entrar a dos amigos a la vez. ¡Disfrutar!
4. El oleoducto de cinco fases (la parte realmente genial)
Aquí está la arquitectura de alto nivel, con chistes:
Fase 0: Mide empíricamente cuánta VRAM le queda al modelo. (Pitón)
Fase 1: tokenizar texto y números enteros a través del borde de C++. (Python → C++)
Fase 2: Atrape a los jóvenes en una cola segura para subprocesos sin drama de GIL. (Despachador asíncrono de C++)
Fase 3: Clasificarlos, alinearlos y hacer Tetris en contenedores 1-D. (empaquetador de contenedores C++)
Fase 4: contenedores manuales a la GPU a través de DMA asíncrono de memoria fija. (grupo de memoria C ++)
Fase 5: FlashAttention-2 disfruta de su almuerzo sin relleno. (PyTorch)
Repasemos cada uno con el código real. Seré breves los fragmentos; Los archivos completos están vinculados.
Fase 0: la entrevista de trabajo de GPU
Necesitamos saber exactamente cuántos tokens caben en la VRAM. Así que se lo pedimos a la GPU, educadamente pero con firmeza, hasta que llore.
Esto se encuentra en streaming_dataloader.py:
def determine_vram_capacity(model, device, start_tokens=0, step_size=5000, vocab_size=32000): """ Fase 0: este método detecta el dispositivo (GPU) en el que está alojado actualmente, carga el modelo en la VRAM, ve cuánto espacio queda y cuántos tokens pueden caber en el espacio restante de la VRAM. Luego incrementa el número de tokens según el tamaño del paso y repite el procesa hasta que se alcanza la capacidad máxima. Devuelve el número máximo de tokens que se pueden colocar en la VRAM mientras se carga el modelo. """ # esta parte carga el modelo en la VRAM y verifica si se puede cargar. si se puede, está bien. si no se puede hacer, # genera un error. intente: model.to(dispositivo) excepto Excepción: sys.exit("error al cargar el modelo en VRAM") print("nIniciando fase 0: modelo cargado exitosamente en VRAMnn") # esta parte verifica cuánto espacio queda, después de cargar el modelo, en términos de número de tokens # Probar la capacidad restante ejecutando avances sintéticos hasta CUDA OOM; luego reduzca la escala en 0,9 para lograr fragmentación. model.eval() # solo inferencia (abandono, estadísticas de norma por lotes fijadas), coincidente con la inferencia de embalaje real max_tokens = start_tokens # longitud de secuencia actual para probar; crece en step_size después de cada éxito safe_limit = 0 # últimos max_tokens que completaron un avance sin OOM (línea roja de hardware antes del paso fallido) con torch.no_grad(): # sin estado de autograduación = aproximadamente la mitad de la memoria de activación frente al modo de entrenamiento, mientras que Verdadero: intente: # ID de tokens sintéticos: la distribución no importa para la memoria; el tamaño impulsa activaciones/espacio de trabajo de atención dummy_tokens = torch.randint(0, vocab_size, (max_tokens,), dispositivo=dispositivo) # Secuencia empaquetada única [0, max_tokens): en el peor de los casos, una secuencia larga para max seqlen en el pase dummy_cu_seqlens = torch.tensor([0, max_tokens], dtype=torch.int32, dispositivo=dispositivo) # Avance real en el objetivo dispositivo: enfatiza los mismos núcleos/asignaciones que la producción (a diferencia de las pruebas de solo relleno) # La firma debe coincidir con su modelo (por ejemplo, FlashAttention varlen). Ajuste los kwargs si su delantero difiere. _ = model(dummy_tokens, cu_seqlens=dummy_cu_seqlens, max_seqlen=max_tokens) safe_limit = max_tokens # esta longitud se ajusta; trátelo como la línea roja más conocida hasta el momento max_tokens += step_size # intente un tramo más largo a continuación (búsqueda aproximada; reduce la cantidad de reenvíos que ejecuta) del _, dummy_tokens, dummy_cu_seqlens # elimine las referencias para que la memoria máxima de la próxima prueba no se infle con las sobras, excepto RuntimeError como e: if "out of Memory" in str(e).lower(): # Reenvío en max_tokens excedió la VRAM libre: detenerse; safe_limit es la última longitud exitosa torch.cuda.empty_cache() # devolver bloques almacenados en caché al grupo (no operativo en compilaciones solo de CPU en muchas versiones) gc.collect() # liberar cualquier objeto de Python que aún contenga vistas de tensor de dispositivo break # Los errores de forma/palabra clave significan que la llamada ficticia no coincide con la API del modelo, no "fuera de VRAM" rise if safe_limit == 0: # Si el primer intento en OOM start_tokens, no hay una línea roja exitosa; reducir start_tokens (aquí no se reduce a la mitad automáticamente) sys.exit("Error: el modelo no puede procesar el recuento de tokens iniciales sin OOM. Disminuir start_tokens.") # 0.9x: margen para la fragmentación del asignador y pequeños picos en lotes reales frente a esta sonda idealizada Optimal_Capacity = int(safe_limit * 0.9) print(f"nCapacidad óptima del contenedor bloqueada en: {optimal_capacity} tokens.n") devuelve capacidad_optima
Eso es todo. Ese es todo el "autoajuste". Lanza secuencias falsas cada vez más grandes al modelo hasta que CUDA voltee una mesa, escribe la última que sobrevivió, multiplica por 0,9 por seguridad. Sin documento técnico del proveedor. Ninguna fórmula teórica. Simplemente intimidando a la GPU hasta que te diga su límite real.
En un H100 con Qwen2.5–7B-Instruct, esto equivale a alrededor de 76.500 tokens por contenedor. Intente encajar eso en una mentalidad de grupo de 8.
Fase 1: Tokenizar y aún
Python lee documentos (PDF, JSONL, lo que sea), los tokeniza con el tokenizador HuggingFace y envía cada uno como una lista de números enteros a través del límite de PyBind11. Esto está en Reader_and_tokennizer.py:
para texto en _iter_text_units(data_source, json_key): tokens = tokenizer.encode(text, add_special_tokens=True) if len(tokens) > Effective_cap: si max_length no es Ninguno y Effective_cap == max_length: tokens = tokens[: Effective_cap] else: print( f"Advertencia: La longitud de la secuencia ({len(tokens)}) excede la capacidad de VRAM " f"({efectivo_cap}). Truncando secuencia…", file=sys.stderr, ) tokens = tokens[: Effective_cap] si cxx_backend no es Ninguno: cxx_backend.submit_sequence(tokens)
Observe lo aburrido que es esto. Bien. Python aburrido = C++ rápido. El lado de Python realiza E/S y tokenización y eso es todo. Sin lógica de procesamiento por lotes, sin lógica de empaquetado, sin coreografía de GPU. Sólo una única responsabilidad, cariño.
Fase 2: el guante del receptor C++
En el lado de C++, async_dispatcher.cpp captura cada llamada de submit_sequence y la coloca en un std::deque seguro para subprocesos detrás de un mutex:
void AsyncDispatcher::submit_sequence(std::tokens vectoriales) { { std::lock_guard lk(queue_mutex); if (!engine_started.load()) { // No operación silenciosa antes de inicialize_engine() — evita fallas en los cuadernos // que se envían accidentalmente antes de tiempo; Descomente el lanzamiento si prefiere fallar rápido. devolver; } pendiente_queue.push_back(std::move(tokens)); } cv_data.notify_one(); }
Mientras tanto, un subproceso de trabajo en segundo plano se encuentra en un bucle de espera (). Cuando aparecen tokens, se activa, toma un lote y ejecuta el empaquetador. Lo inteligente: no se activa instantáneamente, porque eso significaría empacar una secuencia a la vez, lo que anula el objetivo del empaquetamiento en contenedores.
En cambio, espera a que se acumulen 16 secuencias o que pasen 5 ms:
// Ventana de acumulación: si hay pocas secuencias pendientes y el // productor todavía está alimentando (no input_done, no apagándose), // espere un breve momento para ver más antes de intercambiar. Esto permite que // el empaquetador FFD vea un lote real en lugar de una secuencia a la vez. // Se despierta temprano: alcanzando kPackMinBatch, apagado o input_done. if (pending_queue.size() < kPackMinBatch && !stop_flag.load() && !input_done_flag.load()) { cv_data.wait_for(lk, kPackWaitWindow, [&] { return pendiente_queue.size() >= kPackMinBatch || stop_flag.load() || input_done_flag.load(); }); }
Esta es la diferencia entre “empaquetado en contenedor” y “contenedor… eh, un contenedor de secuencia única es técnicamente un contenedor”. 5 ms es más corto que un único paso hacia adelante en este hardware, por lo que el costo de latencia es invisible. La ganancia de densidad es de hasta 8×.
La capa PyBind11 en Bindings.cpp envuelve todo con py::gil_scoped_release para que cualquier trabajo de C++ que bloquee o suspenda no contenga el GIL de Python:
m.def("get_next_bin",[]() -> std::tuple { Papelera PackedBin; { py::gil_scoped_release lanzamiento; bin = motor().get_next_ready_bin(); } // Volví a adquirir el GIL aquí: crear objetos torch::Tensor y // devolverlos a Python toca CPython refcounts. if (bin.flat_tokens.empty()) { auto opts = torch::TensorOptions().dtype(torch::kInt32).device(torch::kCUDA); return std::make_tuple(torch::empty({0}, opciones), torch::empty({0}, opciones)); } return motor().get_memory_pool().create_zero_copy_tensors(bin); }, "Bloquear hasta que exista un contenedor empaquetado; devuelve (token_ids, cu_seqlens) en CUDA.");
Si alguna vez ha depurado un punto muerto de Python-C++, los comentarios en este archivo le brindarán recuerdos. Definitivamente vale la pena leerlo, ¡especialmente cuando bebiste demasiado café y tienes problemas para conciliar el sueño!
Fase 3: Tetris con reglas (FFD + alineación de 16 fichas)
Este es el corazón de todo el proyecto y es maravillosamente breve. De bin_packer.cpp:
int BinPacker::align_to_tensor_core(int raw_length) { /* * NVIDIA Tensor Cores ejecuta matemáticas matriciales en mosaicos de 16×16 o 32×32. * Si la longitud de una secuencia no es perfectamente divisible por 16, el Tensor Core * no puede procesar el borde irregular, lo que provoca que la GPU se detenga. * Calculamos el resto y redondeamos al múltiplo de 16 más cercano. */ int resto = raw_length % 16; if (resto == 0) { return raw_length; } devuelve raw_length + (16 – resto); }
Tres líneas. Esa es la “alineación de Tensor Core de 16 tokens” que las publicaciones del blog de NVIDIA hacen que parezca una tesis doctoral. Es resumen (n, 16). Eso es todo. Esa es la cuestión.
El embalaje en sí:
std::vector BinPacker::pack_queue(std::deque>& pendiente_queue) { std::vector ready_bins; if (pending_queue.empty()) { return ready_bins; } // Paso 1: Drene la cola en un vector estándar para que podamos ordenarla. // Usamos std::move para transferir la propiedad de la memoria instantáneamente sin copiar datos. std::vector> secuencias; while (!pending_queue.empty()) { secuencias.push_back(std::move(pending_queue.front())); pendiente_queue.pop_front(); } // Paso 2: Ordenar decreciente (primero las secuencias más largas) // Empacar rocas grandes primero y luego llenar los espacios con guijarros produce la mayor densidad. std::sort(secuencias.begin(), secuencias.end(),[](const std::vector& a, const std::vector& b) { return a.size() > b.size(); }); // Paso 3: Embalaje de primer ajuste para (auto& seq: secuencias) { int raw_len = seq.size(); int alineado_len = align_to_tensor_core(raw_len); // Seguridad de la caja perimetral: si la alineación lo empuja apenas por encima del límite de VRAM, sujételo. if (aligned_len > max_vram_capacity) { alineado_len = max_vram_capacity; seq.resize(aligned_len, 0); } else if (aligned_len > raw_len) { // Inyecta físicamente tokens de pad '0' invisibles para alcanzar los 16 límites seq.insert(seq.end(), alineado_len – raw_len, 0); } bool colocado = falso; // Intente ajustar la secuencia en un contenedor abierto existente (First-Fit) for (auto& bin: ready_bins) { if (bin.current_token_count + alineado_len <= max_vram_capacity) { // ¡Encaja! Registre el límite inicial en cu_seqlens bin.cu_seqlens.push_back(bin.current_token_count); // Agrega los tokens a la matriz plana 1D bin.flat_tokens.insert(bin.flat_tokens.end(), seq.begin(), seq.end()); bin.current_token_count += alineado_len; colocado = verdadero; romper; } } // Si no cabe en NINGÚN contenedor existente, debemos asignar un contenedor nuevo if (!placed) { PackedBin new_bin; new_bin.current_token_count = alineado_len; // La primera secuencia en un contenedor nuevo siempre comienza en el índice 0 new_bin.cu_seqlens = {0}; // Mueve los tokens a la matriz plana new_bin.flat_tokens = std::move(seq); ready_bins.push_back(std::move(new_bin)); } }
Léelo dos veces. Interiorízalo. Este es el algoritmo. Todo lo demás en este repositorio (los subprocesos de C++, la memoria fijada, la gimnasia GIL) existe para alimentar este bucle de 30 líneas y entregar su salida a la GPU en un único DMA asíncrono sin copias adicionales del lado del host.
cu_seqlens es el anillo decodificador mágico. Es una pequeña matriz entera de compensaciones acumulativas. Si su contenedor contiene tres documentos de longitud 200, 144 y 64 (ya alineados), entonces cu_seqlens = [0, 200, 344, 408]. FlashAttention-2 lee esta matriz y dice: "Ah, ya veo, tres subsecuencias" y ejecuta una atención exacta y sin relleno sobre ellas. No se materializó ningún tensor de máscara gigante y densa en la memoria. Sin contaminación entre documentos. No se desperdician FLOP en regiones acolchadas.
Fase 4: el truco de magia de “copia cero” (un DMA, sin copias adicionales)
Bien, entonces tenemos un contenedor empaquetado en un std::vector en la CPU. Lo necesitamos en la GPU. El enfoque ingenuo: memcpy en un tensor de PyTorch, luego .to('cuda'). Esto funciona, pero tiene dos costos pagados en cada contenedor: (1) una copia adicional del lado del host (su vector → algún tensor intermedio → GPU), y (2) en x86_64 el sistema operativo puede extraer sus páginas de memoria en cualquier momento, lo que obliga a CUDA a realizar transferencias a través de un búfer de rebote en lugar de permitir que el motor DMA toque sus bytes directamente.
El truco consiste en fijar la memoria del host (bloquear la página), asignada mediante cudaHostAlloc. La memoria fijada es RAM que al sistema operativo se le ha prohibido intercambiar o mover. Debido a que la dirección es estable, el motor DMA de la GPU puede extraer los bytes a través del bus PCIe en una única transferencia asíncrona, sin necesidad de que la CPU realice primero una copia intermedia. La transferencia en sí todavía ocurre (esto no es literalmente una “copia cero” en el sentido estricto de UVA/UM, el DMA host→dispositivo es real), pero es una copia en lugar de dos, se ejecuta de forma asíncrona con la CPU y aterriza directamente en la memoria del dispositivo. Todos en el mundo de la inferencia llaman a esto "copia cero" de todos modos, y la función en el repositorio recibe el nombre correspondiente. Pedantes, dirijan sus quejas a la sección de comentarios; Nos ocuparemos de ellos después del almuerzo.
Desde Memory_pool.cpp:
// ——————————————————— // 1. ASIGNAR MEMORIA FIJADA (Sucede una vez durante la Fase 0) // ——————————————————— MemoryPool::MemoryPool(size_t max_vram_tokens): max_capacity(max_vram_tokens) { // Asigna el búfer de token. cudaHostAlloc bloquea esta memoria en la RAM física. cudaError_t err1 = cudaHostAlloc((void**)&pinned_token_buffer, max_capacity * sizeof(int), cudaHostAllocDefault); // Asigna el búfer de límites de longitud de secuencia. // +1 porque cu_seqlens siempre tiene un elemento más que el número de secuencias. cudaError_t err2 = cudaHostAlloc((void**)&pinned_seqlens_buffer, (max_capacity + 1) * sizeof(int), cudaHostAllocDefault); if (err1 != cudaSuccess || err2 != cudaSuccess) { throw std::runtime_error("[MemoryPool] Fatal: No se pudo asignar la memoria fijada. " "El sistema host puede no tener RAM."); } std::cout << "[MemoryPool] Bloqueado exitosamente " << (max_capacity * sizeof(int)) / 1024 << " KB de memoria anclada lista para DMA." << std::endl; }
Luego, cuando queremos enviar un contenedor a la GPU, copiamos nuestro contenedor empaquetado en el búfer anclado (un std::copy rápido) y envolvemos ese búfer anclado como un tensor de PyTorch sin asignar nuevo almacenamiento de tensor:
std::tuple MemoryPool::create_zero_copy_tensors(const PackedBin& bin) { // Paso 1: Copia rápida de C++ desde nuestro algoritmo de empaquetado al bloque de memoria anclado. // std::copy está altamente optimizado por el compilador a nivel de ensamblado. std::copy(bin.flat_tokens.begin(), bin.flat_tokens.end(), pinned_token_buffer); std::copy(bin.cu_seqlens.begin(), bin.cu_seqlens.end(), pinned_seqlens_buffer); // Paso 2: Shell de metadatos de PyTorch // torch::from_blob NO asigna nueva memoria. Simplemente envuelve nuestro puntero // pinned_token_buffer existente en un objeto PyTorch Tensor para que Python pueda interactuar con él. auto token_opts = antorcha::TensorOptions().dtype(torch::kInt32).device(torch::kCPU); torch::Tensor token_tensor = torch::from_blob( pinned_token_buffer, // El puntero fijado sin formato {static_cast(bin.current_token_count)}, // El tamaño exacto de este lote específico token_opts ); antorcha::Tensor seqlens_tensor = antorcha::from_blob( pinned_seqlens_buffer, {static_cast(bin.cu_seqlens.size())}, token_opts); // Paso 3: Activar la transferencia PCIe DMA. // Debido a que la memoria subyacente está fijada, la llamada .to(cuda) desencadena una // transferencia DMA asincrónica. La CPU pasa inmediatamente a empaquetar el siguiente contenedor // mientras que el hardware de la GPU extrae silenciosamente los datos a través del bus. antorcha::Tensor gpu_tokens = token_tensor.to(torch::kCUDA, /*non_blocking=*/true); antorcha::Tensor gpu_seqlens = seqlens_tensor.to(torch::kCUDA, /*non_blocking=*/true); devolver std::make_tuple(gpu_tokens, gpu_seqlens); }
torch::from_blob es una de las funciones malvadas más bellas de PyTorch. Dice: "No voy a asignar ningún almacenamiento tensorial nuevo. Voy a envolver este puntero sin formato como una vista tensorial y usted es responsable de mantener viva la memoria subyacente". Es el equivalente en C++ de tomar una nota adhesiva que dice "TENSOR" y pegarla sobre una pila de memoria existente. PyTorch lo cree. Todos se van felices a casa. (Sí, todavía se asigna una pequeña estructura de metadatos tensoriales. El almacenamiento no, que es la parte que le cuesta por contenedor. Pedantes de HPC, vuelvan a enfundar las horcas; ya casi hemos terminado la sección).
Non_blocking=True en .to(torch::kCUDA) luego inicia una transferencia PCIe DMA asincrónica y regresa inmediatamente. La CPU sale a empacar el siguiente contenedor mientras la GPU sorbe silenciosamente el contenedor anterior a lo largo del bus. El empaquetador y la GPU ahora funcionan en paralelo. Esta es la parte en la que empiezas a escuchar el ventilador de la GPU girar como si finalmente tuviera algo real que hacer.
Fase 5: FlashAttention-2 disfruta de su almuerzo sin relleno
El lado de Python, en main_working_file.py, ahora es graciosamente corto:
# Fase 0, Paso C: Inicializar el motor en segundo plano de C++ # Bloquea los límites de hardware y genera el hilo de trabajo en segundo plano warpgroup_backend.initialize_engine(vram_capacity) # Fase 1: Ingerir y tokenizar # Transmite tokens a la cola en segundo plano de C++ ingest_and_tokenize( file_path, tokenizer, vram_capacity, cxx_backend=warpgroup_backend ) # Fase 4 y 5: Inferencia Ejecución print("nIniciando fase de inferencia…") intente: # Fase 4: Orquestación y gestión de colas mientras no sea warpgroup_backend.is_queue_empty(): # Recuperar los tensores de contenedor optimizados por hardware # Esto activa la transferencia DMA de copia cero desde la memoria fija bin_tensors = warpgroup_backend.get_next_bin() # Fase 5: Ejecución de GPU (FlashAttention-2) con torch.no_grad(): # El contenedor traduce el contenedor 1D a 2D para el modelo HF salida = model(bin_tensors[0], cu_seqlens=bin_tensores[1]) print(f"FlashAttention-2 ejecutado para el tamaño del contenedor: {bin_tensors[0].forma[0]} fichas.")
Pequeño pero importante descargo de responsabilidad para el lector cuidadoso: un stock HuggingFace forward() no acepta cu_seqlens directamente. El modelo aquí es un VarlenModelWrapper delgado de streaming_dataloader.py que descomprime el flujo empaquetado 1-D en la forma (1, N) que HF espera y, fundamentalmente, reconstruye position_ids para que cada subsecuencia comience en la posición 0 (de lo contrario, el primer token del documento B ve la posición len(A) y las incrustaciones rotativas van hacia los lados). Para el enmascaramiento de documentos cruzados con corrección bit a bit en un contenedor de secuencias múltiples, también desea que el modelo HF subyacente se cargue con attn_implementation='flash_attention_2' y las capas de atención conectadas para llamar a flash_attn_varlen_func con el mismo cu_seqlens: la propia cadena de documentación del contenedor explica exactamente por qué y cómo. FA-2 es lo que realmente realiza la atención de longitud variable; La contribución de WarpGroup es alimentarlo densamente y a tiempo.
Algunas líneas de lógica empresarial. Eso es todo lo que queda. Todo lo demás sucede en el motor C++ mientras Python bebe café.
5. Los recibos (es decir, los números)
Es hora de humillar a la línea de base. Todos los números del README del repositorio.
Nota rápida sobre la metodología de evaluación comparativa, antes de que alguien se acerque a las rocas: cada comparación a continuación ejecuta el mismo punto de control del modelo, el mismo tokenizador, el mismo corpus de entrada y el mismo dtype (bf16) en la misma GPU con los relojes predeterminados. La ruta de “línea de base (HuggingFace)” es la canalización por lotes acolchada de stock de HF con attn_implementation="flash_attention_2"; es decir, ya está usando FA-2, no un bucle ingenuo deliberadamente discapacitado. La ruta optimizada utiliza el mismo kernel FA-2. El único eje de diferencia es cómo se agrupan las secuencias (empaquetado FFD en un contenedor 1-D compatible con VRAM versus relleno en un tensor rectangular de tamaño de lote × secuencia_más larga). El tipo de carga de trabajo es una evaluación de documentos de estilo precompletado, no una decodificación de transmisión autorregresiva; esa distinción es importante para la siguiente subsección. Los scripts de reproducción están en example_runs/ si desea discutir con los números.
Prueba de estrés: H100, Qwen2.5–7B, 400 archivos PDF de longitud mixta
El conjunto de datos intercala deliberadamente documentos pequeños (de 45 a 130 palabras) con documentos masivos (de 1820 a 2000 palabras), básicamente el peor de los casos para el procesamiento por lotes acolchado.
Traducción: la línea de base gastó la mitad de sus tokens rellenando ceros. Medio. Imagínate pedir una pizza y 4 de las 8 porciones son solo cartón.
Escalado de producción: mismo hardware, documentos uniformes de 50 a 1900 palabras
Incluso en un conjunto de datos "agradable" y distribuido uniformemente (es decir, el único tipo que las publicaciones de blog de referencia utilizan), WarpGroup aún gana en un 70%, porque existe una sobrecarga de relleno incluso cuando su distribución se comporta bien.
Hardware básico: GTX 1080 (8 GB), SmolLM2–360M
Éste es mi favorito. ¿Por qué? Porque cuanto más pequeño sea el hardware, más duele el acolchado. Una GTX 1080 que va 5,89 veces más rápido significa que las pequeñas empresas emergentes, los aficionados, los laboratorios universitarios y cualquier persona que utilice una sola tarjeta de consumo acaban de obtener una actualización de hardware gratuita. El mismo 1080 que era “apenas suficiente” ahora es “bastante bueno”.
Ronda de bonificación: no chocar
Elimine el límite MAX_LEN por completo y la línea base hace esto:
torch.OutOfMemoryError: se intentó asignar 30,00 GiB
Porque intentó hacer un rectángulo (tamaño_lote × secuencia_más larga) y la secuencia más larga era, eh, grande.
WarpGroup: se completa con éxito, VRAM máxima de 3,60 GB. Porque el autoajuste de Fase 0 bloquea un estricto presupuesto de entrada alineado con el hardware y el empaquetador se niega a admitir cualquier contenedor que lo exceda. La fragmentación del asignador y los espacios de trabajo reutilizables del kernel aún pueden sorprenderte en teoría; en la práctica, los OOM patológicos impulsados por el relleno que activan los lotes de forma fija simplemente dejan de ocurrir. No hay mensajes de Slack a las 3 a.m. de tu primo de guardia. Solo secuencias, empaquetadas, ejecutadas, listas.
"Está bien, pero ¿en qué se diferencia esto de vLLM/atención paginada/procesamiento por lotes continuo?"
Pregunta razonable, y vale la pena responderla directamente porque el mundo de inferencia-infra tiene muchas primitivas superpuestas y un lector de HPC preguntará esto en el primer comentario.
vLLM/procesamiento por lotes continuo está optimizado para el servicio en tiempo de decodificación: muchas solicitudes simultáneas en diferentes pasos de generación, programa el siguiente token entre ellas y mantiene la GPU saturada bajo carga de transmisión. Su primitivo principal es atención paginada: un administrador de memoria caché KV que pagina bloques físicamente no contiguos como una tabla de páginas del sistema operativo. TensorRT-LLM, SGLang, FlashInfer admiten variantes de atención varlen. Su lógica de empaquetado generalmente reside dentro de un tiempo de ejecución de servicio ajustado para flujos de solicitudes en vivo sensibles a la latencia. WarpGroup-Backend se dirige a la otra mitad del espectro de cargas de trabajo: trabajos sin conexión/de alto rendimiento, de estilo precargado. Evaluación de documentos, indexación RAG, extracción de incrustaciones por lotes, resumen de registros OAM por lotes, clasificación masiva, arneses de evaluación. La unidad de trabajo es un corpus finito de secuencias de longitud variable, no una fuente de solicitudes de decodificación. La atención se centra en la densidad de empaquetado del lado del host, el envío asíncrono sin GIL y una transferencia estricta de memoria fija, no en la paginación de caché KV.
Piénselo de esta manera: vLLM es un gerente de restaurante que sienta a los comensales que llegan en las mesas en tiempo real. WarpGroup es una empresa de catering que empaqueta los box lunch del día en camionetas de reparto antes de que los camiones abandonen el depósito. Problemas diferentes, primitivos complementarios, frecuentemente implementables conjuntamente en el mismo edificio.
6. Entonces… ¿cómo lo pruebo realmente?
El repositorio se envía con un reproductor de una sola vez:
# 1. Clonar git clone https://github.com/AnubhabBanerjee/WarpGroup-backend.git cd WarpGroup-backend # 2. Python env + deps python3.12 -m venv .venv source .venv/bin/activate pip install –upgrade pip pip install -r requisitos.txt pip install -e. # 3. Compile el backend de C++ mkdir build && cd build cmake .. make -j4 cp warpgroup_backend*.so .. cd .. # 4. Prueba de humo python3 main_working_file.py
Si desea realizar el punto de referencia adecuado en paralelo (línea de base HF frente a WarpGroup), la carpeta example_runs/ tiene un ejecutor de extremo a extremo con script que genera un corpus PDF sintético, ejecuta ambas pilas y escribe resultados JSON + gráficos de barras.
Necesitarás:
Linux, kit de herramientas CUDA, una GPU NVIDIA (consumidor o centro de datos, ambos funcionan). Una compilación de PyTorch con soporte CUDA (no envíe la que solo tiene CPU y luego se sorprenda cuando nada se acelere). Un LLM que admita flash_attention_2 (Qwen2.5, Llama-3, Mistral, SmolLM2, etc.).
7. Giro de la trama: esto es solo programación MAC disfrazado de CUDA
Probablemente debería confesar en este punto: no soy una “persona de GPU” por formación. Llegué a través de las telecomunicaciones (5G NR, con un pie firmemente en la investigación de 6G) y comencé a analizar la infraestructura de inferencia LLM porque cada problema en esta base de código me parecía inquietantemente familiar.
Mire esto uno al lado del otro y dígame con seriedad que estos son problemas diferentes:
Programador MAC 5G NR (en el gNB) WarpGroup-Backend (en la GPU) SDU MAC de tamaño variable de cada UE/canal lógico Secuencias de tokens de tamaño variable de cada documento Empaque en un bloque de transporte cada TTI Empaque en un contenedor de VRAM en cada ciclo de envío Tamaño de TB limitado por PRB × bits MCS disponibles Tamaño del contenedor limitado por el presupuesto empírico de VRAM Debe alinearse con la segmentación de bloques de código LDPC (TS 38.212) §5.2.2) Debe alinearse con mosaicos de Tensor Core de 16 tokens. La priorización de canales lógicos (LCP) elige lo que entra. El primer ajuste elige lo que entra. Fecha límite estricta: una ranura (0,5 ms en numerología μ=1) Fecha límite flexible: mantenga la GPU alimentada. Saltarse un TB → cráteres de rendimiento de PDSCH. Saltarse un contenedor → la GPU permanece inactiva, cráteres de rendimiento.
Si alguna vez ha leído 3GPP TS 38.321, estará mirando el mismo algoritmo. El programador MAC en la estación base ha estado empaquetando SDU de tamaño variable en bloques de transporte (dimensionados para adaptarse a una red PRB fija, alineados con los umbrales de bloques de código LDPC, priorizados a través de canales lógicos) desde LTE-Advanced. Las únicas cosas que cambian en WarpGroup son las unidades (tokens, no bits), el presupuesto (VRAM, no PRB) y la alineación cuántica (mosaicos de 16 tokens, no tamaños de bloques de código LDPC).
Incluso la Fase 0 tiene un doble en las telecomunicaciones. El repositorio prueba la GPU con secuencias sintéticas hasta que alcanza el OOM y luego retrocede un 10%. La RAN hace el equivalente en cada TTI: observa los informes CQI/SINR, selecciona un MCS, observa el BLER y luego retrocede. Ambos dicen lo mismo: la especificación le da un máximo teórico, pero el único número honesto es el que se mide en condiciones reales.
Un breve comentario sobre dos públicos muy diferentes
A mis primeros amigos de HPC y CUDA que leen esto: lo sé. Ha estado haciendo exactamente esto desde que llegaron los primeros artículos de GPGPU en 2003. El empaquetado en contenedores es una clase de algoritmos para estudiantes de primer año, cudaHostAlloc está en todos los tutoriales de CUDA y la memoria fijada es, para usted, básicamente un rasgo de personalidad. Nada de esto es noticia. Por favor, bajen las horcas.
Pero es una noticia para los ingenieros de telecomunicaciones y esa es la mitad de la razón por la que existe este artículo. Durante veinte años nuestro mundo estuvo formado por FPGA, ASIC y PRB. Optimizamos el espectro, no el silicio. Pídale al ingeniero de RAN promedio que le explique la alineación de los mosaicos de Tensor Core y recibirá una mirada educada. Luego, los elementos de estudio AI-RAN, NWDAF, NVIDIA Aerial, SoftBank AITRAS, AI-RAN Alliance y 3GPP Rel-20 sucedieron aproximadamente en los mismos dieciocho meses, y la próxima década de carreras en telecomunicaciones ahora exige ser bilingüe entre el mundo del espectro y el mundo de la GPU, y muchos de nosotros comenzamos desde aproximadamente cero en la mitad de la GPU. Si el término “memoria fijada” sonaba como un idioma extranjero hasta hace diez minutos: bienvenido, no estás detrás, has llegado temprano. La intuición se traduce claramente de todos modos. Ya sabe cómo empaquetar cargas útiles de tamaño variable en una ventana de presupuesto fijo bajo restricciones de alineación de hardware. Solías llamarlo programación MAC. Mismo animal, nuevo zoológico.
Considere este artículo como un medio paso en ese camino.
Por qué a un ingeniero de telecomunicaciones en activo debería importarle ahora mismo
Esta no es una analogía abstracta. Cuatro razones concretas por las que aterriza en 2026:
6G es oficialmente nativo de la IA. Los elementos de estudio de ITU-R IMT-2030, 3GPP Rel-20, la Alianza AI-RAN, los grupos de trabajo AI/ML de O-RAN: todos asumen que los LLM y los grandes modelos ML viven dentro de la red, no atornillados al OSS/BSS más adelante. Gestión de haces, RIC xApps/rApps, análisis NWDAF, configuración basada en intenciones, OAM agente: cada uno de ellos es una carga de trabajo candidata para una pila de inferencia que hace exactamente lo que hace WarpGroup. La voz ya es un flujo simbólico. Los códecs de audio neuronales (Encodec, SoundStream, Mimi) tokenizan la voz entre 25 y 75 Hz. Los Voice-LLM como Moshi, AudioPaLM y Spirit-LM consumen esos tokens directamente. Un centro de llamadas que maneja 10.000 llamadas simultáneas es, computacionalmente, una rebaño atronador de flujos de tokens de longitud variable que llegan de forma asincrónica desde fuentes heterogéneas: exactamente la carga de trabajo que simula la prueba de estrés de este repositorio. Reemplace “400 archivos PDF” con “400 transmisiones RTP” y las matemáticas serán idénticas: la misma inclinación, el mismo impuesto de relleno, el mismo acantilado OOM. MEC tiene GPU pequeñas. Los nodos Edge Compute de acceso múltiple en el nivel gNB/UPF no pueden jugar con 8 × bastidores H100. Obtienen un L4, tal vez un A10, tal vez un solo H100 si las compras estaban de buen humor. Obtener entre 2 y 6 veces más rendimiento de una GPU de un solo borde es la diferencia entre "funciones de IA disponibles en el borde" y "funciones de IA solo en el núcleo DC, más 30 ms de ida y vuelta adicionales". Esa brecha es exactamente donde las aplicaciones de clase URLLC viven o mueren. La telemetría OAM es la aplicación más aburrida. Contadores de PM, eventos de syslog, CDR, registros NetFlow/IPFIX, seguimientos de NF: estos son flujos de longitud variable de texto estructurado que se benefician enormemente del resumen basado en LLM, la detección de anomalías y la traducción de intenciones. También tienen una variación de longitud brutal: un seguimiento de llamada normal es de unos pocos cientos de tokens; un único seguimiento de fallo de transferencia 5G puede superar los 50.000. El procesamiento por lotes acolchado en esa distribución hará llorar a su grupo de inferencia, luego a su director de operaciones y luego a su director financiero.
Entonces, cuando veo una base de código que empaqueta FFD compatible con VRAM con alineación de mosaicos de hardware y una transferencia de memoria fijada por DMA única, no veo "optimización de GPU". Veo el análogo del lado de inferencia de un programador MAC. La razón por la que paso las tardes en esto no es un giro profesional: es el mismo trabajo, en silicio diferente, para la próxima generación de cargas de trabajo de telecomunicaciones que vivirán la mitad en el espectro y la otra mitad en la GPU.
Además, francamente, después de una década de leer las especificaciones 3GPP, una base de código desde la que puedes clonar todo el programador en 30 segundos son unas vacaciones.
8. La moraleja, si vinieras aquí por una.
Hay tres conclusiones que creo que se generalizan más allá de este repositorio específico:
1. El procesamiento por lotes predeterminado es una mentira educada. "batch_size = 8" no le dice nada sobre qué tan llena está su GPU. La unidad correcta son los tokens en VRAM y hay que medirlos porque ninguna biblioteca te dirá la verdad. El día que empiece a pensar en tokens por contenedor en lugar de artículos por lote, será el día en que su gráfico de rendimiento dejará de avergonzarlo.
2. El interesante trabajo escénico está en los límites. Las partes costosas de un proceso de LLM no son las multiplicaciones de la matriz: han sido optimizadas manualmente por los ingenieros de NVIDIA con hipotecas en juego. Las partes caras son las transiciones: tokens a tensores, host a dispositivo, Python a C++, programador a GPU. Casi todas las historias de "Espera, lo hice 2 veces más rápido" en el ML moderno son una historia de límites.
3. A veces la respuesta correcta es "escribir C++". No todo. Ni siquiera la mayor parte. Python puede coordinar absolutamente sistemas de inferencia de alto rendimiento; vLLM lo demuestra todos los días. Pero mover el bucle de empaquetado de ruta activa a un subproceso C++ en segundo plano elimina dos costos específicos del lado de Python que afectan la carga: la contención de GIL con el subproceso de ingesta y la sobrecarga del intérprete + asignador en un bucle de programación ajustado donde cada microsegundo es parte del presupuesto. La proporción correcta de Python/C++ para infraestructura de inferencia de alto rendimiento no es 100/0 o 0/100; es un límite PyBind11 delgado y bien definido con el programador de latencia crítica en el lado de C++ y todas las cosas interesantes (código de modelo, lógica de negocios, pegamento) en el lado de Python. WarpGroup es ~64% Python, ~30% C++, ~5% pegamento de construcción. Esa proporción no es un accidente.
9. ¿Adónde va esto ahora?
La hoja de ruta del repositorio insinúa el siguiente paso obvio: la fragmentación de múltiples GPU. Amplíe el despachador para administrar múltiples colas de C++ y distribuir contenedores de tamaño dinámico a través de interconexiones locales (NVLink/PCIe). La parte difícil no es C++: es decidir cómo equilibrar los tamaños de los contenedores entre dispositivos cuando las distribuciones de longitud de secuencia están sesgadas. (Se aceptan solicitudes de extracción, etc.)
Si quieres ser más nerd, las partes que me encantaría ver exploradas:
kPackWaitWindow adaptativo: esa ventana de acumulación de 5 ms es una constante ajustada manualmente. Probablemente quiera ser una función de la tasa de producción observada. Reserva de contenedor especulativa: fije previamente la memoria del host de un segundo contenedor para que podamos empaquetar el siguiente lote mientras el actual todavía está en el cable. Procesamiento por lotes continuo para la generación: en este momento se trata de un proceso de precarga/evaluación. Conectarlo a la decodificación de transmisión para un servidor de chat sería la extensión natural.
10. envolver
El relleno es el impuesto silencioso en cada carga de trabajo de LLM que toca texto de longitud variable. La contribución de WarpGroup-Backend no es un algoritmo nuevo (el empaquetado de contenedores FFD existe desde la década de 1970), es la integración de ingeniería: ajuste automático empírico de VRAM, envío asíncrono sin GIL, alineación de 16 tokens para los núcleos posteriores y una transferencia de memoria anclada de DMA único en el núcleo varlen de FlashAttention-2, todo pegado para que un solo python3 main_working_file.py produce un rendimiento de 2× a 6× en hardware real.
Si construye una infraestructura de inferencia LLM para ganarse la vida, clone el repositorio, lea los archivos C++ (tienen comentarios generosos y alguna que otra broma seca) y considere cuántas de sus propias canalizaciones están pagando actualmente el impuesto de relleno.
Si se gana la vida construyendo sistemas de telecomunicaciones y sospecha que la próxima década de su trabajo implicará muchos más servidores de inferencia de los que contrató originalmente, el mismo consejo. El programador MAC en su gNB y el empaquetador de contenedores en este repositorio leen el mismo libro de jugadas.
Si eres un principiante y solo quieres entender por qué las GPU odian el texto de longitud variable, felicitaciones, ahora conoces a más del 80 % de las personas que crean este material para ganarse la vida. Avanza y deja de acolchar cosas.
Acerca del repositorio
Si te gustó esto, las cosas más amables que puedes hacer son: ⭐ el repositorio, compartir esta publicación y decirle a un usuario de PyTorch en tu vida que su tamaño de lote le está mintiendo.
Ahora ve a gritarle a tu GPU. Cariñosamente.